Claude Code源码泄露揭示Harness Engineering核心范式
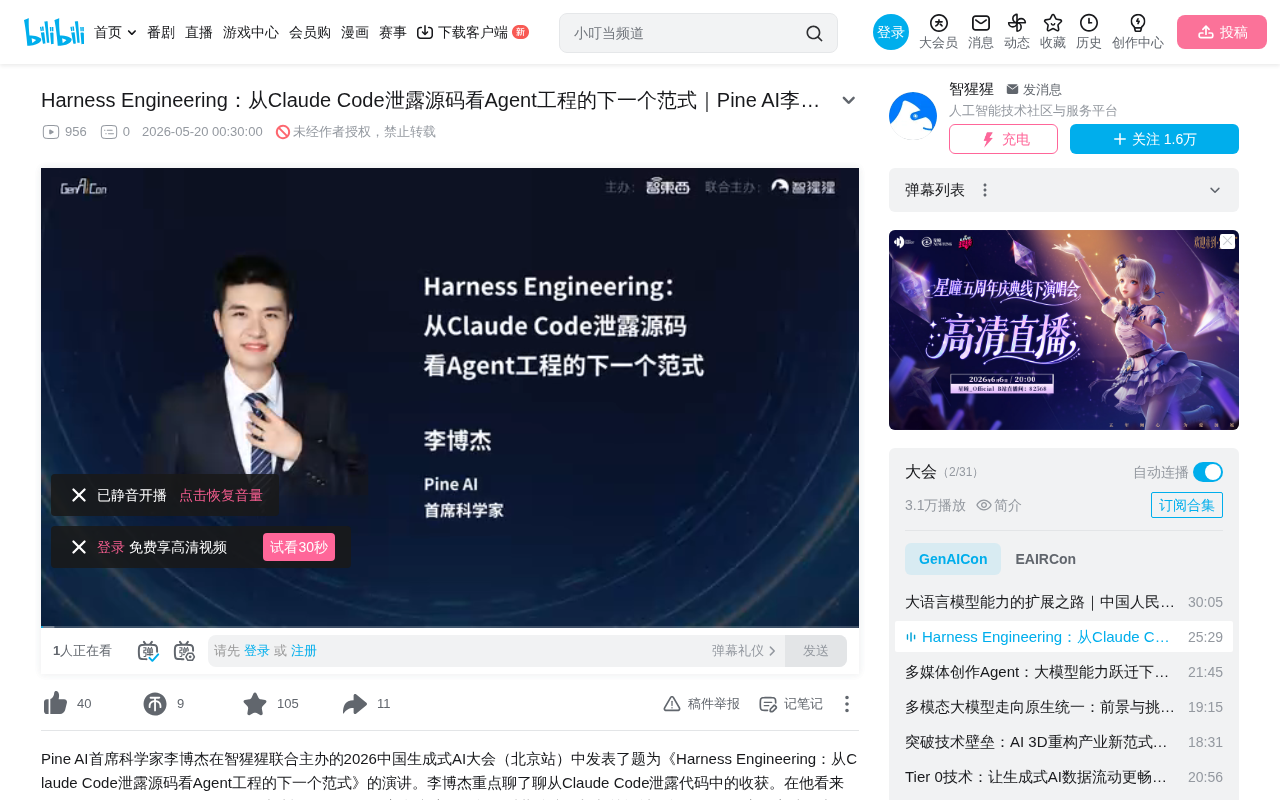
Claude Code源码揭示Harness Engineering如何决定Agent能力下限
通过Claude Code源码泄露事件,李博杰提出Harness Engineering概念,指出Agent能力由「Model × Harness」决定。对比Claude Code与开源OpenCode,前者在上下文管理(五层压缩管线)、记忆架构(Markdown替代向量数据库)、安全防御、错误恢复及Evaluation体系等方面远超后者。基座模型公司拥有数据飞轮优势,而长期竞争力将来自对Context的深度理解而非单纯模型能力。
引言:一次「有意为之」的源码泄露
近期Claude Code源码泄露事件引发了技术圈的广泛讨论。Pine AI创始人李博杰在GenAICon 2026演讲中指出,这次泄露很可能并非巧合——代码中包含大量注释、持续的Twitter话题热度,以及与下一代模型内部代号的「巧合」撞车,都暗示这可能是一次精心策划的技术营销。

但无论是否有意为之,将Claude Code的代码与开源的OpenCode进行对比分析,为我们揭示了一个重要概念——Harness Engineering,即模型之外的一切工程实践如何决定Agent的能力下限。
OpenCode vs Claude Code:架构差距解析
架构层面的根本差异
OpenCode是一个通用的Agent框架,由创始人在两个月内独立编写了几十万行代码。而Claude Code则经过一两年的商业化迭代,由工程团队基于大量用户反馈持续优化。
李博杰指出,在90%以上的场景中,使用相同模型(如OP4.7),OpenCode的效果都不如Claude Code。根本原因在于OpenCode在Harness层面缺少大量细节:
- 缺少错误恢复机制:模型不调工具就结束、输出中途卡死等问题无法自动处理
- 安全机制不完善:存在「致命三要素」风险(访问敏感信息+暴露于不受信任内容+自主执行危险操作)
- 记忆系统效果差:KV Cache不友好,Token浪费严重
OpenCode的独特价值
尽管如此,OpenCode在概念层面仍有其优势:
- 更像真人的交互体验,没有Session概念
- 通过自然语言安装和配置插件
- 推崇Skills+CLI模式,避免MCP工具过多导致模型变笨的问题
当工具数量超过1000个时,不仅占用大量Token,工具之间的平坦命名空间也会导致模型混乱。这是MCP方案的固有缺陷。
Agent发展的三个阶段:Prompt → Context → Harness
核心公式:Model × Harness = Agent
李博杰强调,这里用的是「乘法」而非「加法」。这意味着模型和Harness需要协同优化,而非简单叠加。
Agent的能力由三个层次决定:
- 模型:基本智力,决定能力天花板
- 上下文+工具(Observation Space + Action Space):决定能力上限
- Harness(约束、验证、纠正):决定能力下限
Claude Code的Harness工程实践详解
上下文管理:五层压缩管线
Claude Code在上下文管理上有几个关键设计:
Prompt Caching优先:所有架构决策都为缓存让路,这是性能优化的第一原则。
五层上下文压缩管线:对上下文进行分层压缩处理,而非简单截断。
Side Query机制:主Agent循环不是唯一调用LLM的地方。周围有大量小Agent负责权限分类、记忆检索、Session标题生成等辅助任务。
记忆架构:为什么不用向量数据库
Claude Code和OpenCode都采用了Markdown+文件系统的记忆方案,而非向量数据库。原因在于向量数据库存在根本性问题:
- 分布偏差:100条记忆中90条黑猫、10条白猫,Top-K检索可能全是黑猫
- 无法穷举:问「一共多少只猫」永远答不出来
- 缺乏结构化:单纯存储原始数据不够,必须经过压缩、总结、结构化整理
Claude Code通过「Dream」(睡眠学习)机制,定期扫描近期对话,对历史记忆进行修剪和总结。Markdown作为知识表达结构,在通用场景下比知识图谱更有效。
安全设计:多层防御体系
Claude Code的安全设计从架构之初就被考虑在内:
- 专门的权限校验小模型+规则系统
- 读取敏感信息前主动询问用户(除非使用
dangerously_skip_permissions) - 发送信息时审查是否包含敏感内容
- 不同SubAgent拥有不同的工具集合,基于角色限制能力范围
- 基于语义解析(而非关键词)的命令行安全检查
错误恢复:生产级Agent的必备能力
李博杰透露,Claude Code泄露后他很快将错误恢复机制移植到了自己的Agent中。常见的错误场景包括:
- 模型不调工具直接结束
- 供应商API卡死
- 输出超过最大Token限制(如8K)
- 输出中途崩溃后的断点续传
反蒸馏措施
Claude Code还包含了保护模型知识产权的设计:
- Fake Tools注入:API后端在响应中注入虚假工具调用,Claude Code执行时不受影响,但直接调用API的第三方会学到错误模式
- 加密签名(规划中):配合思维链摘要化,降低蒸馏价值
用做研究的方法做产品:Evaluation体系
Claude Code内部有完善的Evaluation体系,这是顶尖Agent公司与普通公司的关键差距。
具体做法包括:
- 内部设置ablation baseline的flag,每个技术方案都有竞争策略
- 通过AB测试选择最优方案(内部系统名为「Girlsbook」)
- 每天可发布几十版不同的Prompt
李博杰提到Manus也是Evaluation体系非常完善的公司,早在去年就已建立完善的测试用例和Prompt迭代系统。
基座模型公司的数据飞轮优势
在基座模型公司中,用户Bug会被分类处理:
- 部分问题统计后交给训练部门内化到模型
- 模型暂时搞不定的问题由Harness兜底
- 随着模型进化,Harness中的「屎山」逐渐减少
- 但更长horizon的任务又会产生新问题
这形成了一个持续优化的数据飞轮,也是First Party模型公司做Agent的天然优势。
AI时代的几个反共识观点
GUI的价值将逐渐降低
GUI本质是为人类有限注意力打的补丁。人类阅读和思考速度比Agent慢几十倍,强行让Agent使用GUI效率极低。Claude Code不做GUI的假设是「人不需要看代码」,从市占率来看这个判断正在被验证。
Context决定人的价值,而非智商
李博杰引用OpenAI翁嘉义的观点:「我在OpenAI做的工作好像也没那么难,换一个人也能干。」决定一个人能做什么的关键是Context——你能看到什么、经历过什么。
AI短期内无法替代人的三个原因:
- 需求背后有大量隐形约束
- 代码中的「坑」背后有历史原因(Claude Code代码中大量注释标注了case number)
- 每个人都有未表达的想法,AI没有读心术
最安全与最危险的人
头尾安全、腰部危险。三种有价值的角色:
- 电影导演型:从零到一的创造者
- 修屎山型:从一到百的架构师
- Research型:推极限的研究者
纯执行层的工作可能在3-5年内被淘汰。
结语
Model × Harness = Agent——这个公式的核心含义是,模型能力和工程实践必须协同进化。短期来看,Harness是应用层公司的技术杠杆;长期来看,护城河一定要建立在技术之外。随着Dansing Law(同等智力模型API成本每年下降一个数量级)的持续生效,真正的竞争力将来自对Context的深度理解和对用户需求的精准把握。
相关推荐
Meta Muse六天下载破90万:AI Agent时代正式来临
Meta Muse六天下载破90万:AI Agent时代正式来临
Meta旗下个人AI智能体Muse上线仅六天下载量突破90万,连续登顶美国App Store与Google Play双榜,超越ChatGPT、Claude等明星产品。本文深度解析Muse的核心能力、入口优势与AI Agent赛道的竞争格局。
 行业洞察
OpenAI内部Codex使用量暴增56倍,AI编程正在吞噬一切
OpenAI披露内部Codex使用数据:研究部门增长56倍,客户支持32倍,工程27倍,法务13倍。从技术到非技术部门,AI编程工具的渗透速度远超预期,揭示企业AI采用率正处于关键拐点。
 行业洞察
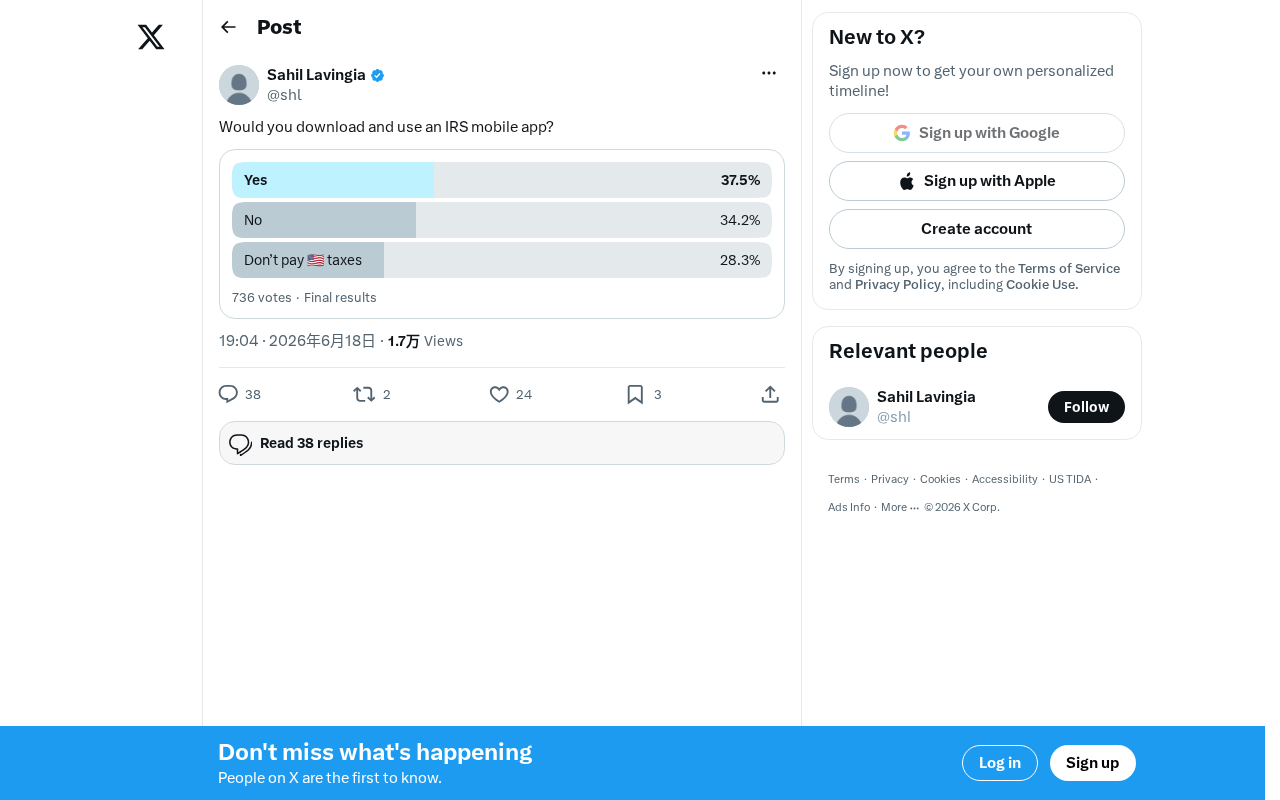
IRS移动App引发热议:政府数字化转型中的信任危机
美国国税局IRS拟推出移动App引发公众激烈讨论。本文分析支持者与反对者的核心论点,探讨数据安全、隐私保护与政府服务便利性之间的平衡,以及对政府数字化转型的深层启示。