从Figma到React:AI自动生成后台管理面板的实践观察
Claude Code将Figma设计稿自动转换为React后台面板,折射AI编程能力的当前边界。
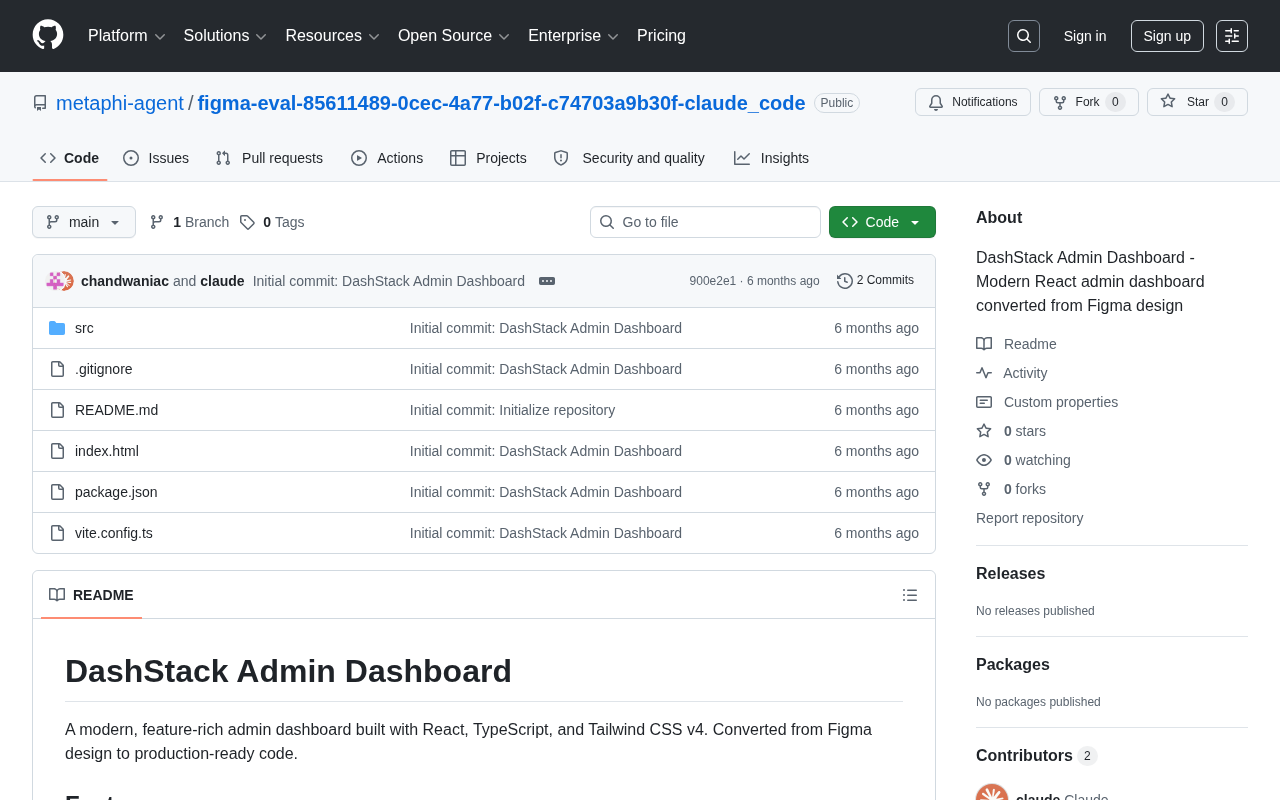
DashStack Admin Dashboard是GitHub上`figma-eval`系列仓库之一,由Claude Code将Figma设计稿自动转换为TypeScript + React后台管理面板。其哈希命名与`metaphi-agent`组织账号揭示出这是自动化评测流水线的批量产物,而非社区维护的成熟项目。后台管理面板因包含侧边栏、数据卡片、表格、图表等高度模式化UI元素,是评估「设计稿转代码」能力的理想测试对象。该仓库零Star、零Fork,不适合直接用于生产,但其价值在于验证AI自动生成标准化UI的可行性,并为开发者观察AI如何组织组件与类型定义提供一手样本。真正值得关注的,是这套自动化评测体系所揭示的AI编程能力边界,而非某个具体仓库本身。
一个由AI转换生成的后台管理项目
近期在GitHub上出现了一批以figma-eval为命名前缀的仓库,metaphi-agent/figma-eval-...-claude_code便是其中之一。这个名为 DashStack Admin Dashboard 的项目,定位十分明确:一套基于 React 的现代后台管理面板,其源头是一份 Figma 设计稿,并借助 Claude Code 完成从设计到代码的自动转换。
从仓库信息看,项目采用 TypeScript 编写,当前 Star 与 Fork 均为 0,属于典型的评测型(eval)产出。命名中的 figma-eval 和 claude_code 也透露出它的本质——这并非一个面向社区维护的成熟开源项目,而更像是一次「设计稿转代码」能力的自动化基准测试样本。
「Figma to Code」为何值得关注
将设计稿转换为可运行的前端代码,一直是前端工程中重复劳动最密集的环节之一。设计师在 Figma 中完成布局、配色与组件定义后,工程师往往需要手动还原每一处间距、字体和交互状态。这个过程既耗时,又容易在像素级还原上产生偏差。
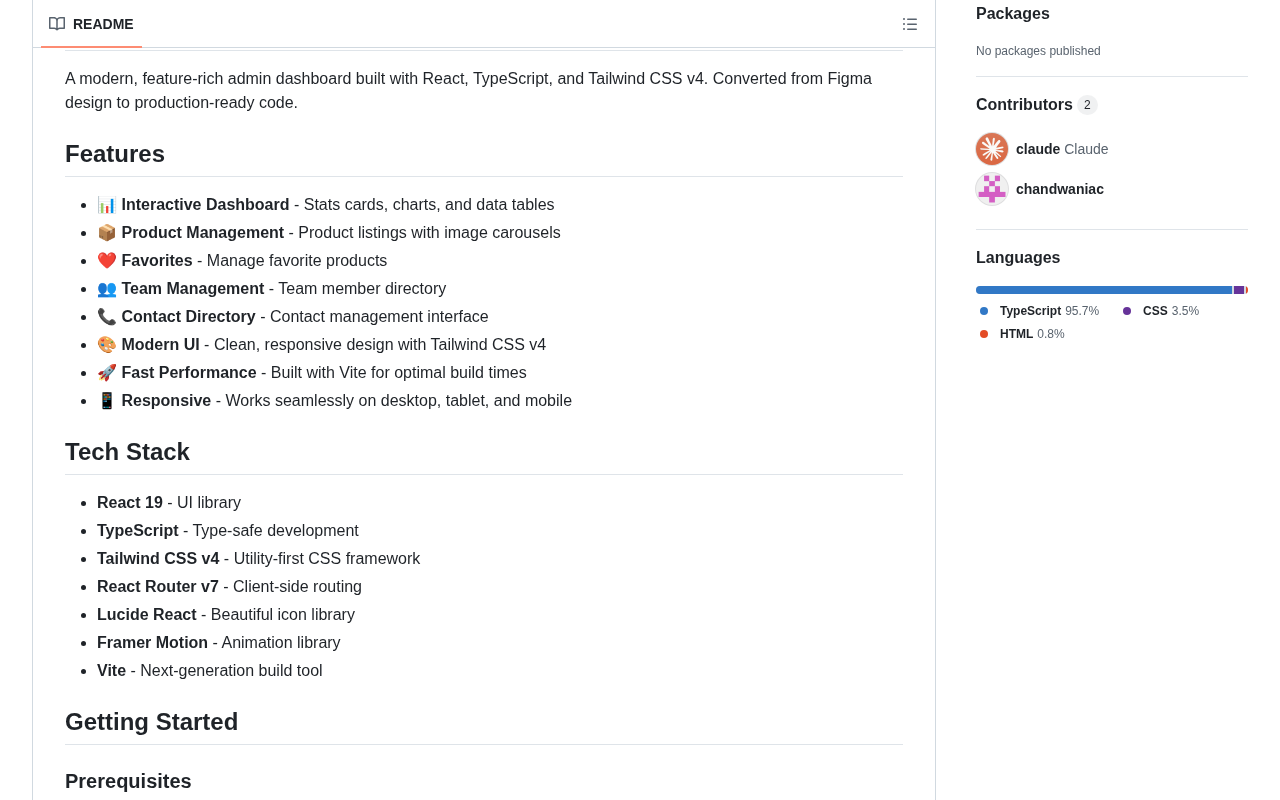
近年来,随着大模型代码能力的提升,Anthropic 的 Claude Code、以及各类 Agent 工具开始尝试打通这一链路:读取 Figma 的设计结构,直接输出结构化的 React + TypeScript 组件。DashStack 这类后台管理面板恰好是理想的测试对象——它包含侧边栏、数据卡片、表格、图表等高度模式化的 UI 元素,既有一定复杂度,又相对规整,便于评估 AI 转换的准确率与代码质量。
Claude Code 是 Anthropic 于2025年推出的 AI 编程工具,以命令行 Agent 形式运行,能够读取项目上下文、调用外部工具并执行多步骤编程任务。与传统代码补全工具不同,它可以接受高层指令(如「将这份设计稿转换为 React 组件」),自主拆解任务、生成文件、乃至运行测试——这使其成为实现「设计稿到代码」端到端自动化的可行路径。Figma 方面提供了官方 REST API 与插件生态,可将设计文件中的图层树、样式变量、组件约束等结构化信息导出为 JSON,AI Agent 即以此作为输入,将视觉意图映射为具体的 HTML/CSS/React 代码结构。
从命名规律看背后的评测体系
metaphi-agent 这一组织名,加上带哈希值的仓库命名(85611489-0cec-4a77-...),强烈暗示这是一套自动化流水线批量产出的结果。每一个哈希对应一次独立的转换任务,claude_code 后缀则标明了所使用的生成引擎。
这种组织方式在 AI Agent 评测中相当常见:通过让不同模型或工具处理同一批设计稿,再对比生成代码的可运行性、视觉还原度、代码可读性等维度,从而横向衡量各家「设计转代码」能力的高低。对于关注 AI 编程落地效果的开发者而言,这类仓库本身就是观察 AI 当前工程水平的一手样本。
这类评测体系在 AI 领域通常被称为「Benchmark」或「Eval Pipeline」。其核心逻辑是:固定输入(同一批 Figma 设计稿)、固定评估维度(视觉还原度、代码可运行性、可读性等),然后让不同的模型或 Agent 工具分别处理,最终通过量化指标横向对比。哈希命名的仓库便于脚本自动追踪每次任务的输入输出,避免人工命名带来的歧义。metaphi-agent 这类组织账号通常是评测平台的「机器人账号」,由流水线自动创建仓库、提交代码,整个过程无需人工介入。这种大规模自动化评测方式,正成为衡量 AI 编程工具实际落地能力的主流方法之一。
对开发者的实际参考价值
需要客观看待的是,这个仓库并不适合直接作为生产级项目使用。零 Star、零 Fork、纯评测导向,意味着它缺乏文档、测试覆盖与长期维护承诺。但它的价值在于「过程」而非「产物」:
- 验证可行性:它证明了后台面板这类标准化 UI 已经能被 AI 较好地自动生成;
- 代码参考:TypeScript + React 的产出结构,可供开发者观察 AI 如何组织组件与类型定义;
- 工作流启发:设计师与前端可借此思考如何将 Figma 规范化,以提升 AI 转换的成功率。
对于希望在真实项目中应用「Figma to React」工作流的团队,更务实的做法是把这类评测仓库当作能力上限的参照,而非现成模板。
小结
DashStack Admin Dashboard 本身是一个信息量有限的评测样本,但它折射出一个正在快速演进的趋势:AI 正在逐步接管前端开发中最机械的部分。从设计稿到可运行代码的距离,正被 Claude Code 这类工具持续压缩。真正值得跟踪的,不是某一个具体仓库,而是这背后整套自动化评测与生成体系所揭示的 AI 编程能力边界。
相关推荐

把NES模拟器炼进大模型:Qwen3.5-4B跑超级马里奥
开发者 Drew Breunig 将 NES 的 6502 CPU 模拟器炼入 Qwen3.5-4B 权重,做出开源项目 nesformer,可在模型内部缓慢运行超级马里奥 ROM。本文解析其灵感来源、Opus 5.5 提示词构建过程与一致性测试的复用,并讨论这一实验对模型能力边界的意义。

国泰航空数据泄露:5.3万订单暴露,AI供应链安全警钟
国泰航空确认第三方供应商Amadeus凭证泄露,导致5.3万条预订记录外泄。事件揭示AI管道中第三方数据供应链的深层风险:暴露数字可能只是下限,企业需回答两个硬问题——如何限制原始数据外流,以及能否快速溯源。

DeepSeek Harness零基础安装教程:临时与全局两种方式详解
零基础安装 DeepSeek Harness 完整指南:先装 Node.js 脚手架,再选临时安装或全局安装,附版本验证、启动命令与常见问题排查,帮你避开安装环节的坑。