从GitHub挖掘的1325个AI辅助编程仓库清单
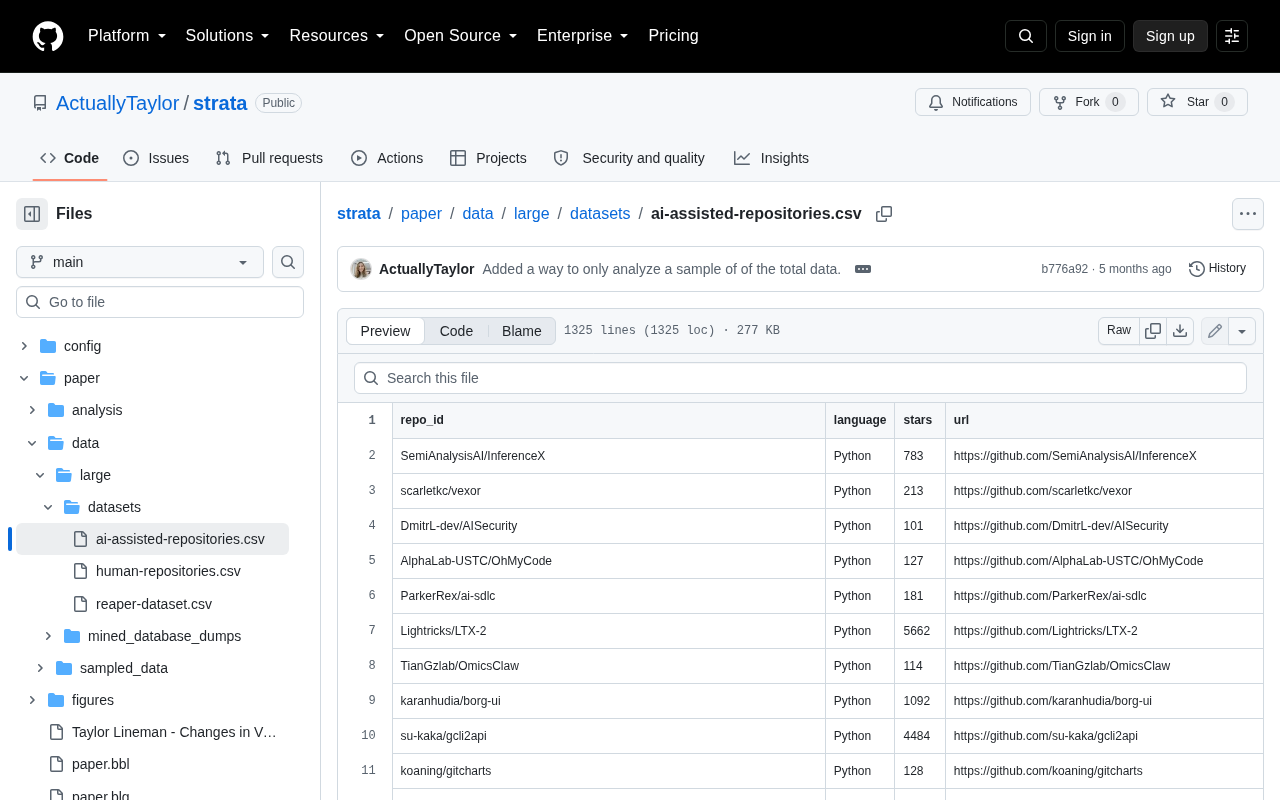
有人从GitHub整理出1325个AI辅助仓库清单,为观察AI编程渗透提供采样窗口,但存在显著识别偏差。
一位用户在Hacker News上分享了从GitHub挖掘整理的1325个AI辅助创建代码仓库清单,尝试以可量化方式观察GitHub Copilot、Cursor、Claude Code等AI编程工具在真实开源开发中的渗透程度。该数据集对研究者而言是分析AI编程实践的窗口,对普通开发者则是了解工具融入工作流方式的样本库。然而,这类挖掘清单存在显著的采样偏差——只有主动声明使用AI工具的仓库才能被识别,大量未作标注的AI辅助项目被排除在外,因此1325这一数字只是可识别仓库的下限。文章指出,该清单的核心价值在于提供某一时间点的采样切片,真正有意义的工作是在此基础上展开代码质量、维护成本、开源信任机制等维度的深度分析。
一份来自GitHub的AI辅助开发样本
Hacker News上出现了一个颇具研究价值的项目:有人从GitHub上挖掘并整理出1325个由AI辅助创建的代码仓库清单。这类项目之所以引人关注,是因为它试图用可量化的方式回答一个正在被广泛讨论的问题——AI编程工具究竟在多大程度上渗透进了真实的开源开发中。
随着GitHub Copilot、Cursor、Claude Code等工具的普及,越来越多的代码提交、注释乃至完整项目开始带有AI辅助的痕迹。将这些仓库系统性地识别、汇总成一份清单,本身就是对当前开发生态的一次快照式采样。
GitHub Copilot是微软与OpenAI合作推出的AI代码补全工具,直接集成于编辑器中,通过分析上下文自动补全代码片段乃至整个函数。Cursor是一款以AI为核心的代码编辑器,允许开发者以自然语言对话的方式生成、重构代码。Claude Code则是Anthropic推出的命令行AI编程助手,可在终端环境中完成代码生成与项目级修改。这三类工具代表了AI编程辅助的不同形态:插件式补全、AI原生IDE、以及基于对话的命令行交互。它们的共同点是将大语言模型(LLM)嵌入日常编程流程,但在使用痕迹上有所不同——有些工具会在提交信息或配置文件中留下可识别的元数据,有些则几乎无迹可查,这直接影响了自动化挖掘的覆盖范围。
这类清单的价值在哪里
单纯罗列仓库看似简单,但背后的挖掘逻辑值得深究。要从GitHub海量仓库中筛选出「AI辅助」的项目,通常需要依赖一些可识别的信号:提交信息中提及的工具名称、README里对AI协作的说明、特定的代码注释模式,或是与AI工具关联的元数据。
对于研究者而言,这样一份数据集提供了观察AI编程实践的窗口。可以借此分析:哪些语言和领域更倾向于采用AI辅助?这些项目的活跃度、代码质量与传统项目相比有何差异?AI辅助是否改变了开源贡献的模式?
对于普通开发者,这份清单则是一个学习样本库。通过浏览这些项目,可以直观感受当下开发者是如何将AI工具融入实际工作流的,从中借鉴组织结构、提示词使用方式或协作模式。
采样偏差与识别边界
需要冷静看待的是,这类挖掘清单存在天然的局限。「AI辅助」的定义本身就相当模糊——一个仅用Copilot补全过几行代码的项目,和一个完全由AI生成的项目,在辅助程度上有本质区别,但可能都被归入同一份清单。
更关键的是识别偏差。能被挖掘出来的,往往是那些主动声明使用了AI工具的仓库。而现实中大量使用AI辅助却未作任何标注的项目,无法被这套方法捕捉。因此1325这个数字更应被理解为「可识别的AI辅助仓库的下限」,而非全貌。
此外,GitHub上AI辅助项目的实际数量增长极快,任何静态清单都会迅速过时。这份数据的意义更多在于提供某个时间点的采样切片,而非持续追踪的权威统计。
这里的识别偏差在统计学上属于「选择性偏差」(Selection Bias)的一种典型形式:样本并非从总体中随机抽取,而是由可被观测的特征决定的。在AI辅助仓库识别中,「是否主动标注」成为进入样本的门槛,而主动标注本身又与开发者的习惯、社区文化、工具的默认行为强相关。例如,Cursor的某些版本会在README模板中自动插入声明,使用该工具的项目更容易被识别;而直接调用OpenAI API自行搭建辅助流程的开发者,则几乎不会留下任何标准化信号。这种偏差的存在意味着,该数据集在语言分布、项目类型、开发者背景上可能与真实的AI辅助开发全貌存在系统性偏离,使用时需特别谨慎。
对开源生态的启示
这个项目折射出一个更深层的趋势:AI辅助开发正在从边缘走向主流,以至于有人认为值得专门为其建立索引和数据集。当「是否使用AI」逐渐成为描述一个项目的标签维度之一,说明开发范式确实在发生迁移。
从社区讨论热度来看,该帖子在Hacker News上的互动量并不高,反映出这类纯数据整理型项目虽有价值,但尚未触及广泛共鸣的痛点。真正能引发讨论的,往往是围绕这些数据展开的深度分析——比如AI辅助项目的代码质量对比、维护成本变化,或对开源信任机制的影响。
对关注AI编程演进的人来说,这份清单是一个不错的起点素材。它本身不提供结论,但为后续的量化研究铺设了基础。如何用好这样的原始数据,比数据本身更值得思考。
相关推荐
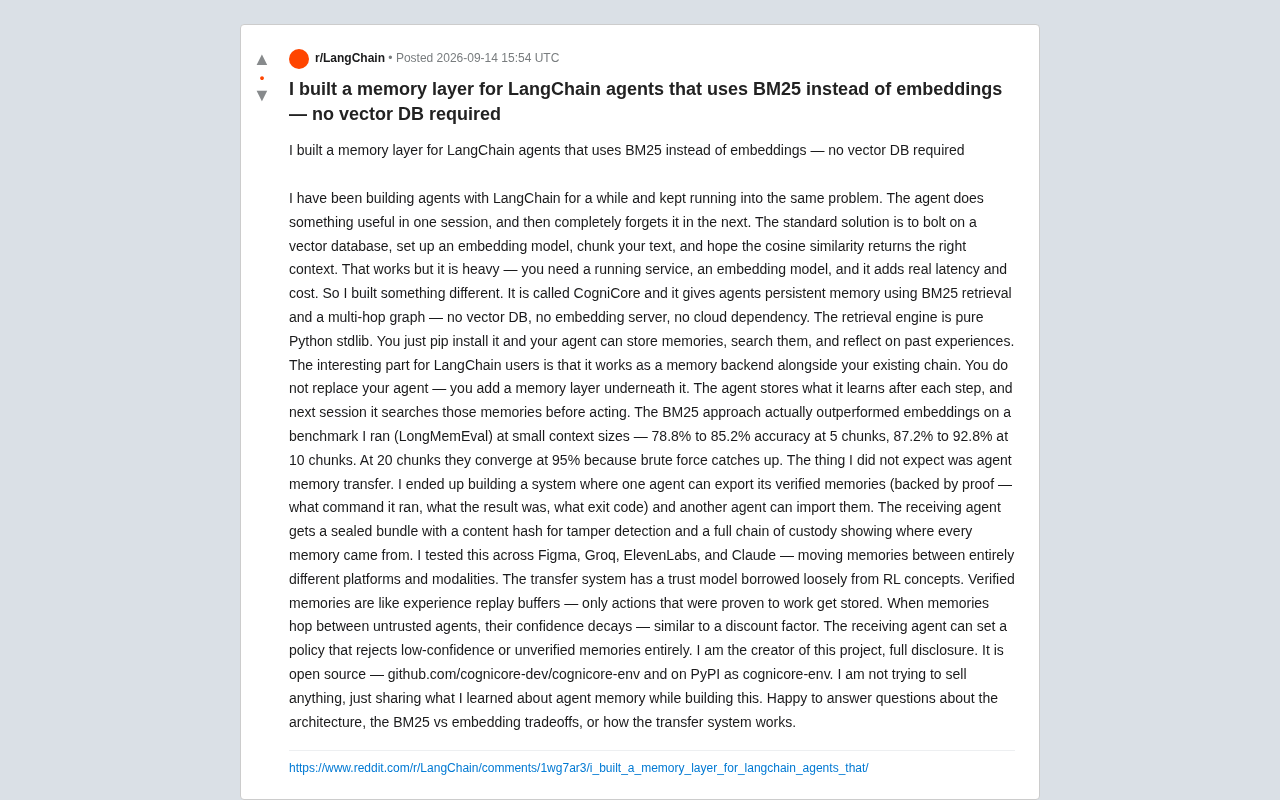
抛弃向量数据库:用BM25为LangChain智能体构建记忆层
一位开源开发者构建了 CogniCore——用 BM25 检索替代嵌入向量、无需向量数据库的 LangChain 智能体记忆层,并在 LongMemEval 基准上小上下文场景反超嵌入方案,还实现了跨平台智能体记忆迁移。
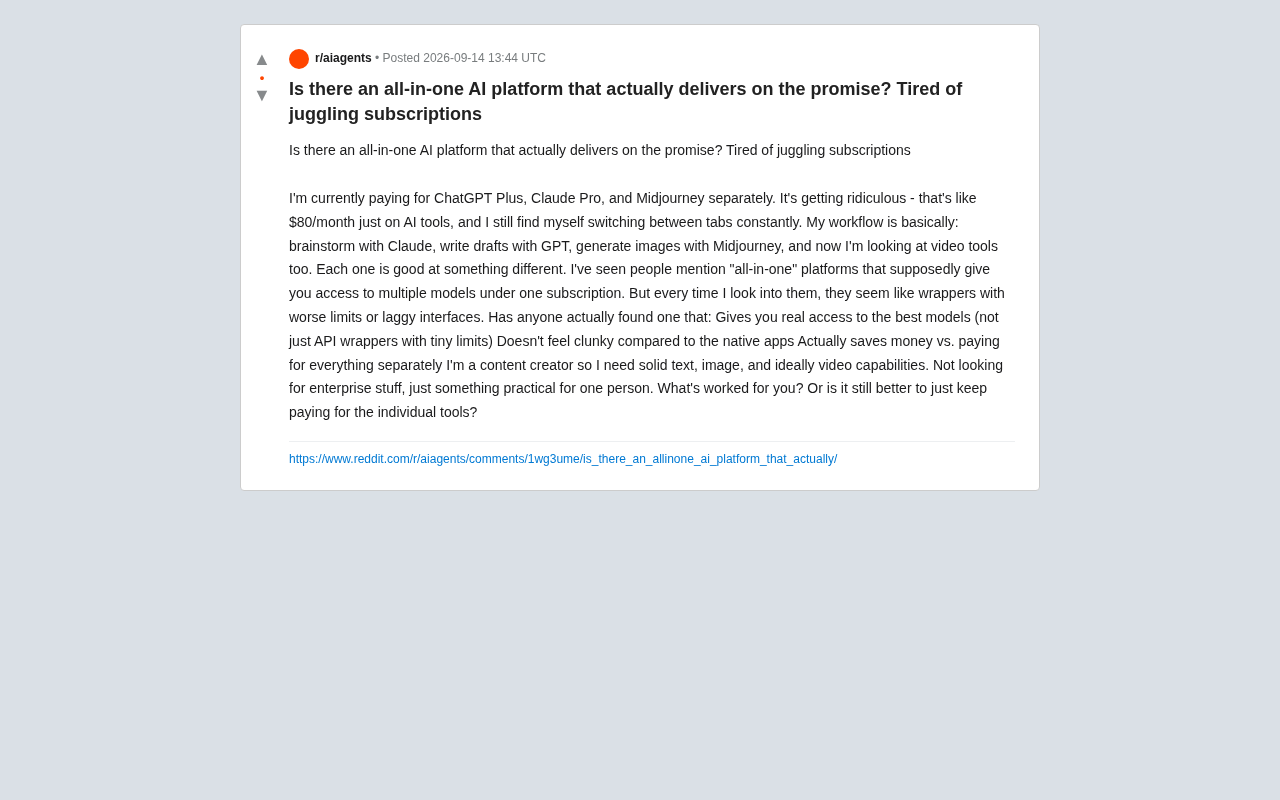
一体化AI平台真的靠谱吗?告别多订阅困境的实用指南
内容创作者厌倦了同时订阅ChatGPT、Claude和Midjourney。一体化AI平台真能省钱又好用吗?本文分析聚合平台的真实权衡,并给出实用的工具组合建议。
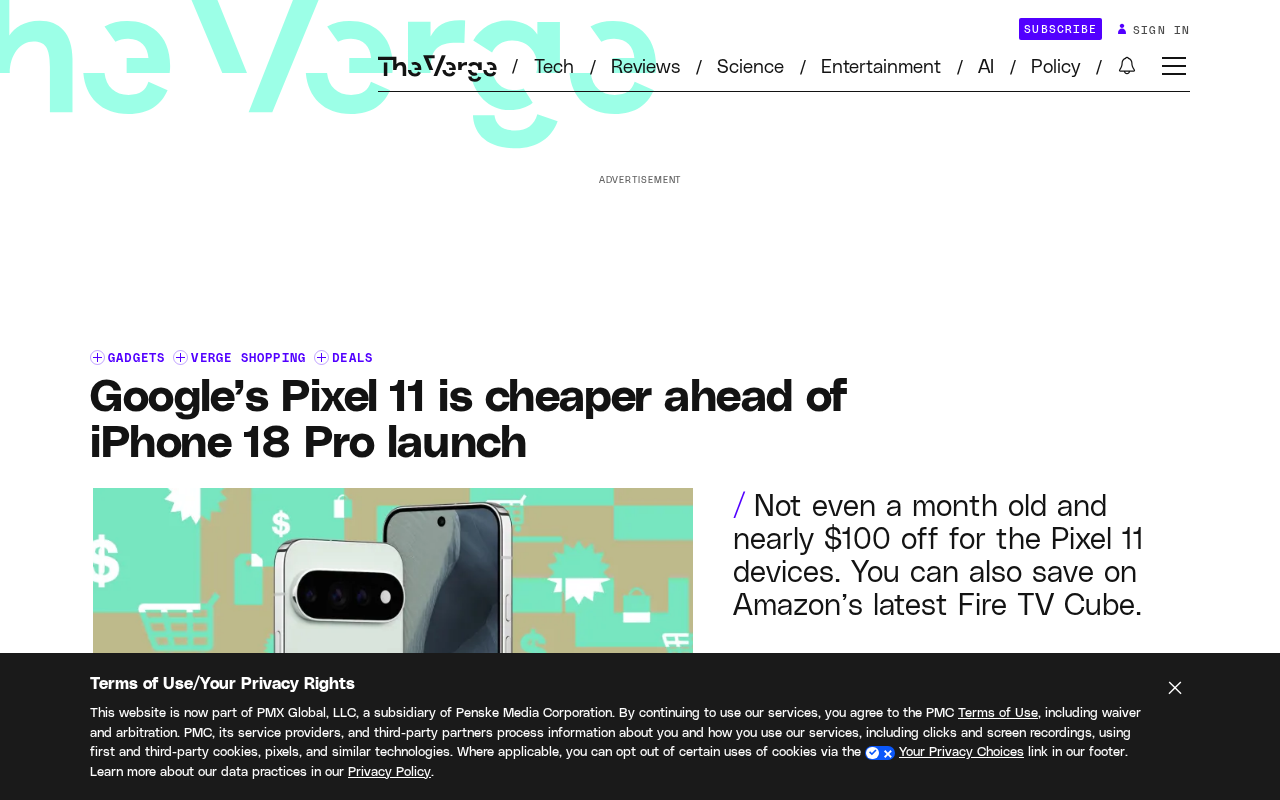
iPhone 18 Pro发布前,谷歌Pixel 11降价抢市场
苹果iPhone 18 Pro将于9月18日发售,谷歌抢先为Pixel 11系列降价。Pixel 11 Pro亚马逊售价约1007美元,几乎抵消了今年100美元的涨幅。本文解析这场发布前价格战的市场逻辑与消费者影响。