从记账到报表:如何构建一个真正有用的AI代理
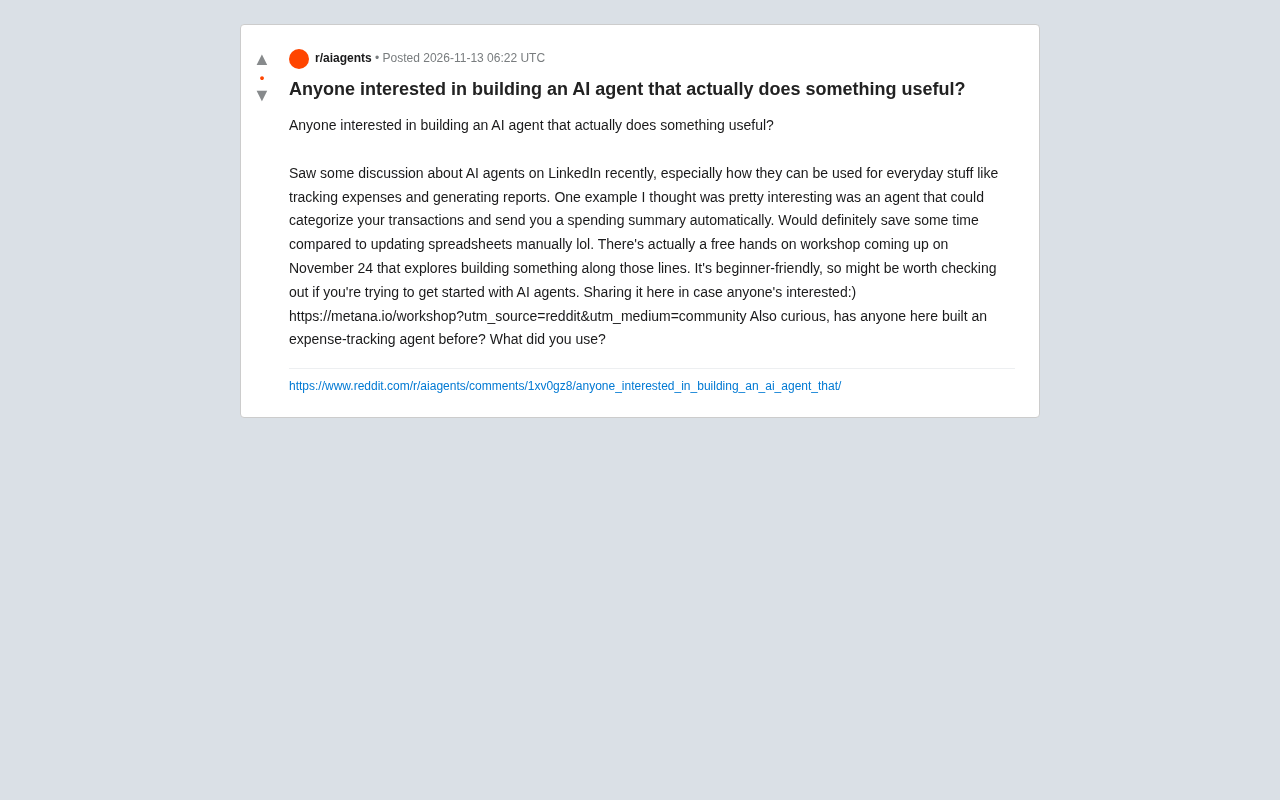
实用AI代理应聚焦闭环日常任务,以记账代理为例拆解构建关键环节。
文章从Reddit讨论出发,指出大多数AI代理Demo停留在聊天层面,而真正有价值的是能替人完成重复性日常任务的代理,如自动分类交易并生成支出报告。文章以记账代理为例,详细拆解了数据获取、交易分类、自动化触发和输出呈现四个关键环节,并讨论了规则引擎与大模型结合的混合分类策略、技术栈选择(从Python脚本到LangChain等框架)以及社区常见的坑(CSV格式混乱、商户分类不稳定)。最后给出从零开始构建第一个实用代理的步骤,强调动手实践和闭环自动化的重要性。
为什么大多数AI代理毫无用处?
在LinkedIn和Reddit上,关于AI代理的讨论越来越多,但大多数Demo都停留在“能聊天”的层面——查天气、讲笑话、复述百科。真正能帮用户省时省力的代理却很少见。最近Reddit上有一条帖子引发了共鸣:一位用户提到,他在LinkedIn看到有人用AI代理自动分类交易并生成支出报告,这比手动更新电子表格要高效得多。这个案例点出了AI代理的核心价值:替人完成重复性、规则明确、但耗时费力的日常任务。
这条帖子还分享了一个免费动手工作坊,主题正是构建这类实用代理,面向初学者。发帖人同时抛出一个问题:有没有人真正搭建过记账代理?用了什么技术栈?这个问题值得深入拆解——因为一个能用的记账代理,涉及数据获取、分类逻辑、自动化和输出呈现四个环节,每一环都有坑。
构建记账代理的四个关键环节
1. 数据获取:从银行到CSV
记账代理的第一步是拿到交易数据。大多数银行不提供开放的实时API,所以常见做法是定期导出CSV文件,或者使用第三方聚合服务(如Plaid)读取账户信息。对于个人项目,手动上传CSV是最现实的起点。代理需要能够解析不同银行导出的格式,处理日期、金额、商户名称和备注字段。这一步的难点在于格式不统一,需要写一些适配逻辑。
Plaid 是一家提供金融数据聚合 API 的第三方服务,开发者通过它可以在用户授权的前提下,安全地读取银行账户、交易记录和余额信息。它的工作原理是:用户通过 Plaid 的界面登录自己的银行账户,Plaid 与银行建立连接后,将标准化的交易数据通过 API 返回给开发者。相比手动导出 CSV,Plaid 能提供更实时、格式统一的数据流,但需要注册开发者账号、遵守合规要求,并且对个人项目可能产生费用。对于追求自动化闭环的记账代理,Plaid 这类聚合服务可以省去解析各种银行 CSV 的麻烦,是迈向“全自动”的关键一步。
2. 交易分类:规则引擎还是大模型?
分类是记账代理的核心。商户名称往往很模糊,比如“AMZN Mktp”或“SQ *COFFEE”。传统做法是用关键词匹配规则,但覆盖面有限。引入大语言模型后,代理可以根据商户名称和金额推断类别,比如把“SQ *COFFEE”归入“餐饮”。不过大模型推理有成本,对于高频交易,可以结合规则引擎先做粗筛,再让模型处理模糊项。Reddit帖子中提到的代理正是自动分类并生成摘要,这种混合策略在实际项目中最常见。
规则引擎 是一种基于预定义条件(如关键词、金额范围、正则表达式)来执行分类决策的系统。在记账场景中,规则引擎可以快速将包含“STARBUCKS”的商户名归为“餐饮”,或将金额大于 1000 的交易标记为“大额”。它的优点是速度快、成本低、结果可解释,但缺点是需要人工维护规则库,且难以覆盖模糊或新出现的商户名。将规则引擎与大语言模型结合,可以先用规则处理明确案例,再将剩余模糊项交给模型推断,从而在准确性和成本之间取得平衡。
3. 自动化触发:定时还是事件驱动?
一个真正省心的代理应该自动运行,而不是每次手动点击。可以用cron定时任务,每周或每月处理一次新数据;也可以监听邮件或云盘文件夹,一旦有新CSV就触发。初学者可以从定时任务开始,简单可靠。如果代理需要发送支出摘要邮件,还需要集成SMTP或邮件API。
4. 输出呈现:摘要与可视化
生成报告是代理的最终输出。除了文本摘要(如“本月餐饮支出较上月增长”),加入简单的柱状图或饼图能更直观。需要注意的是,摘要要基于分类结果做聚合,避免逐笔罗列。Reddit用户提到的“自动发送支出摘要”就是这一环,技术上可以用Python的pandas做聚合,再用matplotlib生成图表,最后拼接成HTML邮件。
技术栈选择:从零开始还是用框架?
帖子里问“你们用了什么”,这其实取决于目标。如果只想快速验证,可以用Python脚本加上OpenAI API,配合pandas和schedule库,几十行代码就能跑通。如果要做得更健壮,可以考虑LangChain或LlamaIndex等代理框架,它们提供了工具调用和记忆机制,方便扩展。但框架也带来学习成本,对于记账这种线性任务,直接写脚本可能更透明。
工作坊的信息显示,它面向初学者,且是动手形式。这意味着参与者可能会用低代码或简单Python来搭建代理原型。对于想入门的人来说,这类实践比看理论文章更有价值,因为能亲手处理数据、调试分类逻辑、看到最终报告。
LangChain 和 LlamaIndex 是当前流行的两个大语言模型应用开发框架。LangChain 提供了工具调用、记忆管理、代理循环等抽象,方便开发者将大模型与外部数据源、API 连接起来;LlamaIndex 则更侧重于数据索引和检索增强生成(RAG),适合需要从文档中提取信息的场景。对于记账代理这类线性任务,使用框架可以快速获得工具调用和状态管理能力,但也引入了额外的抽象层和学习成本。如果任务流程简单明确,直接编写 Python 脚本往往更透明、更易于调试。
社区经验:别人的坑与收获
Reddit帖子下的讨论虽然不多,但发帖人主动询问经验,说明社区里有人尝试过。从公开的开发者分享来看,常见问题包括:银行CSV编码混乱导致解析失败、商户名称缩写难以归类、大模型分类结果不稳定(同样的商户有时归入不同类别)。解决办法包括:维护一个商户到类别的映射表,对模型输出做后处理校验,以及设置人工复核环节。
另一个值得关注的趋势是,越来越多教程强调“代理要能闭环”——从数据输入到动作输出(如发邮件、更新表格)完全自动,而不是中间需要人点一下。这恰恰是“真正有用”的分水岭。
商户到类别的映射表 是一种人工维护的字典结构,将常见的商户名称缩写(如“AMZN Mktp”映射为“购物”)直接对应到固定类别。在记账代理中,映射表可以作为分类的第一道防线,覆盖高频且明确的商户,减少对大模型的调用次数。映射表需要定期更新,以应对新商户的出现,也可以结合社区共享的映射库来降低维护成本。对于大模型分类不稳定的问题,映射表能提供确定性的回退方案,确保关键交易始终被正确归类。
如何开始你的第一个实用代理
如果你对构建记账代理感兴趣,可以按照以下步骤启动:
- 准备数据:从银行导出最近三个月的CSV,观察字段结构。
- 写解析脚本:用pandas读取CSV,统一日期和金额格式。
- 尝试分类:先用关键词规则分类,再对未匹配项调用大模型。
- 生成摘要:按类别聚合,输出文字摘要和简单图表。
- 设置定时任务:用cron或schedule每周运行一次。
- 迭代优化:根据错误分类调整规则或提示词。
工作坊提供了一个结构化的入门路径,但即使不参加,按照上述步骤也能做出可用的原型。关键在于动手,而不是停留在讨论。
结语:实用主义胜过炫技
AI代理的价值不在于能聊多少轮,而在于能否替用户完成一件具体的事。记账代理是一个很好的切入点:需求真实、逻辑清晰、反馈直接。Reddit上的这条帖子虽然简短,却指向了一个被忽视的方向——构建能闭环的日常任务代理。如果你也想尝试,不妨从下一次银行账单开始。
相关推荐

美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
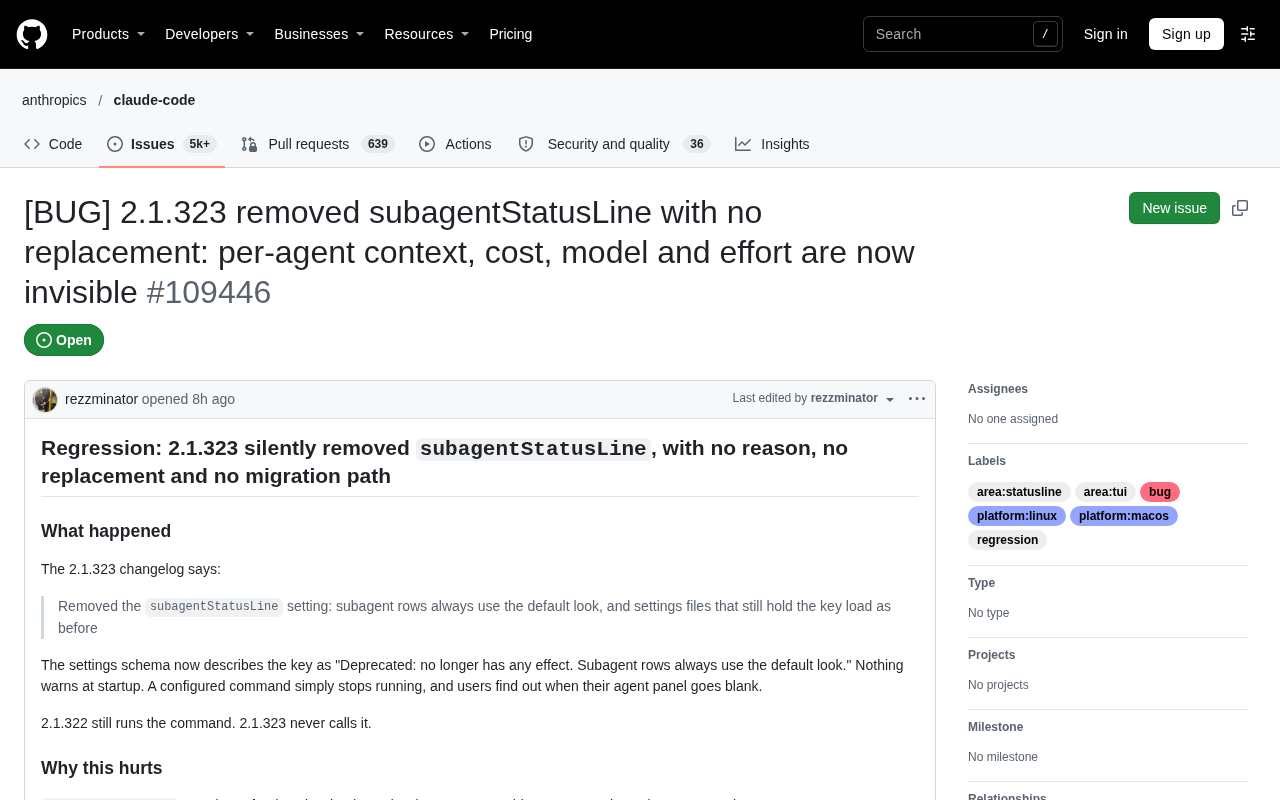
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
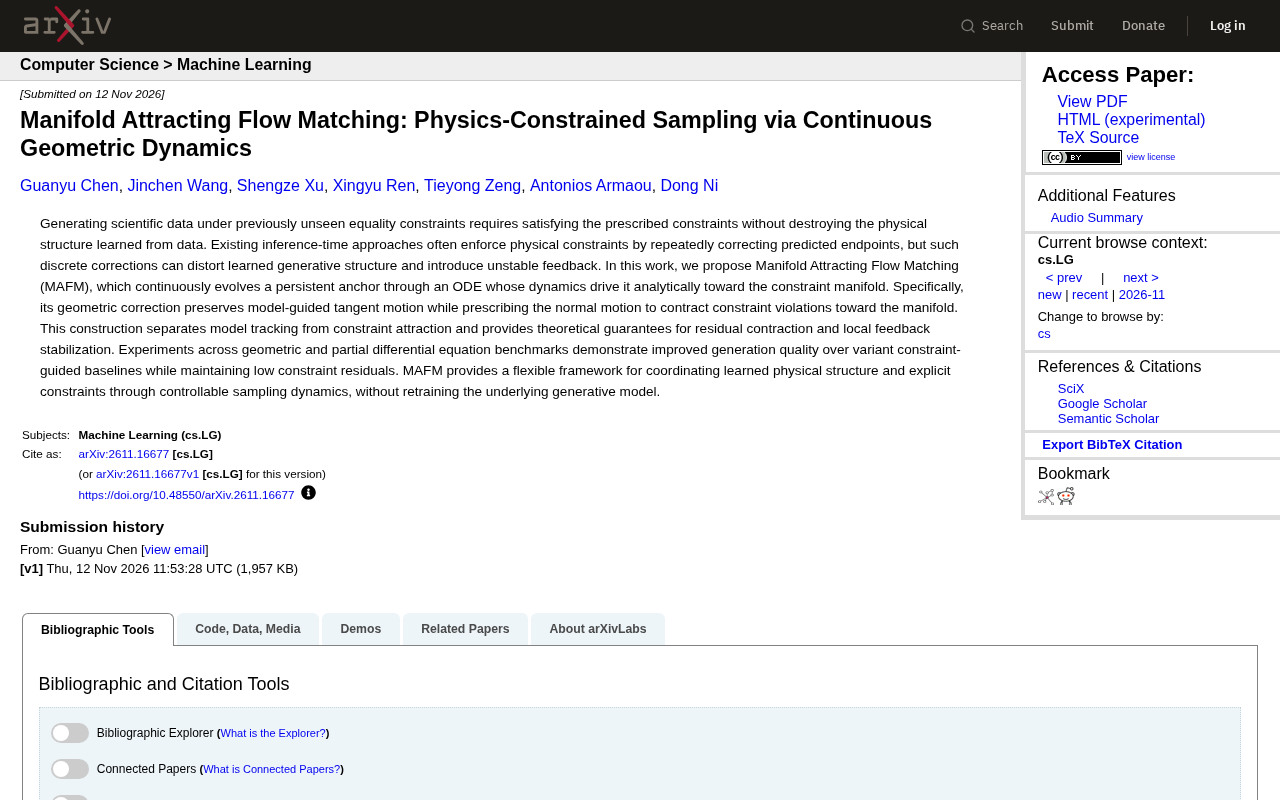
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。