从矩阵代数到JAX:手搓神经网络理解深度学习本质

开发者用NumPy和JAX手写神经网络,通过四个渐进模型深入理解内部数学。
一位开发者为了真正理解神经网络内部运算,放弃直接调包,用NumPy手写前向传播、反向传播和梯度下降,并采用矩阵形式Z=WX+bC简化推导。他构建了四个逐步升级的模型:从NumPy+MSE的92%准确率,到交叉熵+Softmax的96%,再到借助JAX自动微分尝试更深网络,最后用动量法mini-batch将收敛所需epoch从2000降至200。整个过程强调数学理解而非刷分,并给出了从线性代数起步、亲手实现优化器的学习路线。项目已开源为Neural Canvas交互式可视化网页。
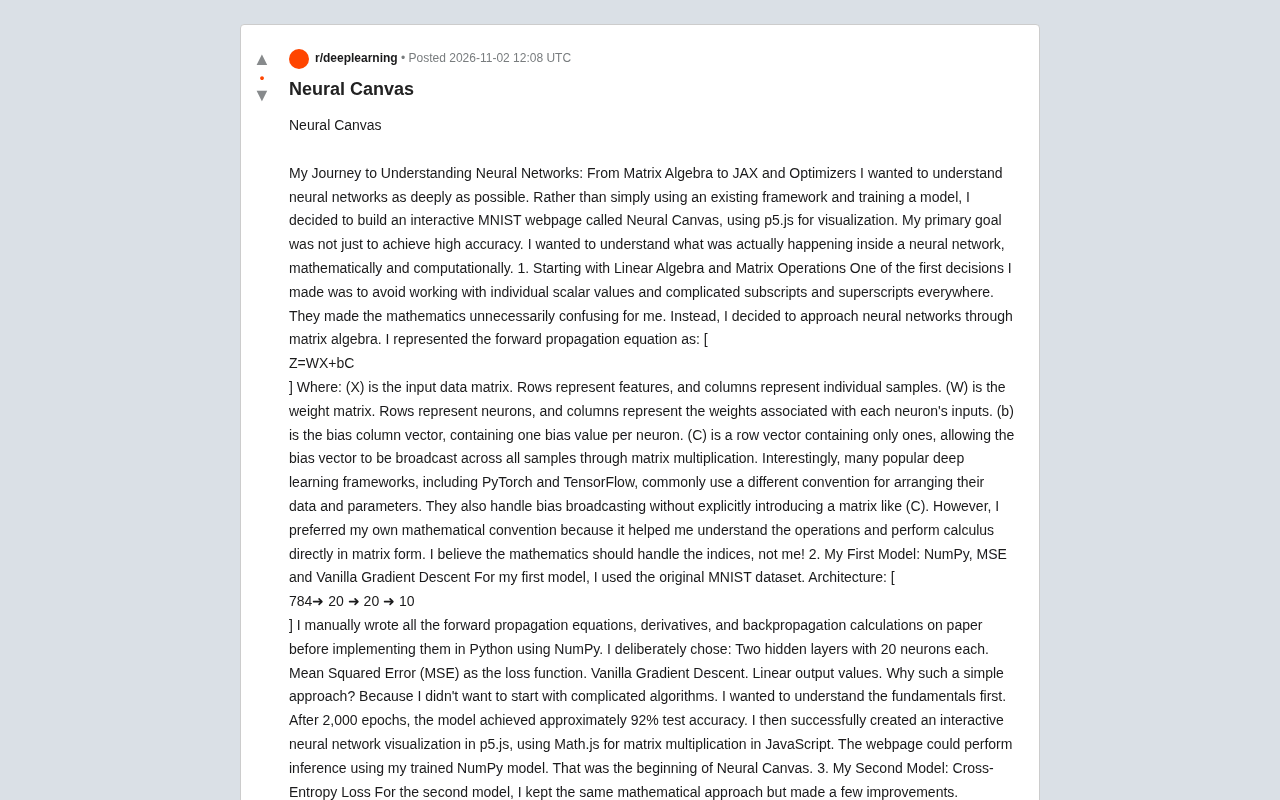
多数人学习神经网络是从调包开始的:model.fit()一跑,准确率上去就算完事。但Reddit上一位开发者走了另一条路——他叫MuhammadEssa,用NumPy手写前向传播、反向传播和梯度下降,再用JAX重写,最后做出了一个叫Neural Canvas的交互式MNIST可视化网页。整个过程的核心动机不是刷高准确率,而是搞清楚网络内部到底在算什么。
用矩阵代数重新表述前向传播
这位开发者做的第一个决定是抛弃标量写法。传统教程里满屏的$w_{ij}^{(l)}$、$b_j^{(l)}$让他觉得数学被下标淹没了。他改用矩阵形式表达前向传播:Z = WX + bC,其中X的每一列是一个样本,W的每一行对应一个神经元,b是偏置列向量,C是全1行向量,通过矩阵乘法把偏置广播到所有样本上。
他特别指出,PyTorch和TensorFlow的惯例与他不同——它们通常把样本放在行方向,且偏置广播由框架隐式处理,不需要显式构造C矩阵。但他坚持自己的约定,理由很实在:这种排列让他能直接在矩阵形式上做微积分推导,不用手动追踪每个下标。用他的话说,“数学应该处理下标,而不是我”。
这个选择本身反映了一个学习策略:与其迁就框架的默认习惯,不如选一个自己推导起来最顺手的数学约定,等理解透了再去适应工程惯例。
矩阵微积分(Matrix Calculus) 是这里的关键工具。传统上,网络梯度通过标量链式法则逐元素推导,但当参数以矩阵形式组织时,直接对矩阵求导可以保持表达式简洁。例如,若损失函数为标量L,且Z = WX + bC,则∂L/∂W = (∂L/∂Z) · Xᵀ 的形式,其中偏置的梯度需要对所有样本求和。这种“矩阵对矩阵”的求导规则(常借助分母布局或分子布局)让反向传播的推导不再被下标淹没。作者坚持样本按列排列、偏置用全1行向量广播,正是为了让这些梯度公式在纸上也能一行写完,从而把注意力集中在链式法则的结构上,而非索引的搬运。
四个模型,一条逐步加码的学习路径
第一模型:NumPy + MSE + 朴素梯度下降
他用原始MNIST数据集搭了一个784→20→20→10的网络,在纸上手推所有前向传播方程、导数和反向传播,然后用NumPy实现。损失函数选均方误差(MSE),优化器用最朴素的梯度下降,输出层不加激活函数。训练2000个epoch后测试准确率约92%。
这个阶段的重点不在性能,而在于验证自己对链式法则的理解是否正确。随后他用p5.js和Math.js做了网页端的推理可视化,Neural Canvas的雏形就是这么来的。
第二模型:换成交叉熵损失
架构扩到784→40→40→10,MSE换成交叉熵,输出层加softmax,优化器仍然是朴素梯度下降。2000个epoch后准确率约96%。到这里,他开始感觉自己是在理解网络,而不是在跟着教程抄代码。
交叉熵损失与Softmax 的组合是分类任务的标准配置。Softmax将网络输出转换为概率分布:对每个样本,先对logits取指数再归一化,使各类别概率之和为1。交叉熵则衡量预测分布与真实one-hot标签之间的差异,其形式为 -Σ yᵢ log(ŷᵢ)。相比MSE,交叉熵对错误预测的惩罚更陡峭,且与Softmax结合时梯度形式非常简洁:∂L/∂z = ŷ - y,这避免了MSE在输出层饱和时梯度消失的问题。作者在第二个模型中引入这一组合,不仅提升了准确率,也让反向传播的推导更清晰——输出层的误差直接就是预测概率与真实标签之差。
第三模型:JAX接管自动微分
想试三个隐藏层时,他遇到了现实问题:手动推导每一层的导数和链式法则太耗时。于是他转向了Google开发的JAX,用它的自动微分功能直接计算损失函数对参数的梯度,包括整个权重矩阵。
模型用Arabic Digits MNIST数据集,架构为784→20→20→15→10,交叉熵损失加朴素梯度下降,2000个epoch后准确率约96%。他的原话是“真的爱上了JAX”——省下的推导时间让他能专注于数学理解和架构实验。
JAX的自动微分 基于函数式编程范式,通过 jax.grad 对纯函数进行变换,返回其梯度函数。它支持前向模式和反向模式自动微分,对于神经网络这种标量损失对大量参数的梯度,反向模式(即反向传播)是高效选择。JAX的独特之处在于它使用 jit 编译和 vmap 自动向量化,能透明地将梯度计算扩展到整个参数矩阵,而无需手动编写循环。与PyTorch的动态图不同,JAX要求函数无副作用,这使得梯度计算更可预测。作者用JAX替代手工链式法则后,可以轻松尝试三层隐藏层,因为无论网络多深,jax.grad 都能自动给出正确的梯度,省去了逐层推导的繁琐。
第四模型:动量法带来的效率跃升
第四个模型换用Persian Digits MNIST数据集,架构与第三个相同。原计划直接上Adam,但他意识到理解Adam需要先搞懂几个前置概念,于是退一步先实现带动量的 mini-batch 梯度下降,用JAX完成。
结果出乎意料:约200个epoch就达到约96%的测试准确率,而此前达到相近水平需要约2000个epoch。这个对比让他直观感受到优化算法对训练效率的影响有多大——在他的实验条件下,收敛速度提升了一个数量级。
动量法(Momentum) 是对朴素梯度下降的改进,旨在加速收敛并抑制震荡。它引入一个速度变量v,累积历史梯度:v = βv + (1-β)∇θL,然后参数更新为θ = θ - αv,其中β通常取0.9。直观上,动量让参数在梯度方向一致的维度上加速,在梯度方向反复变化的维度上减速,从而更快穿越平坦区域和狭长谷底。结合mini-batch(每次用小批量样本估计梯度),训练既稳定又高效。作者观察到收敛速度提升一个数量级,正是因为动量有效利用了梯度的历史信息,而mini-batch在每次更新中引入的噪声也有助于跳出局部极小。这为后续理解Adam(结合动量和自适应学习率)打下了基础。
学习路线图与核心建议
他还没做第五个模型,但路线已经排好:先实现mini-batch梯度下降配RMSProp,再上Adam,之后转向卷积神经网络。他的原则是每个优化算法都要在数学上理解并亲手实现之后,才进入下一个。
给初学者的建议也很直接:从线性代数开始,不要一上来就啃高级架构、优化器或高层框架。不必等所有数学概念都精通再动手,但至少要吃透矩阵乘法以及它如何表示网络内部的运算。他的总结是:不要只是训练神经网络,要理解它们。
项目已开源在GitHub(MuhammadEssa2002/neural_canvas),并提供在线demo,可以直接在浏览器里观察网络推理过程。
这种方法值得学吗
从工程效率看,手推梯度再写NumPy实现显然不划算——JAX一行jax.grad就解决了。但从学习效果看,前两个模型的手动推导建立的是对反向传播的肌肉记忆,这种理解在调试训练异常、设计自定义损失函数时会体现价值。
比较务实的折中路径是:先手写一个两层网络的反向传播建立直觉,之后用JAX的自动微分做实验,但每一步都自己定义模型结构、损失函数和参数更新规则,而不是直接调用model.compile()。Neural Canvas的路径大致就是这个思路——前两个模型打底,后两个模型借助工具加速,理解深度没有打折。
相关推荐
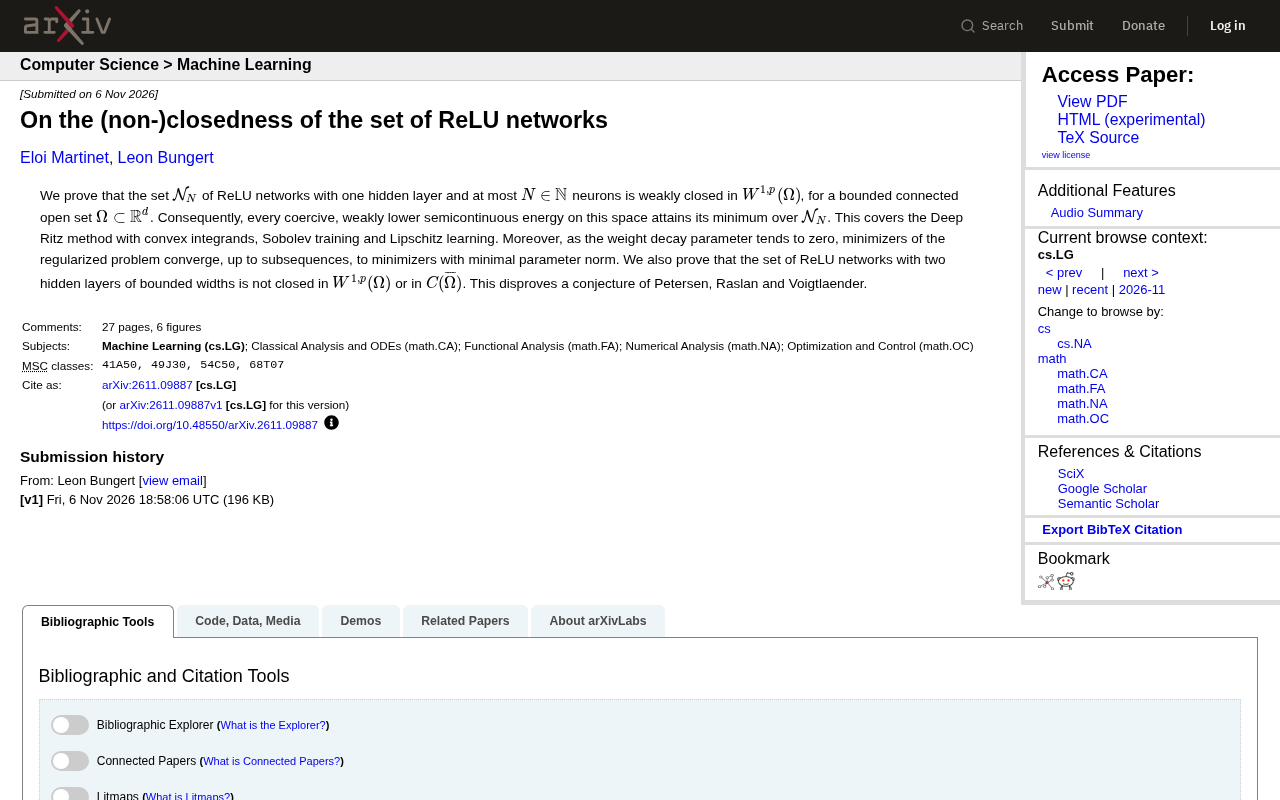
ReLU网络集合的闭性新证:单隐层弱闭,双隐层非闭
新研究证明单隐层ReLU网络集合在W^{1,p}中弱闭,保证Deep Ritz等方法解的存在性;而双隐层网络集合非闭,推翻已有猜想。
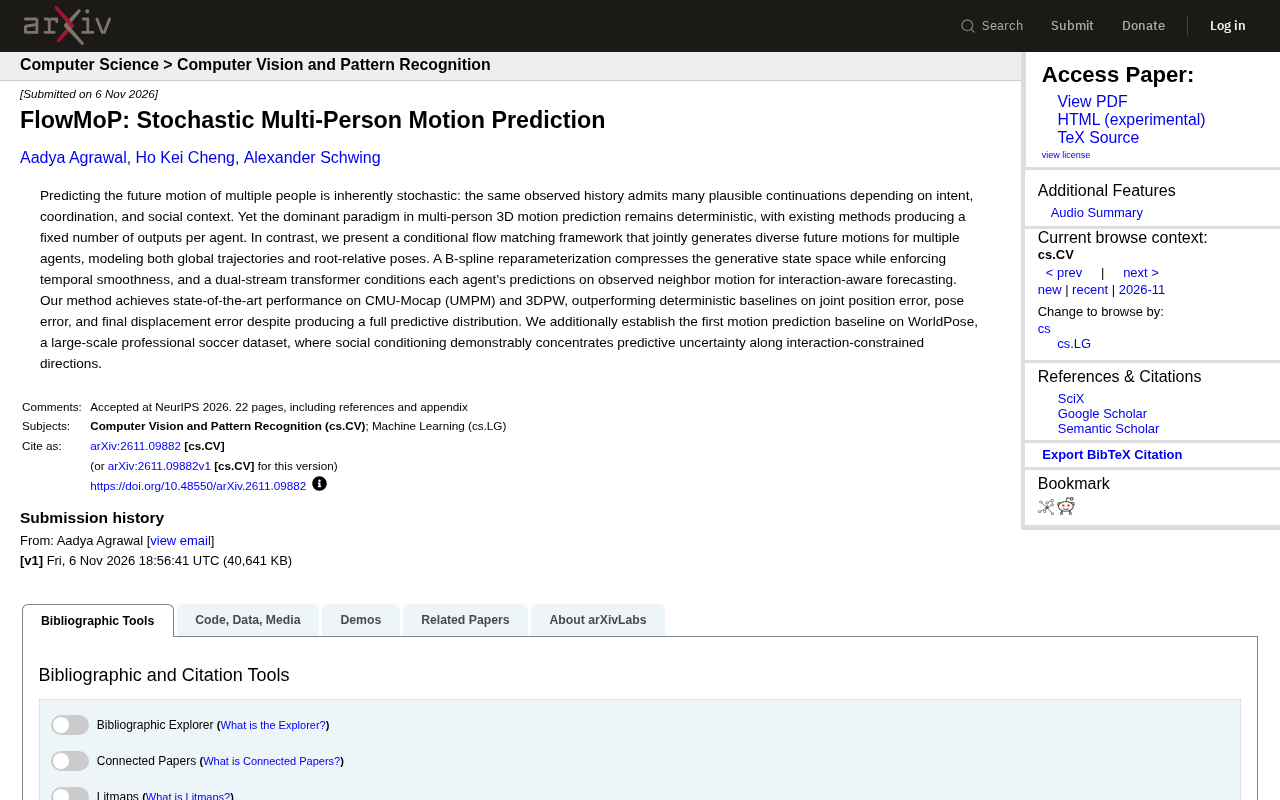
FlowMoP:随机多人运动预测新框架
FlowMoP提出条件流匹配框架,联合生成多个智能体的多样化未来运动,通过B样条重参数化与双流Transformer实现交互感知预测,在CMU-Mocap和3DPW上超越确定性基线,并建立WorldPose首个运动预测基线。
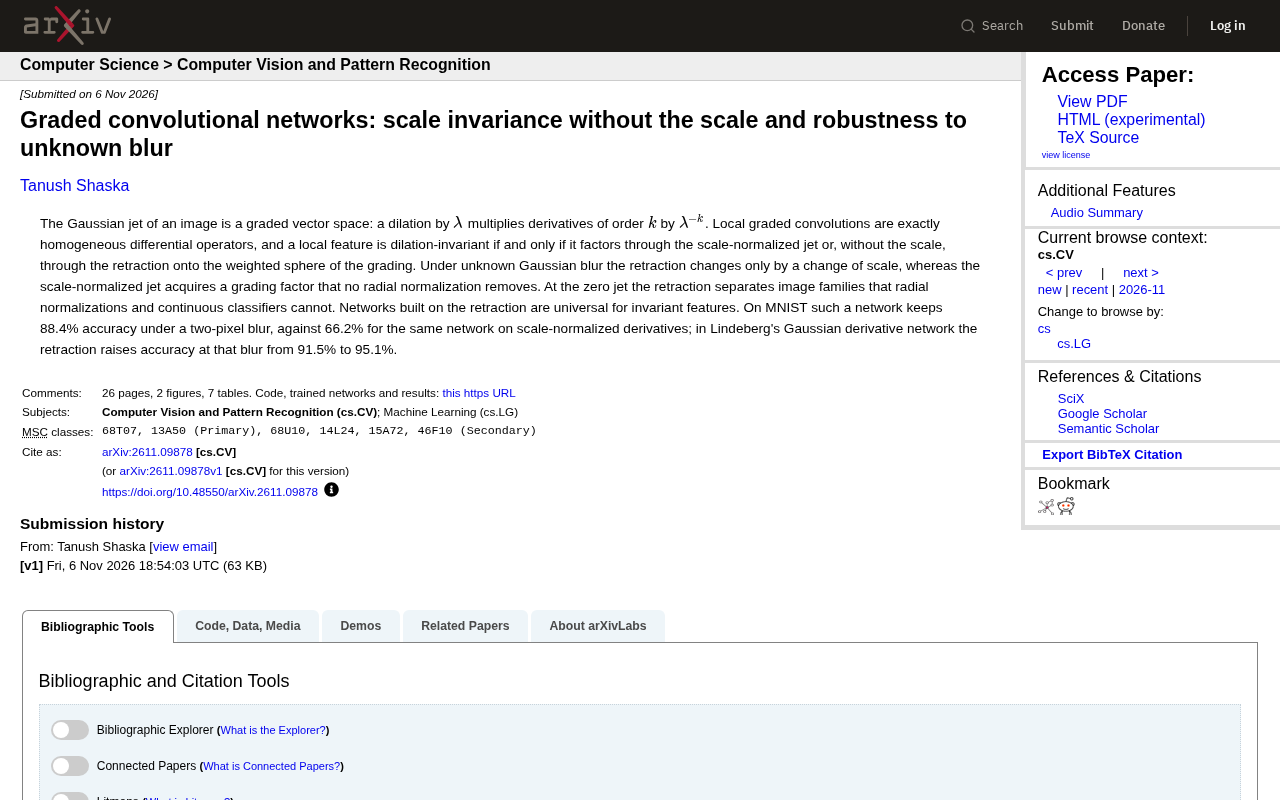
分级卷积网络:无需尺度参数的尺度不变性与抗模糊鲁棒性
分级卷积网络利用图像高斯射流的分级向量空间结构,通过回缩操作实现无需尺度参数的尺度不变性,并在未知高斯模糊下显著提升鲁棒性。MNIST实验显示,两像素模糊下准确率保持88.4%,优于尺度归一化导数的66.2%。