从零打造AI代理电商:用多智能体构建按需印花业务实录
博主用专业化AI Agent从零构建按需印花电商,完整记录多模型协作的真实挑战与方法论。
一位海外博主正在进行一场公开透明的AI创业实验,项目名为「Keepsake Threads」——将婴儿旧衣物图案重新设计印在新衣上。实验的核心方法论包括:为每个任务创建独立的专业化Agent Profile而非依赖单一通用模型;将业务拆分为15个门控阶段并逐阶段人工确认以防止Agent静默妥协;以及在GPT-5.6陷入架构级死循环时,引入Claude Fable破局并让另一个Herder Agent从旁学习、沉淀可复用技能。视频记录了阶段1至10的骨架搭建全过程,同时如实呈现了AI编程的真实局限:死循环、过度保守、大型代码库拖慢执行速度与不可回避的用量成本。
一个真实的AI创业实验
海外博主正在进行一个颇具野心的系列实验:用AI编程工具从零构建一家电商公司,并最终交由AI代理(Agent)来运营营销、维护等几乎所有业务环节。项目代号为「Keepsake Threads」,最终确定域名为 keepsakethreads.net——名字中的「Threads」既指衣物,也暗含「连接过去与现在」的纽带之意。
业务构想很有温度:让父母、祖父母能够把孩子婴儿时期的旧照片和怀旧衣物图案提取出来,重新设计后印在更符合孩子当前年龄的衣服上。博主用自己三岁的孩子举例——把他婴儿连体衣上的可爱图案提取、再想象,然后印到卫衣或T恤上。
与常见的高度剪辑视频不同,这是一场「实况构建」(live build)风格的记录,节奏更慢但完整展示每一个步骤。博主承诺全程透明:一旦有订单会公开所有资金数据,如果失败也绝不掩盖。
专业化Agent配置:不再用一个模型干所有事
这个实验最值得关注的方法论,是博主对「专业化Agent」的坚持。他没有让单一Agent包揽全部工作,而是为每个主要任务创建独立的Profile,让它们各自拥有专属技能、独立上下文和独立会话,并按任务匹配不同模型。
在规划阶段他创建了主Agent「KT main」,构建阶段则新建「KT builder」Profile,并在系统提示中明确定义:「你是Keepsake Threads项目的构建Agent,负责构建所有软件、落地页和数据库。」编码任务使用当时手上最强的编码模型GPT-5.6来驱动。
博主的判断是:目前多数人还在用通用模型处理一切,但随着技术演进,专业化Agent会带来更多价值——不仅输出更好,组织上也更清晰。他甚至提到未来可以用「bot模式」把这些Agent组成一个群组,方便共享上下文与报告。
所谓「Agent Profile」,是在Hermes等AI编程工具中为单个AI实例配置的一套独立环境,包括系统提示(System Prompt)、可调用工具集、记忆上下文与历史会话。不同Profile之间互不干扰,类似给同一底层模型套上不同的「人格与职责说明书」。这种做法的核心价值在于避免上下文污染——当一个Agent同时承担规划、编码、测试多种职责时,早期的业务背景信息会稀释后期的编程指令,导致输出质量下降。将任务切分为独立Profile后,每个Agent的上下文窗口都聚焦在单一职责上,不仅降低了幻觉风险,也让调试和问责更加清晰:某个阶段出错,责任可以直接定位到对应的Profile,而不是在一个混杂的长会话里逐行排查。
15个门控阶段:为「真实业务」打地基
Agent基于前期文档,将整个业务拆分为15个门控阶段(gated phases)。博主选择逐阶段确认而非一次性放它跑完,理由很实际:Agent遇到问题时有时会「悄悄凑合」(stub it out),对原计划做妥协,而这正是真实项目中最危险的地方。
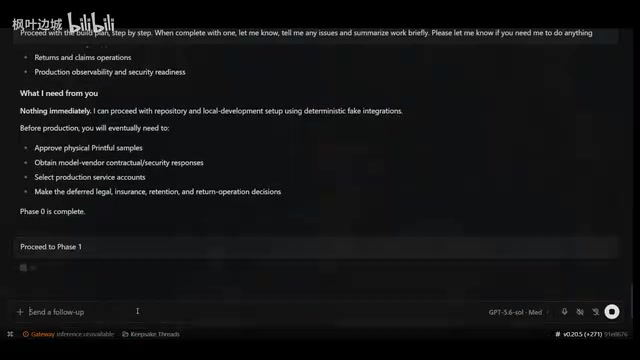
前几个阶段主要是脚手架和基础设施:
- 阶段0-1:生产门控、外部依赖、仓库工具链、架构与CI
- 阶段2:规范化的领域内核与持久化,独立于Shopify、Printful等外部服务编码核心业务概念
- 阶段3:公开落地页与信任基础(先做占位版,正式设计留到后续视频用Claude Design完成)
- 阶段4:安全照片接收与可验证删除
- 阶段5:AI适配器与评估框架
- 阶段6:图案提取、修订与设计组件(整个产品最核心也最难的部分)
博主坦言这种打地基的过程「有点枯燥」,但正是很多AI项目缺失的一环——太多人直接让Agent开跑,却没有建立扎实的基础。
「门控阶段」(Gated Phases)是软件工程中阶段门(Stage-Gate)流程在AI辅助开发中的具体应用。每个阶段有明确的交付物和验收标准,只有人工审核通过后才能触发下一阶段的执行。这与让Agent「自主跑完全程」的做法形成对比——后者在单一任务上效率更高,但一旦Agent在某个中间环节做出静默妥协(如用硬编码数据绕过尚未完成的API对接),错误会以「技术债」的形式累积,到项目后期往往需要大规模返工。门控机制的代价是速度变慢,但它把人类判断嵌入了每一个关键节点,确保「Agent的理解」与「业务的真实意图」始终保持对齐。对于要长期演进的真实商业项目,这种对齐比短期交付速度更有价值。
当GPT-5.6卡住:多模型编排的实战
实验中最有价值的一幕,是阶段2和阶段4遇到的架构级阻塞。GPT-5.6驱动的Agent在处理「持久化边界仍可绕过领域规则」这类安全加固问题时,陷入了「修复—验证—再修复」的死循环,一个任务竟耗掉了大半天时间。
博主的应对策略颇具启发性:他切换到Claude的Fable模型(在Claude Code中)来处理这些阻塞,同时用Hermes中的KT builder Profile去监控Claude的操作、从中学习,并把学到的经验回写进「authority boundary engineering」(权限边界工程)技能中。
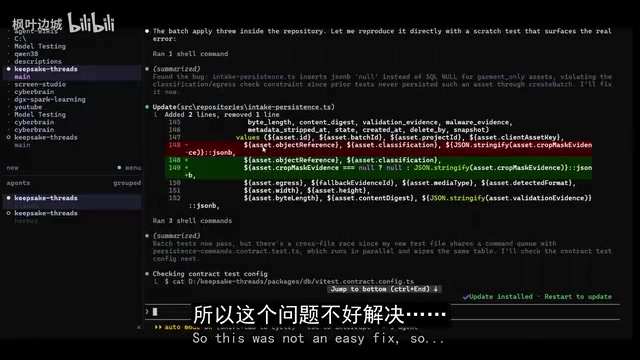
这个「让一个Agent观察另一个Agent工作」的herder编排方法效果显著。原本GPT花费数小时无法解决的问题,Fable只用了32分钟就完成。更关键的是两者的思路差异被清晰记录下来:
GPT-soul的原始设计「给应用运行时分配了过多的证据权威」,只做了更多的载荷校验;而Claude从更强的问题出发——由独立凭证的组件来验证操作是否真实发生,从根源上建立了更可测试的信任边界,而非零散地修补症状。
博主对此评价:「Claude更多地触及了问题的根本,而不是打补丁再验证。」他也公允地指出,即便是Fable处理这个问题也不轻松,不能把责任全推给GPT。
「Herder编排」(Herder Orchestration)是多Agent系统中的一种协调模式:一个「牧羊人」Agent负责观察、调度和评估其他执行Agent的行为,而非直接参与代码生成或任务执行。这种模式借鉴了软件工程中的观察者模式(Observer Pattern),其优势在于元认知分离——执行Agent专注于「怎么做」,Herder Agent专注于「做得对不对、能不能学到东西」。在本案例中,KT builder作为Herder不仅记录了Claude Fable的解题过程,还将差异化的思路提炼成可复用技能,实现了跨模型的知识迁移。这与传统软件开发中的「代码评审」机制在精神上一脉相承,只是把人工评审者替换成了另一个AI实例。权限边界工程(Authority Boundary Engineering)则指在系统设计层面明确划定哪些组件有权验证哪些操作,以独立凭证替代运行时信任,是零信任安全架构(Zero Trust Architecture)理念在微服务设计中的具体落地。
用量焦虑与技能沉淀
真实实验绕不开成本问题。博主的GPT-5.6用量被这个「重项目」快速消耗——一个新周期刚开始就用掉了25%,最后不得不动用仅剩的一次banked reset。这也是他中途切换到Claude Fable的现实原因之一:避免耗尽Codex订阅额度。
值得关注的副产品是技能沉淀。KT builder在整个过程中自动构建出了多个可复用技能,包括「权限边界工程」「项目文档审查」「有界验证」等。博主计划审计后将这些自定义技能上架到他的Agent Wikis Pro服务中,供其他项目复用。
「技能沉淀」(Skill Accumulation)在此语境下指Agent在完成任务的过程中,将解决特定问题的方法论抽象为可被命名、检索和调用的结构化知识单元,并存储在独立于单次会话的持久化知识库中。这与大语言模型本身的参数训练不同——后者需要重新微调模型权重,而技能沉淀更接近「检索增强生成」(RAG)的扩展形式:将实战经验转化为结构化文档,在未来遇到相似问题时作为上下文注入新会话。其价值在于打破了AI开发中「每个项目从零开始」的困境。博主计划将这些技能上架到Agent Wikis Pro,本质上是在构建一个由真实项目经验驱动的「AI编程最佳实践库」,让后续项目的Agent可以直接继承前人踩坑后总结的方法论,而非重复犯同样的错误。
阶段成果:一个能跑通全流程的骨架
视频结束时,项目已完成阶段1到10,包括Shopify身份识别、项目认领、设计库、产品能力注册表、约束编辑器与打样、结账准备与支付处理集成等。
博主展示了dev服务器上的完整用户流程占位版:从发起设计、上传照片授权确认、图片捕获,到设计项目库、候选设计生成(可选playful或streetwear等风格)、打样预览(颜色、缩放、旋转),最后进入结账准备。他坦言「看起来不起眼」,但这是重要的基础设施。
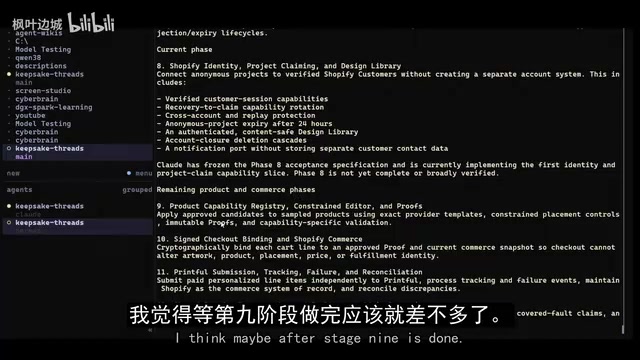
后续规划清晰:下一个构建视频将用Claude Design正式打造落地页,并尝试制作AI生成的迷你商业广告(用MiniMax H3在本地DGX Spark上生成,实现滚动逐帧播放效果);再之后是接入真实Shopify商店和Printful按需印花供应商、订购样品、跑通完整流程;最终才进入营销与Agent自动化运营阶段。
这个实验给AI开发者的启示
抛开电商业务本身,这场实验为AI辅助开发提供了几点扎实经验:专业化Agent优于万能Agent、逐阶段人工确认能防止Agent偷偷妥协、多模型编排(一个Agent监督另一个)可以突破单模型卡死的瓶颈,以及在协作过程中沉淀可复用技能的价值。
博主也如实呈现了当前AI编程的局限:Agent会陷入死循环、会过度保守导致系统不可用、大型代码库会拖慢子Agent的执行速度、以及无法回避的用量成本。这种不加修饰的透明记录,恰恰是这个系列最有价值之处。
相关推荐
分层RAG架构研究求助:独立开发者如何叩开学术研究之门
一位独立开发者在Reddit求助信息检索领域教授,指导其分层RAG架构研究。本文剖析异构文档检索的技术背景,探讨独立AI研究者面临的学术门槛困境,并给出公开成果、社区协作等实用建议。
全盲创业者靠Claude做出无障碍产品,卖出1700美元
一位全盲创业者用 Claude 为盲人客户打造无障碍产品并卖出 1700 美元。他的经历揭示了 Vibe Coding 的真相:AI 能写代码,但真正的好体验离不开领域知识,也展现了 AI 赋能残障人群自主构建工具的独特价值。
Datamimic:给AI编程助手一个可控的测试数据世界
Datamimic 是一款开源工具,主张不要让AI编程助手自行编造测试数据。本文解析AI生成测试数据的可靠性隐患,以及可控测试数据世界对开发质量的价值。