从零打造测试用例生成智能体:测试智能体与智能化测试平台实战解析
本文系统梳理了AI测试落地的四大方向与五级用例生成方案,核心结论是工作流+RAG+知识图谱的组合才是高覆盖测试的真正路径。
本文基于霍格沃兹测试开发学社的直播内容,梳理了智能化测试的四大主流方向(零件模拟、知识图谱、用例生成、用例执行),并详细拆解了从最简单的Web自动化智能体到完整测试平台的落地路径。核心方法论包括:通过DeepSeek Harness用自然语言驱动浏览器;利用轨迹视图诊断执行瓶颈,切换No-Thinking模式将耗时从三分钟压缩至一分钟;以及测试用例生成的五个进阶层级——从单智能体提示词(30%覆盖度)到整合工作流、RAG、知识图谱与智能探索(90%+覆盖度)。分享者以打卡业务为例,展示了一句话生成63条测试用例的真实效果,并强调真正的护城河在于业务知识库建设与工作流设计,而非单纯依赖提示词技巧。
AI测试正在从概念走向大规模落地。霍格沃兹测试开发学社在一场直播中,系统拆解了智能化测试的四大主流方向,并手把手演示了如何从最简单的Web自动化智能体起步,逐步构建完整的测试智能体与测试平台。本文对其核心方法论进行梳理,帮助测试工程师理解智能体、工作流与知识图谱在测试落地中的真实价值。
智能化测试的四大主流方向
当前测试行业中,AI的应用主要集中在四个方向:零件模拟、知识图谱、测试用例生成、测试用例执行,此外还包括智能探索、专项缺陷挖掘以及研发测试工作流本身的智能化。据分享者透露,其团队已对接超过100家潜在客户咨询智能化测试如何落地,AI测试已进入大规模使用阶段。
值得强调的是,这些方向并非孤立存在。测试用例生成依赖充分的业务知识,而知识来源又依赖智能探索去补齐文档,几者相辅相成,构成一个完整的闭环生态。
从最简单的Web自动化智能体入手
对于新手,直接开发平台难度过高,正确的路径是先学会智能体,再学会工具,最后打造测试专用智能体。分享中以 DeepSeek广告 官方推出的 Harness 工具为例,演示了如何用一句自然语言驱动浏览器完成自动化任务。
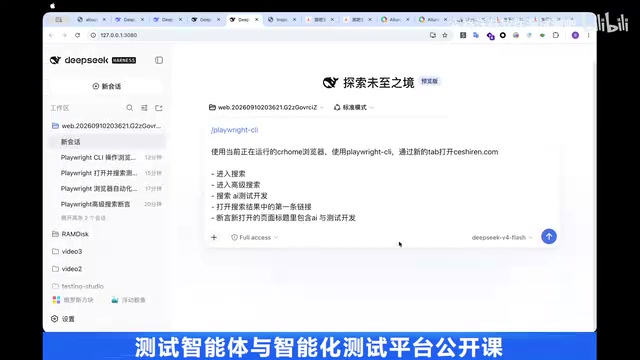
操作路径非常简洁:安装 DeepSeek Harness,创建工作区(推荐使用 Workspace Write 权限),配合 Playwright 等浏览器自动化工具,给出提示词如"打开测试人网站、进入高级搜索、搜索关键词、点击第一条链接并断言页面标题",智能体便会自主完成整套操作。这里的核心逻辑是——找一个智能体,借助浏览器自动化工具,让AI自己学会使用工具完成任务。
为什么智能体执行会慢?如何优化
直播中一个反复出现的实操问题是:智能体执行速度慢。分享者给出了系统性的诊断思路,这也是本次内容最具价值的部分。
通过 DeepSeek Harness 的"轨迹(duration)"视图,可以逐步查看每一步的耗时、输入输出 token 数、首 token 时间等指标,从而定位瓶颈。实测中,把浏览器页面拉到最前端的操作耗时约14至18秒,分析页面结构也较慢——这些属于工具调用层面的固有开销。
更关键的优化点在于模型层:默认思考模式(Thinking)会让大模型对确定性操作做过多推理。分享者切换到 No-Thinking 模式后,同样的流程从约三分钟缩短到一分钟。其给出的优化方案包括:改进系统提示词、改进工具、改进上下文管理、以及使用多智能体/子智能体分担工作。此外,通过大模型网关还能观测每一步的 token 消耗与费用,实测每次操作约消耗4万 token、花费约0.001元。
Thinking 模式与 No-Thinking 模式的差异源于大模型推理架构的不同设计。以 DeepSeek-R1 系列为代表的推理模型在生成最终答案前,会先输出一段内部"思维链"(Chain-of-Thought),对问题进行分步推导,这对数学证明、代码调试等高度不确定性任务有显著帮助,但同时也大幅增加了首 token 时间和总 token 消耗。No-Thinking 模式关闭这一推导过程,模型直接输出结果——对于"点击按钮""填写表单"这类操作路径确定、无需深度推理的自动化步骤而言,思维链不仅多余,还会带来明显的延迟与费用开销。合理区分任务类型、按需启用推理模式,是智能体工程中降本提速的关键决策之一。
测试平台的四层架构
分享者展示了自研的"爱测"智能测试平台,其采用四层结构:最上层是管理所有智能体与大模型的平台层,中间是测试智能体层,再往下是自动化层。平台内置了大模型网关,可统一接入 GLM Flash、DeepSeek 等模型,并特别加入 No-Think 模型以加快执行。
平台的核心能力体现在两个环节:用例生成与用例执行。用例执行支持手写用例或AI生成用例,选择智能体、大模型与执行节点后即可运行。分享中以雪球基金APP登录为例,故意写死错误验证码,演示断言失败的完整报告——报告使用 Allure 风格,包含每一步截图、操作记录与视频回放。
分享者特别指出:他演示的Web/APP自动化智能体严格来说"不是测试智能体",只是外部自动化智能体。真正的测试智能体必须能区分测试用例、测试步骤、测试断言、测试报告,还需要运行时上下文(如页面制图谱)和执行上下文,这才是很多公司最该关注的重点。
测试用例生成的五个进阶层级
用例生成看似简单,实则是最难的环节,因为高覆盖度依赖充分的文档、设计原型和背色系统,而多数公司的文档本身就是缺失的。分享者给出了覆盖度逐层递进的五种方案:
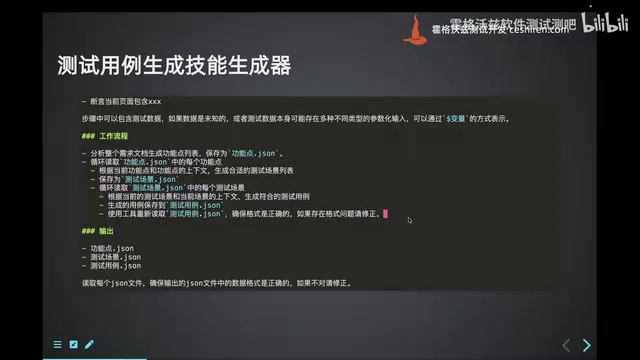
- 单智能体 + 提示词/技能:用 DeepSeek 先生成丰富提示词,再二次生成功能点、测试点。实现简单但覆盖度仅约30%,且单智能体上下文容易爆炸。
- 引入 RAG:文档过长超出上下文时,通过检索增强生成召回相关内容,覆盖度进一步提升。
- 工作流方式:多智能体协作,功能点切分、场景生成、用例生成各自独立,上下文永不受限,覆盖度可达约80%。
- 加入知识图谱:用 GraphRAG 建立业务知识关联,检索更精准,覆盖度继续上升。
- 探索学习:让智能体探索真实网站,文档更齐全,越跑越聪明,覆盖度可达90%以上。
分享者明确表态"不看好单纯的技能",因为技能本质就是提示词,单智能体必然面临上下文过大、压缩时丢失重要信息的问题。真正做好的关键是上工作流,并将工作流、RAG、知识图谱、智能探索四者整合。
理解这五个层级的边界,需要对**上下文窗口(Context Window)**有基本认知。大模型每次推理能处理的文本总量是有限的(以 token 计),超出窗口后模型会压缩或截断早期内容,导致关键需求信息丢失。单智能体方案中,功能点、测试场景、用例全部塞入同一个上下文,文档稍长便会触及上限;而工作流方案将任务拆分为独立步骤串行或并行执行,每一步只需处理当前阶段的输入,上下文始终保持在可控范围内。这就是为什么分享者强调"工作流方式上下文永不受限"——并非大模型能力变强,而是架构设计让每个节点的信息密度保持合理。
智能体、工作流与知识图谱的概念厘清
为帮助理解,分享者对几个核心概念做了区分。智能体本质是大模型加工具再加一个循环(Agent Loop),是一种特殊的工作流;工作流则是更底层、更复杂的概念,支持并行、串行、判断、Map-Reduce 等机制。工作流适合逻辑确定的场景(人清晰知道每一步怎么做,速度快、性能高),智能体适合需要动态决策的场景。
多智能体的编排模式包括:子智能体(主智能体调多个子智能体分工)、接力模式(执行完跳到下一个智能体)、Skill(单智能体加技能)、路由模式(预设执行路径)以及自定义工作流。
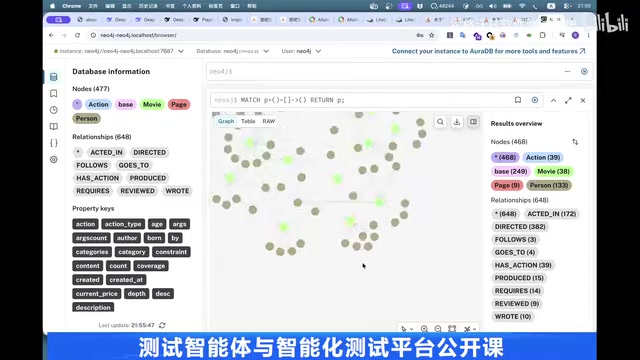
关于知识图谱,分享者建议以项目为单位进行隔离而非以文件为单位——同一项目共享知识库,不同项目分开。知识图谱的本质是"状态 + 事件"构成的业务知识全貌,其结构(节点 + 边)比具体工具更重要,Neo4j、NebulaGraph、NetworkX 甚至关系数据库都可实现。技术方向上推荐 GraphRAG,即任意业务数据通过AI建模生成图谱,再按需检索精准业务知识。
RAG(检索增强生成) 是理解本文多处内容的基础概念。其核心思路是:将外部文档切分成小块并向量化存储,当大模型需要回答问题时,先从向量库中检索与问题最相关的文本片段,再将这些片段拼入提示词,让模型基于真实文档而非训练记忆来生成答案。这样可以大幅减少"幻觉"并突破模型上下文长度限制。GraphRAG 是 RAG 的图谱增强版本:普通 RAG 只做相似度检索,无法感知概念之间的关联关系;GraphRAG 先用 AI 从业务文档中抽取实体与关系并构建知识图谱,检索时沿图的边进行多跳推理,从而能找到跨文档、跨概念的深层关联——这正是打卡案例中能精准识别"跨规则组合用例"的底层原因。
实战效果:一句话生成63条用例
分享者展示了打卡业务的真实案例:给出一份打卡 PDF 文档,系统自动拆解为功能点、测试场景、测试点,最终生成完整用例。通过查询知识图谱,识别出9个配置、39个 Action、15个打卡概念、7条特殊打卡规则(拍照打卡、补卡、特殊日期、非工作日云打卡、外出打卡等),一句话便生成了63条测试用例,覆盖跨规则组合、回归用例等多种维度。
这一效果远胜于简单查阅文档的方式,其准确度提升的根本原因正是那套清晰的策略——工作流、RAG、知识图谱的整合。
总结
这场分享清晰勾勒了智能化测试的落地路径:从 DeepSeek Harness 的最简 Web 自动化入手,理解智能体执行慢的诊断与优化方法,再逐步理解测试智能体与自动化智能体的本质区别,最终通过工作流、RAG、知识图谱、智能探索的组合,实现高覆盖度的用例生成与稳定执行。对测试工程师而言,与其纠结于满天飞的"技能"提示词,不如把精力投入到业务知识库建设与工作流设计上,这才是AI测试真正的护城河。
相关推荐

MrBeast百万美元挑战:吃空整家超市的内容工业拆解
深度拆解MrBeast百万美元吃空超市挑战:430万卡路里、202天封闭拍摄、规则设计与人物成长,解析头部内容创作者的工业化方法论与商业慈善双线叙事。

Cloudflare 推出 OHTTP 网关:隐私保护的新基础设施
Cloudflare 宣布推出 OHTTP 网关服务,通过中继与网关职责分离,将用户身份与请求内容解耦,为应用遥测、隐私合规等场景提供托管式隐私保护基础设施。本文解析 OHTTP 原理、信任模型与适用局限。

AI 自动化冷邮件:从网站痛点生成个性化外联的实战思路
一位网页设计从业者分享如何用 AI 工具 Swokei 自动诊断潜在客户网站的设计、速度、移动端与 SEO 问题,并生成个性化冷邮件,重构 B2B 外联工作流。本文解析其价值、分工逻辑与合规边界。