从零构建GLM-5.3-Flash:CPU上训练2500万参数模型实战

用一台CPU从零训练2500万参数小模型,走通预训练与强化学习全流程,理解AI研究的核心方法论。
这篇教程以"只需一颗CPU"为核心主张,带领读者从零构建并训练一个2500万参数的GLM-5.3-Flash小模型,完整走通预训练与强化学习两个阶段。为规避大词表占据绝大多数参数的问题,教程采用260个token的字符级词表。模型架构引入了线性与稀疏注意力混合、混合专家(MoE)、超连接残差等前沿设计,但规格被大幅压缩以适配普通硬件。预训练阶段是模仿学习,RL阶段则使用RLOO算法让模型自主探索并获得奖励,使24个任务的通过数从0提升到16。教程贯穿一个核心判断:数据与环境设计比算法优化更重要;AI研究员的真正价值在于提出高层次研究问题和实验方向,而非手写代码。作者建议有志者从小型玩具实验做起,保持稳定的对外发布节奏,而非追求算力规模。
用一颗CPU也能学会做AI研究
这门教程的核心主张颇具颠覆性:你不需要昂贵的GPU集群,仅凭一台普通CPU、MacBook就能从零构建并训练一个2500万参数的GLM-5.3-Flash模型,完整走通预训练与强化学习(RL)全流程。作者强调,模型虽小,但你学到的架构原理与实验方法,与OpenAI、Anthropic研究员日常做的事情本质相同,只是规模更简单。
作者抛出一个值得深思的观点:AI研究员的工作性质在短短几个月内发生了剧变。如今Claude Code、Codex等工具已经能自主编写并运行绝大多数实验代码,研究员的真正价值在于"提出高层次的想法"——决定做哪些实验、如何设计环境、问什么研究问题。他引用Anthropic的最新招聘描述称,这份描述涵盖了95%的AI研究员岗位职责,而这些岗位的核心已不再是手写代码。
作者直言:"人类负责提出好问题、设定方向,AI负责实现、实验和尝试。"但这不意味着可以不懂算法——想发明更快、更好的算法,前提是理解现有算法如何运作。这也是整个教程仍坚持逐行讲解代码的原因。
为什么用字符级词表而非BPE
真实的大模型使用BPE(字节对编码)分词器,词表通常有15万到30万个子词token。但在小模型场景下,这会带来一个致命问题:嵌入层和输出头这两个权重矩阵的一个维度就是词表大小。如果词表高达25万,那么在小模型里,这两个矩阵可能占据95%的参数,真正的模型层只剩5%。
为规避这一问题,教程把每个ASCII字符当作一个独立token,整个词表仅260个token。这样既免去了分词器训练的麻烦,又让参数真正用在模型本身。
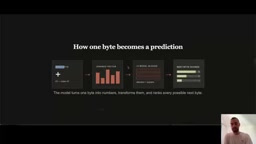
作者用清晰的语言复述了Transformer的基本逻辑:输入中的每个token都被替换为对应的向量嵌入,这些向量编码了token的"含义"(比如"+"号的向量会包含加法运算的功能信息)。整个prompt变成向量序列后送入Transformer层处理,最终把末尾的隐藏状态转换为覆盖全词表的概率分布,预测下一个token。
BPE(Byte Pair Encoding,字节对编码)是目前主流大模型的标准分词方案。它的核心思路是:从单个字符出发,反复合并出现频率最高的相邻字节对,最终生成一张"子词词表"。例如"ing""tion""##ly"这类高频片段会被合并为单一token,使得同样的文本用更少的token数来表达,从而降低序列长度、提升计算效率。GPT-4使用的tiktoken词表约有10万个token,LLaMA系列约3.2万,GLM原版则更大。BPE的代价是需要专门训练分词器,且词表矩阵本身就是一笔巨大的参数开销——对于只有2500万参数的小模型而言,一张25万行的嵌入矩阵几乎会"吃掉"整个参数预算,让真正负责推理的Transformer层无参数可用。字符级词表放弃了压缩效率,换来了极低的参数开销和零分词器依赖,是教学场景下务实而合理的取舍。
GLM-5.3-Flash的架构亮点
相比作者之前讲过的基础Transformer,GLM-5.3-Flash引入了几项新结构:线性与稀疏注意力混合机制、混合专家(MoE)、DeepSeek广告式流形约束残差连接(超连接/hyperconnections),以及输入输出共享同一词表转换矩阵(即权重绑定weight tying)。
教程版本的规格被大幅缩小:上下文窗口仅192个token(原版GLM是100万),层数和专家数都远少于原版。作者坦言,在强化学习之前,这个小模型无法成功完成任何任务;而RL训练之后,它能在24个任务中成功完成16个——任务很简单,比如"写一个把输入乘以2的Python函数",但前后差异极其明显。

架构中最值得关注的是稀疏索引器(sparse indexer)。注意力机制在这里不会关注整个上下文窗口,而是由一个更轻量、更便宜的索引器先找出最相关的token(比如前1000或2000个),再只对这些token做完整注意力计算。索引器本身也是一种注意力,但计算量小得多,它随序列长度的扩展速度远慢于标准二次方注意力。
此外,**线性注意力(KDA,状态空间模型思路)**维护一个固定大小的"记忆矩阵",所有token依次写入这个恒定状态。它擅长记住近期token、推理极快,但会丢失远距离的精确信息;稀疏层则周期性地恢复远处的精确细节。作者的经验是:这种混合设计训练和推理都显著更快,专为推理优化。
在MoE部分,原版GLM有288个专家,每个token从中选8个,外加1个所有token都经过的共享专家(学习通用信息,省去其他专家重复学习)。教程小模型则简化为2到8个专家。
混合专家(Mixture of Experts,MoE)是一种将前馈网络(FFN)层替换为多个"专家"子网络的架构。每个token经过路由器(router)动态选择其中少数几个专家处理,而非激活全部参数,从而在参数总量大幅增加的同时,每次前向传播的实际计算量保持不变。DeepSeek-V3/R1等模型正是通过MoE将总参数量扩展到数千亿,而激活参数量仍维持在约370亿,兼顾了模型容量与推理效率。"共享专家"(shared expert)是GLM和DeepSeek架构中的一个细节设计:始终有一个专家对所有token生效,专门学习跨任务的通用知识,避免路由专家重复学习相同的基础模式,提升参数利用效率。权重绑定(weight tying)则指将输入嵌入矩阵与输出投影矩阵设为同一份参数,GPT-2等早期模型已采用此技术,可将参数量减少一个词表大小×隐层维度的矩阵,并被发现有助于训练稳定性。
预训练:模仿学习写代码
预训练阶段的本质是模仿学习。给定一个Python函数的prompt,模型只是重复数据中已有的补全内容,并不"思考"答案。通过预测下一个字符,它逐渐学会每个字符的含义,从而能够生成它们。

标准流程不变:概率分布、交叉熵、梯度更新。优化器根据下一个token的正确性更新全部参数,让正确的字节每次都变得更可能一点。作者选用AdamW而非当下流行的Muon,纯粹出于简化考虑。
训练前模型只会生成随机字符,之后逐渐学会按prompt生成正确代码。作者还展示了几个真实的研究实验:数据重复与数据多样性的权衡(少量重复数据初期学得快,但200步后多样数据反超);多类型数据应该"先A后B后C"还是"交错训练"(交错训练能防止灾难性遗忘,避免模型学C时忘掉A和B);以及课程学习(先简单后复杂)是否真的有效。作者诚实指出,有些实验差异可能并不具备统计显著性,必须仔细思考实验在"测量什么",不能过度解读。
强化学习:让小模型学会"思考"
强化学习与预训练截然不同。模型不再重复文本,而是尝试生成答案,正确答案获得奖励。作者说得很坦率:"它算是学会了思考,但我不知道具体怎么做到的——如果你能搞清楚,你会成为最著名的AI研究员。"
在小模型的后训练中,正确率从4%提升到45%;按另一组任务统计则是从24个任务中0个通过提升到16个通过(pass@1,即只给一次尝试机会)。

教程使用的算法是RLOO(与GRPO同类)。核心思路是:对同一问题让模型生成多个答案(如16个),根据正确/错误/语法无效等给每个答案打分,再计算每个答案相对于平均值的优势(advantage)——比平均好的变得更可能,比平均差的变得更不可能。这种方式无需单独的评判模型或人工打分。
几个实用的工程细节值得记住:不要把测试用例展示给模型,否则它可能"奖励黑客"(reward hacking),通过读答案甚至入侵系统来作弊;奖励结构可以多样设计,如全部测试通过给+1、格式正确但数字错误给0、Python语法无效给-1;RL更新时作者只更新最后一个block、最终归一化层和输出头,以避免改动前面层导致遗忘,同时更新更快。
RLOO(REINFORCE Leave-One-Out)与GRPO(Group Relative Policy Optimization)同属"组内相对优势"类算法,均是对经典REINFORCE策略梯度的改进。传统REINFORCE直接用单次采样的奖励信号估计梯度,方差极高、训练不稳定。GRPO/RLOO的改进思路是:对同一问题采样一组答案(如16个),用组内其他答案的平均奖励作为基线,每个答案的"优势"= 自身奖励 − 组内均值,从而大幅降低方差。与PPO相比,这类方法无需单独训练一个价值函数(Critic)网络,实现更简洁,在语言模型后训练场景中已被DeepSeek-R1、Qwen等模型广泛采用。奖励信号本身可以是规则型的(如代码能否通过单元测试、答案是否等于标准答案),不依赖另一个模型打分,这使整个训练流程在算力有限的环境下也完全可行。
数据比算法更重要
贯穿全片的一个核心判断是:一旦有了足够好的算法,继续优化算法会迅速进入边际递减,而优化数据、环境和训练目标的回报要大得多。作者以DeepSeek为例——他们已不再在GRPO算法上投入大量精力,因为算法"足够好了",更多努力投向数据和环境设计。
作者的实验也印证了小模型的局限:由于模型小,RL只能在训练过的相似任务上提升;有一个任务没有改善甚至可能退化,作者坦言"大概率是代码bug,如果不是bug那就更有趣了"。他反复强调统计显著性的重要性:论文评审通常要求在三个随机种子上测试,且三个种子都应得出清晰一致的结论。而他自己的实验因规模太小,没有产生统计显著的改进。
关于实验设计方法论,作者引用MIT的建议:从小型玩具示例开始,这样你能真正理解发生了什么,远胜于直接上复杂的大实验。每次只改变一个变量——奖励方式、组大小、温度(探索vs利用)、惩罚力度等。
给想入行AI研究者的建议
作者给出的职业建议相当直接:如果你想进OpenAI或Anthropic,你不需要GPU。你需要学会如何构建强化学习环境、如何思考它们、如何检验模型是否在学习。除非你专门做扩展或预训练,否则规模并不是关键。
他建议持续在社交媒体上发布自己的实验,"一致性比强度更重要"——每周稳定发一次,胜过连发五天后彻底停更。同时建议把模型训练控制在几秒内完成,不要浪费时间等待,因为你真正需要练习的是设计实验和环境的能力,而不是和大公司拼算力——那是注定打不赢的仗。
所有代码都已开源在GitHub,读者可以直接让Codex或Claude Code克隆仓库、解释代码、复现图表,甚至在此基础上设计更难的实验。
相关推荐

Rysh Forge 实测:一份 OpenAPI 规范自动生成 Claude 可调用的 Agent 工具
Rysh Forge 用一条命令把 OpenAPI 规范自动转换成 Claude 可调用的 Agent 工具,同时生成 MCP server、Python SDK 和文档,并对写操作强制人工确认,实现全链路可观测。本文解析其工作流与价值。

OpenAI Agents SDK 实战:如何实现 Human-in-the-Loop 人工审批
基于 OpenAI Agents SDK 实现 Human-in-the-Loop 人工审批机制的完整教程:从 needs_approval 暂停工具调用、捕获 interruptions 中断,到 approve/reject 决策与 RunState 状态序列化恢复,让 AI Agent 在执行高风险操作前先征得人类同意。

MaRN开源:用低维参数映射训练神经网络的PyTorch库
开源PyTorch库MaRN通过低维参数映射训练神经网络,MNIST CNN参数压缩57.7倍仍保持91.8%准确率。本文解析其基准测试、功能构成与适用场景。