从零构建计算机视觉模型:值得一读的书籍推荐

CV领域尚无对标Raschka的从零构建书籍,但D2L与几本实践书可组合替代。
文章从社区提问出发,探讨计算机视觉领域为何缺少类似 Raschka《Build a LLM from Scratch》那样“从零构建”的书籍。核心原因在于 CV 模型谱系远比 LLM 庞杂,从 LeNet 到 ResNet、ViT、Swin,每个架构都在修补前者的具体缺陷,串讲难度更高。文章推荐了几本最接近这一理念的资源:《Programming Computer Vision with Python》偏底层但未覆盖 Transformer,《Deep Learning for Vision Systems》理解与实现并重,李沐团队的 D2L 免费且持续更新 ViT 章节,互动性最强。社区还提到《Modern Computer Vision with PyTorch》和 Fast.ai 课程作为补充。最后给出学习路径:实现简单 CNN、复现 ResNet 残差块、手写多头注意力搭 mini-ViT、逐行读 PyTorch 源码。
从零构建计算机视觉模型:值得一读的书籍推荐
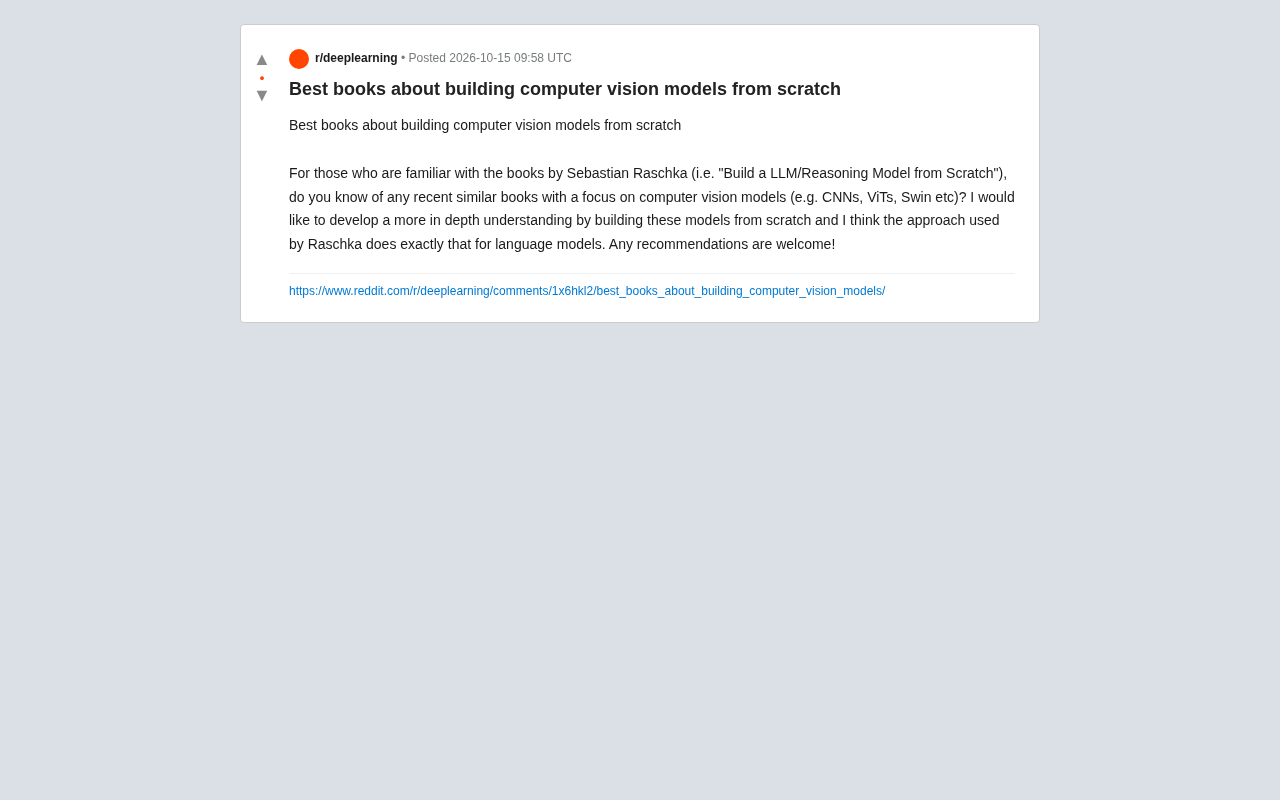
不少开发者通过 Sebastian Raschka 的《Build a LLM from Scratch》系列,第一次真正理解了语言模型内部每一层的运作机制。如今,一批有同样诉求的读者开始在社区中发问:计算机视觉领域有没有类似的书?不是调用 torchvision.models.resnet50() 就完事,而是一行一行地把 CNN、ViT、Swin Transformer 搭出来。
这个问题背后其实藏着一个更深的诉求:CV 学习长期停留在“调包”层面。数据增强、预训练权重、迁移学习——这些工具太方便,反而挡住了理解模型本质的路径。Raschka 的写作方式之所以受欢迎,正是因为他强迫读者直面每一个矩阵乘法和注意力头。
CV 领域为什么缺少“从零构建”类书籍
语言模型的从零构建书籍能火起来,有一个客观条件:Transformer 架构本身极其统一。理解了 attention 机制,GPT、LLaMA、Mistral 之间的差异只是堆叠方式和训练策略的不同。
但计算机视觉的模型谱系要杂得多。LeNet、AlexNet、VGG、ResNet、DenseNet、EfficientNet,再到 Vision Transformer、Swin、ConvNeXt——每个架构都在解决前一个架构暴露出的具体缺陷。残差连接解决梯度消失,深度可分离卷积压缩参数量,窗口注意力降低 ViT 的二次复杂度。把这些线索串起来讲清楚,比讲 LLM 的难度高一个量级。
这也是为什么 CV 领域的经典书籍更偏向“综述式”写法,而不是 Raschka 那种“手把手搭一个”的风格。
深度可分离卷积(Depthwise Separable Convolution) 是 MobileNet 系列提出的核心构件,用来在保持精度的前提下大幅压缩计算量。它把标准卷积拆成两步:先对每个输入通道独立做一层卷积(depthwise),再用 1×1 卷积把通道数重新组合(pointwise)。标准卷积的计算量约为 (D_k^2 \cdot M \cdot N \cdot D_f^2),而深度可分离卷积约为 (D_k^2 \cdot M \cdot D_f^2 + M \cdot N \cdot D_f^2),在 3×3 卷积下通常能降到原来的八分之一到九分之一。理解这个分解方式,是读懂 MobileNet、EfficientNet 为何能在移动端落地的关键,也是“从零构建”时最容易写错通道维度的地方。
窗口注意力(Window Attention) 则是 Swin Transformer 针对 ViT 全局注意力二次复杂度问题给出的方案。ViT 里每个 patch 都要和其余所有 patch 计算注意力,序列长度为 (N) 时复杂度是 (O(N^2))。Swin 把图像划分成不重叠的局部窗口,只在窗口内做自注意力,复杂度降为线性;再通过 Shifted Window 让相邻窗口之间交换信息,弥补局部性带来的全局建模损失。这种“局部注意力+移位”的层级设计,正是文章所说“每个架构都在解决前一个架构暴露出的具体缺陷”的典型例子。
最接近 Raschka 风格的 CV 书籍
《Programming Computer Vision with Python》—— 动手派的入门选择
Jan Erik Solem 的这本书用 Python 和 NumPy 从最基础的图像处理讲起,涵盖了特征提取、图像配准、三维重建等主题。它的优点在于代码量足够大、足够底层,读者需要自己实现 SIFT 等经典算法。缺点是出版时间较早,完全没有覆盖 Transformer 时代的 CV 模型。
如果你已经熟悉 PyTorch 基础,可以跳过这本书的前几章,直接从特征工程部分开始。
SIFT(Scale-Invariant Feature Transform) 是 David Lowe 在 1999 年提出、2004 年完善的经典局部特征算法,也是这本书让读者亲手实现的代表算法之一。它的流程大致包括:构建高斯差分金字塔以检测尺度空间极值点、剔除低对比度和边缘响应点、为每个关键点分配主方向实现旋转不变性、最后生成 128 维梯度直方图描述子。SIFT 之所以经典,是因为它同时具备尺度、旋转、亮度不变性,在图像拼接、三维重建、物体检索中长期是标配。亲手实现一遍能让人直观理解“特征”到底是什么,也能体会为什么深度学习出现之前,CV 研究大量精力都花在手工设计不变性上——而这恰恰是 CNN 用学习替代人工设计的价值所在。
《Deep Learning for Vision Systems》—— 理解与实现并重
Mohamed Elgendy 的这本书在用 PyTorch 实现经典 CV 模型方面做得比较扎实。它从感知机讲起,逐步过渡到 CNN、目标检测(YOLO、Faster R-CNN)、图像分割,最后涉及视觉 Transformer。每一章都有可运行的代码示例。
和 Raschka 的书相比,它在数学推导的细致程度上略逊一筹,但胜在覆盖面广,且对每个架构“为什么这样设计”的讨论比较充分。
Faster R-CNN 与 YOLO 代表了目标检测的两条主要技术路线,理解它们的分歧有助于读懂后续架构的演化。Faster R-CNN 属于两阶段检测器:先用 Region Proposal Network 生成候选框,再对每个候选框做分类和回归,精度高但速度慢。YOLO 则把检测统一成一个回归问题,将图像划分为网格,每个网格直接预测边界框和类别,一次前向即可完成,速度极快。两者的差异本质上是“先找再判”与“一步到位”的权衡,也解释了为什么 YOLO 系列在实时场景更受欢迎,而两阶段方法在精度敏感的学术基准上仍有一席之地。
《Dive into Deep Learning》—— 免费且持续更新
李沐团队的 D2L 虽然不是专门讲 CV 的书,但它的 CV 章节(包括 CNN、现代卷积网络、计算机视觉应用)质量很高,而且代码基于 PyTorch 实现,可以逐行运行。最关键的是:它持续更新,ViT 相关的章节已经补充进来。
对于想要“从零构建”的读者,D2L 的互动式学习体验可能比任何纸质书都更接近 Raschka 的理念。
单一来源推荐的补充书目
在 Reddit 该讨论帖中,有用户提到《Modern Computer Vision with PyTorch》(Packt 出版),这本书覆盖了从基础 CNN 到 GAN、扩散模型的广泛主题,代码示例丰富。另有人推荐 Fast.ai 的课程作为替代方案——它不是书,但“从上往下”的教学法(先跑通完整项目,再深入底层)适合不同学习风格的人。
需要说明的是,这些推荐来自社区用户的个人经验,而非系统性评估。读者可以根据自己的学习偏好做取舍。
如何用“从零构建”的方式学习 CV
不管选哪本书,有效的学习路径大致相同:
- 先实现一个最简单的 CNN,在 MNIST 或 CIFAR-10 上跑通,理解卷积核、步长、池化的实际效果。
- 复现 ResNet 的残差块,对比有无 skip connection 时的训练收敛差异——这个实验比任何文字描述都有说服力。
- 手动实现多头自注意力,然后在 small-scale 数据集上搭建一个 mini-ViT。这一步会暴露很多“调包时永远遇不到”的维度匹配问题。
- 读源码,PyTorch 的
torchvision.models里每个模型都有对应的实现文件,逐行读一遍比读任何教程都直接。
这个路径和 Raschka 书中的方法论一脉相承:先让代码跑起来,再理解为什么这样写,最后尝试修改设计并观察效果。
多头自注意力(Multi-Head Self-Attention) 是 Transformer 和 ViT 的核心运算,手动实现时通常会卡在几个维度细节上。给定输入 (X \in \mathbb{R}^{N \times d}),先通过三组线性变换得到 Query、Key、Value;再拆成 (h) 个头,每个头维度为 (d/h),各自计算 (\text{softmax}(QK^\top/\sqrt{d/h})V);最后把各头输出拼接再投影回 (d) 维。在 CV 里,(N) 就是 patch 数量(例如 224×224 图像切成 16×16 patch 时 (N=196)),位置编码需要额外加上,因为注意力本身对顺序不敏感。把这些张量形状理清楚,是从“调用模型”走向“理解模型”最有效的一步。
写在最后
严格来说,目前还没有一本 CV 领域的书能完全对标 Raschka 的 LLM 从零构建系列。CV 模型架构的多样性决定了这件事本身就更难。但《Deep Learning for Vision Systems》和 D2L 的 CV 章节可以组合使用,再加上 PyTorch 官方源码的对照阅读,足以建立起足够深入的理解。
工具越方便,理解越稀缺。愿意花时间从零搭建 CV 模型的人,收获的不只是知识,还有一种面对新架构时“我知道它是怎么转起来的”的底气。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。