AI大模型入门:核心概念、发展历程与国产模型格局

对于想要入门AI大模型应用开发的初学者来说,第一道门槛往往不是代码,而是一堆容易混淆的概念:人工智能、生成式AI、机器学习、深度学习、大语言模型(LLM)……它们之间究竟是什么关系?本文系统梳理大模型的核心概念、发展脉络,以及当前国内外的模型竞争格局,帮你快速建立清晰的认知框架。
厘清基础概念:AI、机器学习与深度学习的关系
很多人对人工智能的评价两极分化:有人说它是"人工智障",有人却认为它即将取代人类。这种巨大分歧的根源,在于人们对AI的期望值不同。期待它像哆啦A梦那样无所不能,目前确实难以实现;但若只要求它解决某个垂直领域的具体问题,则早已大规模落地。
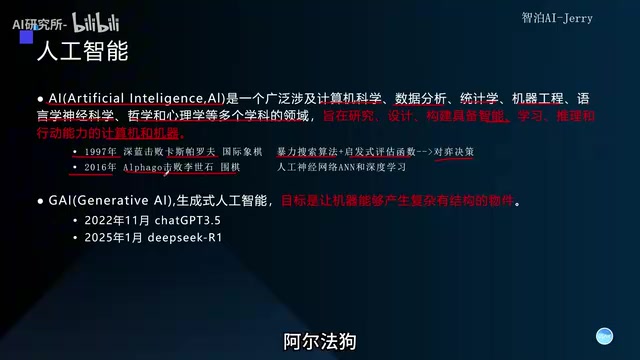
从概念层级看,人工智能是横跨计算机科学、统计学、语言学、神经科学乃至哲学的交叉学科,目标是构建具备智能学习、推理和行动能力的机器。这一学科的历史可追溯至1956年达特茅斯会议,这被普遍认为是AI作为独立研究领域的正式起点。彼时,约翰·麦卡锡、马文·明斯基、克劳德·香农等十位顶尖学者聚集在新罕布什尔州的达特茅斯学院,共同撰写了那份著名的提案,首次使用了"人工智能"这一术语。他们乐观地预测,十年内机器将能完成人类所有智力活动。然而现实远比想象复杂,AI随后经历了两次"寒冬"——1970年代的第一次寒冬源于早期AI系统无法扩展到真实世界的复杂性,组合爆炸问题使得基于逻辑推理的系统在稍复杂的场景下便彻底失效;1980至90年代的第二次寒冬则源于专家系统(Expert System)的大规模商业化失败,这类系统依赖人工编写成千上万条规则,维护成本极高且缺乏泛化能力,最终被市场淘汰。两次寒冬期间,研究经费大幅削减,进展停滞。这段历史有助于理解为何今天的AI研究者对"通用人工智能即将到来"的论断普遍保持审慎态度。机器学习与深度学习,则是实现这一目标的核心手段。
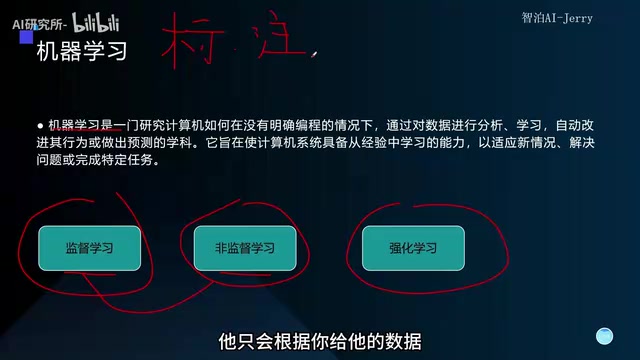
机器学习的三种基本方法
机器学习是早期AI训练的主要方式,通常分为三类:
-
监督学习:提供标注好的数据。比如给模型大量已标注"猫"或"狗"的图片,模型从中提取特征并与标签建立关联——就像老师先给你讲大量例题,看得越多学得越准。监督学习在工业界应用最为广泛,典型案例包括垃圾邮件过滤、医学影像诊断和信用评分系统。其核心挑战在于数据标注成本极高——ImageNet数据集(深度学习视觉革命的基石)包含超过1400万张人工标注图片,耗费了数年时间方才完成。
-
非监督学习:可以理解为"自学"。输入的是未标注、甚至残缺的数据,常见策略是"补全"——故意遮住文本或图片的部分内容,让模型自行还原,以此检验它是否真正理解了内容。其中"自监督学习"变体是GPT系列模型的训练基础:通过预测文本中被遮蔽的下一个词,模型无需人工标注便能从海量文本中自动学习语言规律,这也是大模型能够以相对低廉的成本吸收互联网级别知识的关键所在。
-
强化学习:建立在前两者基础上,通过正反馈与负反馈约束和强化模型行为。答得好就"点赞",答得差就"打叉",经过多轮迭代后模型便能找到更优的回答策略——与教育心理学中的奖惩机制异曲同工。
值得一提的是,从人类反馈中强化学习(RLHF,Reinforcement Learning from Human Feedback)正是ChatGPT能够对话如此自然流畅的关键技术。RLHF的实施通常分为三个阶段:第一阶段是监督微调(SFT),使用人工编写的高质量示范数据对预训练模型进行初步对齐;第二阶段是奖励模型训练,由人类标注者对模型的多个回答进行偏好排序,用这些数据训练一个能够预测人类偏好的奖励模型;第三阶段是强化学习优化,以奖励模型的评分为反馈信号,使用PPO(近端策略优化)算法持续调整语言模型的输出策略,使其真正符合人类表达习惯与价值取向。PPO(Proximal Policy Optimization,近端策略优化)是一种较为保守的强化学习算法:它通过限制每次参数更新的幅度(即"近端"约束),避免模型在奖励信号的驱使下发生过激的策略偏转,从而在学习效率与训练稳定性之间取得平衡。
RLHF的局限性同样值得关注:人类标注者本身存在偏见和不一致性,奖励模型可能被"过度优化"(即奖励黑客问题,Reward Hacking——模型找到了在奖励模型看来得分很高、但在真实人类判断中质量很差的作弊输出方式),且整个流程成本高昂、难以大规模扩展。这也是Anthropic提出Constitutional AI(宪法AI,通过让模型遵循一套预设的价值原则进行自我批判和修正,从而减少对人工标注的依赖)、以及直接偏好优化(DPO,Direct Preference Optimization——跳过显式奖励模型的训练,直接用偏好数据端到端优化语言模型)等替代方案获得广泛关注的根本原因。
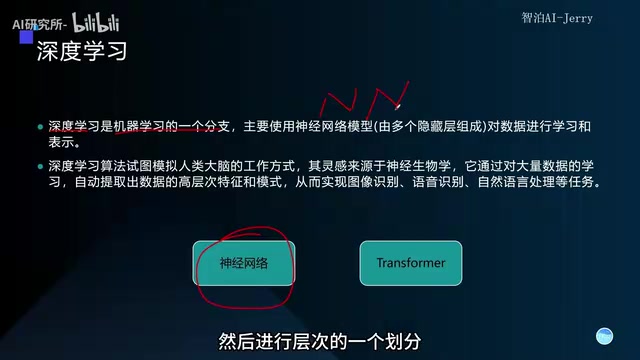
深度学习:机器学习的进阶分支
深度学习是机器学习的一个重要分支,核心是神经网络(Neural Network)。它模拟人脑神经网络的分层信息处理结构,由大量节点和连接边组成,并划分为多个层次——所谓"深度",指的就是网络层数。
需要厘清的是,深度并不直接代表智能,而是代表不同的信息处理维度。以数列"1 2 3 4 5 6"为例:第一层识别出"这是六个数字",第二层提取最大值、最小值和均值,第三层判断出"这是等差数列",第四层则能预测下一个数是7、8、9。层层递进,逐步抽象出更高维度的规律。
每个神经网络节点(即"神经元")的工作原理可以理解为:接收来自上一层的多个输入值,对其加权求和后,通过一个激活函数决定是否向下一层"激发"信号。激活函数的作用至关重要——如果没有它,无论网络有多少层,整个系统本质上仍是一个线性变换,无法表达复杂的非线性规律。正是激活函数赋予了深度网络拟合任意复杂函数的理论能力。
大模型的爆炸式演进历程
人工智能真正走进大众视野,可以追溯到几个关键里程碑。
从深蓝到AlphaGo:符号主义到深度学习的跨越
1997年,IBM深蓝击败国际象棋世界冠军卡斯帕罗夫,首次让人类感受到机器智能的震撼。但其技术并不神秘——深蓝采用暴力搜索算法,穷举对手接下来若干步的所有可能走法,再由程序员预设的评估函数做出决策。由于国际象棋的走法组合有限,这在当时的算力条件下完全可行。
深蓝与AlphaGo背后,实际上代表了AI发展史上两条截然不同的技术路线的兴衰。深蓝所代表的「符号主义」(Symbolicism)认为智能可以通过显式规则和逻辑推理来实现,知识以符号形式编码,程序员将棋类规则和评估函数硬编码其中。而AlphaGo所代表的「连接主义」(Connectionism)则认为智能源于大量简单单元的协同运作,无需人工设计规则,模型从数据中自动涌现出决策能力。这两种范式的竞争贯穿了AI六十年的历史,并在2010年代以深度学习的全面胜出暂时画上了阶段性句号——尽管近年来,以大模型为基础、结合符号推理的「神经符号融合」路线又重新引发了学界的广泛关注。
然而,当人们提出"能否下赢围棋"时,暴力搜索便力不从心——围棋的合法局面数约为2×10^170,组合复杂度远超国际象棋的10^47,穷举搜索在宇宙尺度的时间内也无法完成。AI由此陷入近二十年的低谷。直到2016年,基于深度学习与人工神经网络的AlphaGo击败韩国棋手李世石,次年升级版又战胜柯洁,才重新点燃了全球对AI的热情。AlphaGo的核心突破在于将**蒙特卡洛树搜索(MCTS)**与深度神经网络结合:一个策略网络(Policy Network)负责预判对手最可能的走法,大幅剪枝搜索空间;一个价值网络(Value Network)负责评估当前局面的胜率,取代人工编写评估函数。两者协同,使AlphaGo在极大的搜索空间中仍能做出高质量决策。
残差连接:突破深度塌陷的关键技术
深度学习早期面临一个棘手难题:深度塌陷。随着网络层数增加,无论输入什么数据,最终提取出的特征都趋于一致——模型失去了区分不同输入的能力。
这一现象的本质是梯度消失问题:在反向传播过程中,误差信号需要逐层向前传递。神经网络的训练依赖"反向传播"算法——它通过链式法则,将输出端的预测误差逐层向输入端传递,并据此调整每一层的权重。当网络使用Sigmoid或Tanh等饱和激活函数时,这些函数在输入值较大或较小时的导数趋近于零,导致每经过一层,梯度值便被压缩一次,如同一个信号每经过一段电阻就衰减一次。经过数十层叠加后,梯度几乎衰减为零,前层权重无法有效更新,网络训练陷入停滞。ReLU激活函数(Rectified Linear Unit,修正线性单元——对正数输入原样输出,对负数输入则输出零)的引入部分缓解了这一问题,但真正的结构性突破来自中国学者何恺明提出的残差连接(ResNet)。
残差连接的核心思想极为简洁:在每个网络层旁边增加一条"跳跃连接",将输入信号直接加到该层的输出上,数学表达为 H(x) = F(x) + x,其中F(x)是该层需要学习的"残差"部分。这一设计相当于为梯度提供了一条"高速公路",使其可以跨越多层直接回传,不再受激活函数的逐层压缩制约。从信息论角度理解,跳跃连接保证了即便某些层的学习失败(F(x)趋近于零),输入信号x仍能原封不动地传递到下一层,网络退化为更浅的有效深度而非完全失效。这一机制成功支撑了152层超深网络的训练,并在2015年ImageNet竞赛中以低于4%的错误率首次超越人类水平(约5%)。残差连接为深度学习的全面爆发奠定了基础,何恺明也因此荣获2024年CVPR最佳论文终身成就奖。
生成式AI的崛起与大模型时代
2021年,斯坦福大学研究团队提出"基础模型(Foundation Model)"概念,用以描述在海量无标注数据上预训练、可通过微调适配多种下游任务的通用模型。"基础模型"这一术语的提出本身具有战略意义:它强调这类模型是整个AI应用生态的"地基",而非针对特定任务的专用工具,预示着AI开发范式从"为每个任务单独训练模型"转向"预训练+微调"的两阶段范式。其最令人瞩目的特性是涌现能力(Emergent Abilities)——当模型参数规模突破某一临界点后,会突然具备此前从未被明确训练过的能力,如逻辑推理、代码生成和类比分析。
值得注意的是,涌现能力至今仍存在学术争议。2023年斯坦福大学的研究发现:当使用更连续的评估指标(而非二值化的通过/失败)重新测量时,所谓"涌现"往往只是评估方法造成的测量假象,模型能力的提升实际上仍是平滑连续的。这场争论揭示了一个更深层的问题:我们目前对大模型内部能力的评估工具和理论框架仍极不完善,也是AI可解释性研究成为前沿热点的重要动因。
2022年11月,OpenAI发布ChatGPT,标志着**生成式AI(Generative AI)**的真正到来。生成式AI与此前AI的本质区别在于:传统AI主要完成单选、判断、填空等"从有到有"的任务,而生成式AI能够"从0到1"创造出结构完整的全新内容,如写作、编程、绘画。
大语言模型的核心工作原理是「下一个Token预测」——在给定上下文后,模型通过概率分布预测最可能出现的下一个词片段(Token)。Token并非完整的词,而是词的最小语义单元切片:在英语中,"running"可能被切分为"run"和"##ing"两个Token;在中文中,每个汉字通常对应一个Token,但也有常见词组被合并为单一Token。这种分词策略(Tokenization)使模型能够以有限的词表覆盖几乎无限的词汇组合。这一机制赋予了模型强大的语言生成能力,但也天然导致了**幻觉(Hallucination)**问题:模型倾向于生成「听起来合理」的内容,而非「事实正确」的内容,因为训练目标是最大化语言流畅度,而非保证信息准确性。幻觉问题是当前大模型落地应用的最大障碍之一,也是检索增强生成(RAG)、工具调用(Function Calling)等工程方案得到广泛应用的根本动因——通过让模型在回答前先检索外部知识库或调用可信数据源,可以大幅降低幻觉率,将模型的语言组织能力与外部知识的准确性有机结合。
OpenAI从早期版本到成熟版本的迭代也验证了**规模定律(Scaling Law)**这一关键规律。这并非定性判断,而是有严格量化支撑的实证规律:OpenAI 2020年的研究论文揭示,语言模型的性能与模型参数量、训练数据量、计算量(FLOPs)均呈现幂律关系,且三者相互独立地影响最终性能。简单来说,规模定律意味着"更大的模型+更多的数据+更多的算力=更强的性能"——这一规律为整个行业的大规模算力投入提供了理论依据,也成为英伟达GPU需求爆发式增长的底层逻辑。2022年,DeepMind的Chinchilla研究进一步修正了最优训练策略:此前GPT-3等模型普遍存在"参数过多、数据过少"的问题,Chinchilla通过系统实验证明,在给定计算预算下,模型参数量与训练token数应大致保持1:20的比例——例如一个70亿参数的模型,最优训练数据量约为1400亿个Token,而非GPT-3时代普遍采用的300亿Token。这一发现直接推动了业界从"单纯堆参数"转向"数据与参数协同扩展"的训练范式转变。
DeepSeek广告-R1的发布与开源成为又一重要里程碑,吹响了国产大模型"百模大战"的号角。DeepSeek-R1以MIT协议完全开放模型权重,这意味着企业可以免费下载、修改和商业化使用,无需支付API调用费用,同时可在本地私有化部署以规避数据隐私风险。更重要的是,其官方披露的训练成本约600万美元,远低于外界对同等能力模型的成本估算,直接引发了业界对"算力军备竞赛"叙事的重新审视。
大模型领域的开源与闭源之争,本质上是「技术民主化」与「商业护城河」两种发展逻辑的博弈。以OpenAI的GPT-4和Anthropic的Claude为代表的闭源模型,通过API服务变现,将模型权重视为核心资产严格保密。而以Meta的LLaMA系列和DeepSeek为代表的开源模型,则通过释放模型权重换取生态主导权——开发者基于开源模型构建的每一个应用,都在事实上扩大了该模型框架的影响力版图。开源路线还催生了Hugging Face等模型托管平台的繁荣,以及LoRA、QLoRA等参数高效微调技术的快速普及,使得中小企业和个人开发者得以在消费级GPU上完成针对特定业务场景的模型定制。LoRA(Low-Rank Adaptation,低秩适配)的核心思路是:微调时不修改原模型的全部参数,而是在每个权重矩阵旁边插入两个小矩阵,仅训练这两个小矩阵,所需显存和计算量大幅降低,微调完成后可无缝合并回原模型。对于每一个开发者而言,开源的意义在于得以"站在巨人肩膀上",只需专注数据准备和模型微调,即可快速让自己的模型跑起来,极大降低了AI应用的准入门槛。
Transformer架构与应用开发的定位
在传统神经网络局限性的基础上,业界提出了Transformer架构。它诞生于2017年Google Brain团队发表的论文《Attention Is All You Need》,彻底颠覆了此前以RNN(循环神经网络)为主导的序列处理范式。
在Transformer出现之前,处理序列数据(如文本、语音)的主流方案是循环神经网络(RNN)及其变体LSTM(长短期记忆网络)和GRU(门控循环单元)。RNN的核心缺陷在于其串行计算特性:处理第N个词时必须等待前N-1个词的计算完成,这使得训练速度极慢,且存在「长程依赖消失」问题——模型处理长文本时,早期词的信息会随距离增大而指数级衰减。LSTM通过引入「遗忘门」、「输入门」和「输出门」部分缓解了长程依赖问题,但串行瓶颈依然无法突破。Transformer的自注意力机制从根本上解决了这两个问题:任意两个位置之间的关联计算距离恒为1,且所有位置可并行计算,使得训练千亿参数模型成为工程可行而非理论幻想。
Transformer的核心创新——自注意力机制(Self-Attention)——的计算原理值得深入了解。每个词嵌入向量被线性变换为三个向量:查询向量Q(Query)、键向量K(Key)和值向量V(Value)。可以用图书馆检索来类比这三者的关系:Q是你向图书馆提出的"检索需求",K是每本书的"索引标签",V是书的实际内容;注意力机制通过计算你的需求Q与每本书索引K的匹配程度,决定从哪些书的内容V中提取信息。注意力分数通过Q与所有K的点积计算得出,经过Softmax归一化后,再对V加权求和,得到该词的上下文感知表示。这一机制让模型在处理每个词时,能同时"关注"句子中所有其他词的相关性权重——例如在句子"银行坐落在河边"中,模型能够通过注意力权重判断"银行"指的是河岸而非金融机构。
**多头注意力(Multi-Head Attention)**则通过并行运行多组注意力机制,让模型从不同的"语义子空间"同时关注不同类型的关联信息——例如一组注意力头专注于句法关系(主语与谓语的对应),另一组专注于指代消解("他"指的是哪个人物),再一组专注于情感极性(正面还是负面语义),多个视角叠加后共同构成该词最终丰富的上下文表示。Transformer的另一个革命性优势是高度并行化——不同于RNN必须串行计算,Transformer可以在GPU/TPU上大规模并行训练,这直接使得以千亿参数为单位的超大模型训练成为可能。
严格来说Transformer仍属于深度学习范畴,但采用了全新的注意力机制设计。目前主流大模型——无论是ChatGPT、DeepSeek还是绝大多数前沿模型,80%以上都基于Transformer或其变种进行训练。
对于应用开发者而言,深度学习和Transformer的内部机制完全可以当作"黑盒"看待。这里有一个重要的定位区分:学习"大模型应用开发",而非"开发大模型本身"。开发底层大模型需要深厚的数学和算法功底,门槛极高;而应用开发则是站在已有模型能力之上,聚焦解决真实业务场景中的问题——就像我们不需要研究电机原理,也能用它造出各种实用工具。
国内大模型格局一览
国产大模型进入百花齐放阶段,主要玩家及其特点如下:
- 阿里巴巴通义千问广告:Qwen Max版本综合能力强劲,被普遍认为处于国内第一梯队。
- 智谱清言(GLM):清华大学背景,技术积累深厚,实力不容小觑。
- 百度文心一言:多个技术节点均有布局,但未能形成持续的先发优势。
- 深度求索 DeepSeek:V3、R1等模型广为人知,开源生态影响力巨大。
- 腾讯混元:底层模型与豆包等应用产品协同发力。
- 科大讯飞星火、字节火山大模型等也各有差异化布局。
- 月之暗面 Kimi:K2 Thinking模型近期表现亮眼,与通义千问Max并列国内公开评测前列。
国际方面,谷歌Gemini、Anthropic Claude、OpenAI ChatGPT持续迭代,竞争激烈。
模型数量增多带来的一个直接利好是价格持续下探。大模型API的定价通常以"每百万Token"为单位计量,2023年至今,主流模型的调用成本已下降超过90%——GPT-3.5级别的能力,如今的调用费用仅为2023年初的几分之一。在这场用户争夺战的红利期内,普通用户和开发者能以更低成本调用强大的AI能力,对整个开发者生态而言是实实在在的利好。
结语:拥抱浪潮,还是被拍在沙滩上
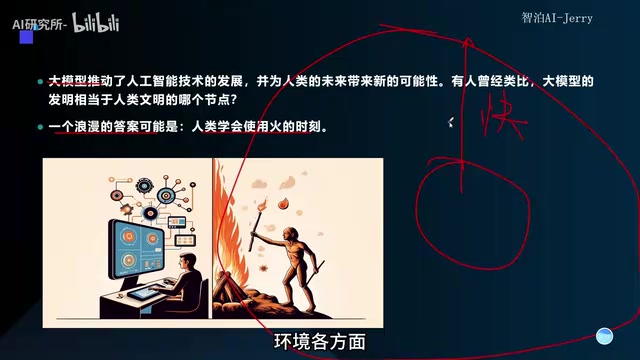
有一个令人印象深刻的比喻:大模型的出现之于人类,犹如学会使用火的那一刻——它打开了一片全新的可探索领域。在自然科学研究、抗癌药物分子筛选等前沿领域,人类往往缺的不是算力,而是方向感和快速验证的手段。大模型恰好能将我们受限于个人知识边界的探索范围,拓展到更广阔的维度。
无论通用人工智能最终能否实现,这股浪潮已真实地走进了千万企业与普通人的日常。对于每一个从业者而言,选择拥抱变化、主动入局,还是被时代的浪潮拍在沙滩上,正是当下需要做出的选择。
核心要点
相关推荐

Felix Rieseberg 个人主页
Felix Rieseberg 个人主页在 Hacker News 引发关注。本文介绍这位 Slack 工程师的技术背景、nativefier 项目的兴衰,以及开发者个人主页作为技术名片的价值。

@ai-sdk/vue 3.0.306 补丁发布 同步 [email protected] 更新
@ai-sdk/vue 3.0.306 发布,与 [email protected] 同步更新。这是 Vercel AI SDK 生态的一次常规补丁发布,无公开 API 变更,Vue 适配层保持与核心包版本对齐。

Gemini 4 Argon API发布:百万级输出Token时代来临
Google 正式发布 Gemini 4 Argon,稀疏 MoE 架构支持最高 100 万输出 token,Vals Index 以 68.90% 登顶,覆盖 API、AI Studio 和 Gemini 应用三端。