AI智能体入门:感知、决策与行动的核心闭环详解

从传统程序到智能体:一次范式的跃迁
近几年,智能聊天机器人、自动驾驶、智慧医疗等AI产品密集涌现。判断一个产品好不好用,本质上取决于其后端所采用的技术。如果背后是十几年前的老技术,用户体验往往被吐槽为「人工智障」;而如果采用了近年来兴起的 AI智能体(Agent)技术,好用的概率就会大幅提升。
AI智能体的概念最早可追溯至1990年代的多智能体系统研究(Multi-Agent System,MAS)。MAS起源于1980-1990年代的分布式人工智能领域,理论基础融合了博弈论、经济学机制设计与分布式计算,早期代表人物包括Yoav Shoham、Michael Wooldridge等人。核心思想是让多个具有自主性的智能体通过协作、竞争或协商共同完成复杂任务——早期典型应用包括机器人足球赛(RoboCup,自1997年起每年举办,推动了实时多智能体协作算法的发展)和分布式问题求解系统。然而彼时的"智能体"受限于算力与算法,距离真正理解自然语言的商业落地遥不可及。直到大语言模型(LLM)的突破,才真正具备了商业落地价值。2022年底ChatGPT的发布是一个关键转折点,它让公众第一次直观感受到「能理解意图」的AI。随后OpenAI于2023年6月推出Function Calling功能,允许开发者以结构化方式向模型描述外部函数,模型可在推理过程中决定是否触发调用——这一机制的深远意义在于:它为LLM装上了「手」,使其不再局限于文本生成,而能真正操控外部系统,标志着LLM从「对话工具」正式进化为「可执行任务的智能体核心」。值得一提的是,Function Calling并非孤立创新,而是建立在Transformer架构强大的结构化输出能力之上——该架构由Google Brain团队于2017年在论文《Attention Is All You Need》中提出,其自注意力机制(Self-Attention)赋予了模型对复杂指令格式的精确遵循能力,这正是结构化工具调用得以可靠运作的底层保障。值得补充的是,Transformer架构诞生后,研究者发现模型能力与参数量、训练数据量、计算量之间存在可预测的幂律关系,即「Scaling Law」(规模定律),由OpenAI于2020年在《Scaling Laws for Neural Language Models》中系统量化。这一发现直接驱动了GPT-3(1750亿参数)、GPT-4等超大规模模型的研发投入,并从理论层面解释了为何更大的模型普遍表现更好——这也是LLM能够成为智能体决策核心的规模基础。2024年OpenAI进一步将Function Calling升级为更通用的Tool Use规范,Anthropic、Google等主流厂商相继推出兼容接口,逐步形成跨平台的行业标准——其中2024年底Anthropic发布的**MCP(Model Context Protocol)**协议尤为值得关注:它定义了LLM与外部工具、数据源之间的通用通信协议,使不同厂商的工具可以被任意兼容MCP的模型调用,类似USB接口对硬件生态的统一作用,被业界视为Agent工具生态标准化的重要里程碑。与此同时,LangChain、AutoGPT、BabyAGI等框架相继涌现,进一步降低了智能体开发门槛,形成了以LLM为核心的全新软件开发范式。
那么,智能体究竟与传统程序有什么本质区别?
传统程序无论用 Java、Python 还是其他语言开发,都具备一个共同特征:固定的输入对应固定的输出。这就像自动售货机,你选定可乐、投入钱币,它就精确地给你一罐可乐——不会有任何变化,因为所有响应都是提前预设好的。
而智能体更像一个拥有思考能力的助手。当你给它一个模糊的需求,比如「5月1号我想去旅游」,它会主动分析当前城市、交通状况、节假日适宜的目的地,然后给出个性化推荐。它不再依赖精确指令,而是能够理解意图、动态决策。
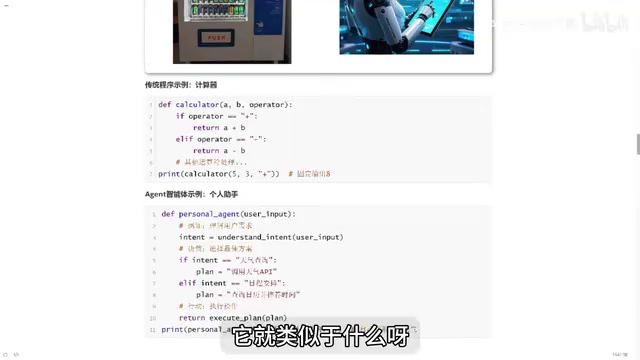
用代码来对比会更直观:传统的计算器函数接收数字 A、B 和操作符,输出结果与预期完全一致;而智能体函数只需传入「需求」,它会先理解用户想要什么(比如从「今天温度怎么样」识别出天气查询意图),再决定调用哪个工具来反馈结果。关键在于:输入是模糊的,输出是动态的。
AI智能体的三大核心能力闭环
智能体之所以「聪明」,源于它构建了一个完整的能力闭环:感知 → 决策 → 行动。这三者恰好对应人类的感官、大脑和手脚。
感知引擎:准确理解用户意图
感知引擎相当于人类的眼睛和耳朵,负责接收并理解外界输入。当用户说「帮我订一个便宜的酒店」时,智能体会自动拆解出三个关键要素:
- 动作:预定(而非立即执行)
- 对象:酒店
- 条件:低价
更重要的是,现代感知引擎不局限于文本。语音、文字、图像都可以作为输入——这就是所谓的多模态能力。多模态(Multimodal)指模型能够同时处理和理解多种类型的数据,包括文本、图像、音频、视频等。其底层实现依赖模态对齐技术:图像经过Vision Encoder(如ViT,即Vision Transformer,同样基于自注意力机制,将图像切割为固定大小的图块Patch后序列化处理)编码为图像Token,音频经过Whisper等模型转为文本或声学特征,最终与文本Token统一映射到同一语义空间。这一「统一语义空间」的概念至关重要——不同模态的信息被投影为同维度的向量表示,使模型可以跨模态进行注意力计算和语义推理,而非各自独立处理。OpenAI的CLIP模型是早期多模态对齐的里程碑,它通过对比学习(Contrastive Learning)让图文表示在向量空间中对齐:训练时将匹配的图文对拉近、不匹配的推远,最终使「一只猫的图片」和「一只猫」这段文字在向量空间中距离接近;GPT-4V、Gemini Ultra、Claude 3则在此基础上实现了真正的原生多模态推理。传统NLP模型只能处理文字,而多模态模型可以「看图说话」、「听音识意」,极大拓展了智能体的交互边界,使其能处理用户上传的截图、语音指令甚至视频片段。
决策大脑:基于大语言模型推理
感知之后,智能体需要判断「到底该怎么做」,这依赖于大语言模型(LLM) 的推理能力。GPT、DeepSeek广告、通义等都属于此类模型。
大语言模型(Large Language Model,LLM)是基于Transformer架构、在海量文本数据上预训练的神经网络模型。Transformer的核心创新——多头自注意力机制(Multi-Head Self-Attention)——允许模型在处理每个词时动态关注序列中所有其他词的信息,突破了此前RNN架构只能顺序处理的瓶颈,使训练可以高度并行化,进而支撑起千亿乃至万亿参数规模的扩展。LLM的「推理」能力并非人类意义上的逻辑推理,而是通过对训练数据中语言模式的统计学习,预测在给定上下文中最合适的下一个词(Token)。GPT-4拥有约1.8万亿参数,DeepSeek-V3约有6710亿参数。这种「下一词预测」机制在规模足够大时,会涌现出类似推理、规划、代码生成等高阶能力——这被称为「涌现现象」(Emergent Abilities)。
涌现现象并非线性进步,而是质的飞跃:Google DeepMind 2022年的研究论文《Emergent Abilities of Large Language Models》系统记录了这一现象,约在千亿参数规模附近,模型突然展现出此前小模型完全不具备的思维链推理、多步数学解题等能力。这一现象与前述Scaling Law形成呼应——规模定律预测了能力的连续提升,而涌现现象则描述了在特定规模阈值处能力的突变式跃升,两者共同构成了理解LLM能力边界的理论框架。值得注意的是,涌现现象的产生机制至今仍有争议——部分研究者认为这是真实的相变(Phase Transition),另一些学者(如斯坦福2023年的反驳论文)则认为涌现是评估指标选择导致的「测量假象」,换用平滑指标后能力提升其实是连续的。无论如何,这一争论本身也说明了LLM能力边界研究的深度与复杂性。涌现能力正是LLM成为智能体决策大脑的根本原因,它们负责理解、推理与内容生成,决定接下来应当调用哪些函数或工具。
在实践中,智能体的决策流程通常借助Chain-of-Thought(思维链,CoT)和ReAct框架来结构化。CoT由Google Brain 2022年提出,通过在Prompt中引导模型「一步步思考」,显著提升复杂推理任务的准确率;而ReAct(Reasoning + Acting)框架则将推理与工具调用交织在一起,让模型在每次行动前先输出思考过程,行动后观察结果再决定下一步,形成「思考→行动→观察」的迭代循环。这一模式已成为LangChain Agent、AutoGPT等主流框架的核心执行范式,使智能体能够在复杂多步任务中保持逻辑连贯性。
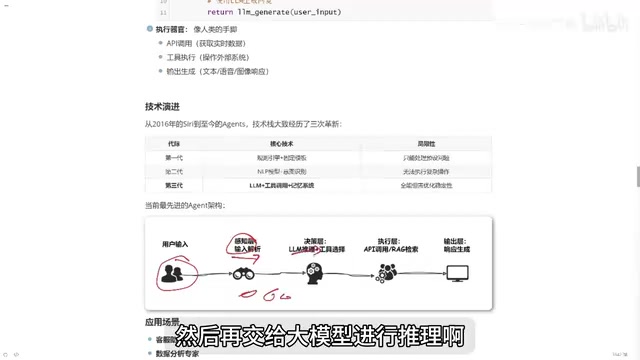
执行层:调用工具完成任务
当大脑分析出该给用户返回什么内容后,执行层就开始「干活」——它像人类的手脚,负责调用具体的 API、数据库甚至硬件设备,生成最终结果并反馈给用户。
三代技术演进:从Siri到现代Agent
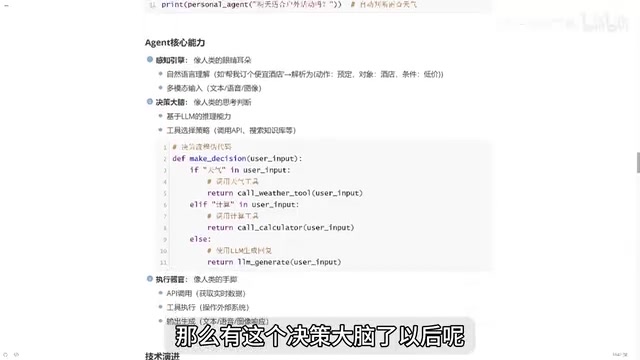
回顾语音助手的发展历程,AI智能体技术大致经历了三代演进。
第一代:规则引擎 + 固定模板
以早期的 Siri 为代表。你问「现在几点了」,它能准确回答;但只要换个说法,比如「能帮我把时间调整一下吗」,它就会回复「对不起,我听不懂你的指令」。这类产品只认预设指令,稍有偏差就无法识别。目前市面上部分智能音箱仍停留在这个阶段。
第二代:NLP模型 + 意图识别
第二代产品能初步理解用户需求,不会因为换个说法就失效。自然语言处理(NLP)中的意图识别(Intent Recognition)是这一代的核心技术,典型代表框架包括Google的Dialogflow和Facebook的wit.ai,它们采用「槽位填充」(Slot Filling)机制:先识别意图类别(如「查天气」「设闹钟」),再从句子中抽取实体填入预定义槽位(如城市、日期)。早期常用SVM、随机森林等传统机器学习方法,后来演进为BERT等预训练模型的微调方案,识别准确率大幅提升。BERT(Bidirectional Encoder Representations from Transformers,2018年由Google提出)是将Transformer应用于NLP下游任务的重要里程碑,其双向编码能力使模型能同时考虑一个词左右两侧的上下文,在意图分类、命名实体识别等任务上大幅超越前代方法,奠定了「预训练-微调」范式的主流地位,直接推动了第二代智能体产品的成熟。
然而,意图识别的根本局限在于:它依赖人工预定义的意图库,系统本质上是封闭域的,一旦用户表达超出覆盖范围,系统就会失效。这也解释了第二代产品的典型缺陷——缺乏记忆系统:当你先问「今天天气怎么样」,再问「今天适合出去玩吗」,它无法关联上一轮对话,每次交互都是全新会话。
第三代:大模型 + 工具调用 + 记忆系统
这是当前主流的智能体架构。第三代方案彻底抛弃了预定义意图库,LLM可以开放域地理解任意表达,正是这一点使其全面取代了第二代方案。无论问题多模糊、多刁钻,它都能通过大语言模型分析出真实需求,调用对应工具(包括程序内置函数、数据库、摄像头等外部资源),并且具备持续记忆能力,能够在前一步的基础上连续执行任务,交互体验更加完整流畅。
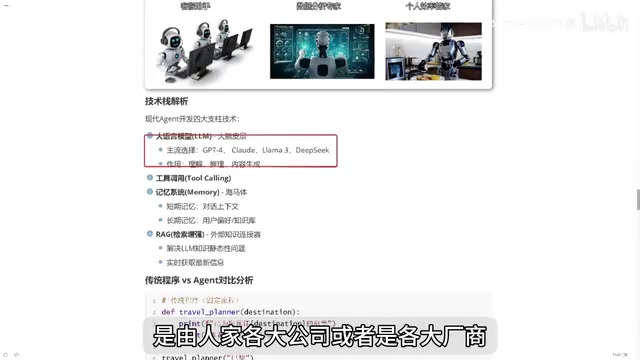
现代智能体的完整工作流程为:用户输入需求 → 感知识别关键词 → 大模型推理选择工具 → 执行层调用API或RAG数据库 → 生成结果并返回。
技术栈解析:构建AI智能体的四大支柱
如果你想动手开发一个 AI 智能体,需要掌握以下四项核心技术:
-
大语言模型(LLM):作为「决策大脑」,负责理解、推理与内容生成。GPT-4、Claude、DeepSeek 等均属此类。其涌现能力是智能体智能的根本来源。现代主流LLM普遍采用「预训练 + RLHF(基于人类反馈的强化学习)」的训练范式:预训练阶段在万亿Token级语料上学习语言规律,RLHF阶段则通过人类偏好标注数据训练奖励模型,再用强化学习对LLM进行对齐微调,使其输出更符合人类价值观与指令意图——这正是ChatGPT相比纯预训练GPT-3显著「更听话」的根本原因。值得补充的是,2024年兴起的**推理时扩展(Test-Time Compute Scaling)**技术(以OpenAI o1、DeepSeek-R1为代表)进一步延伸了这一范式:模型在推理阶段通过大量内部「思考」步骤(通常以Chain-of-Thought形式呈现)换取更高质量的输出,使LLM在数学竞赛、代码生成等需要深度推理的任务上取得了质的突破,也为智能体处理复杂多步决策任务提供了更强大的底层能力。
-
工具调用(Tool Calling):大模型确定执行方向后,通过调用外部工具完成具体任务,开发者无需手动编写全部逻辑。工具调用的工作原理是:开发者预先向模型描述可用工具的名称、功能和参数格式(通常为JSON Schema),当用户提问时,模型判断是否需要调用工具,若需要则输出结构化的调用指令,由外部代码实际执行后将结果返回给模型,模型再据此生成最终回复。JSON Schema在此扮演了至关重要的「合同」角色——它以标准化的机器可读格式定义了工具的输入输出规范,使模型生成的调用参数可被直接解析执行,同时也使工具接口具备跨模型、跨框架的互操作性。这一机制使LLM从「只会说话」变成「能干活」,是连接AI与现实世界的核心桥梁,也是构建实用AI智能体的关键技术之一。在多智能体场景中,工具调用还可以延伸为「Agent调用Agent」——一个编排层Agent(Orchestrator)将复杂任务拆解后,通过工具调用接口将子任务分派给专职子Agent(如搜索Agent、代码执行Agent、文件处理Agent),各子Agent并行执行后汇总结果,这种模式被称为Multi-Agent协作架构,是处理超复杂任务的主流工程方案。这一架构与1990年代MAS研究中的「任务分解与协商」思想一脉相承,只是底层智能体从规则驱动升级为了LLM驱动。
-
记忆系统(Memory):相当于「海马体」,负责记住之前的操作上下文,确保多步任务的连贯性。记忆系统通常分为四类:短期记忆(当前对话的上下文窗口,受Token限制,通常4K-200K不等,类似RAM,容量有限但访问极快)、长期记忆(持久化存储到向量数据库,如Pinecone、Chroma、Milvus,供跨会话语义检索,类似硬盘,容量大但需要检索)、实体记忆(专门记录特定人物、事项的结构化信息)以及程序记忆(从历史交互中学习到的操作习惯)。
向量数据库的工作原理值得单独说明:其基础是Embedding(嵌入)技术——将离散的文本、图像等数据映射为连续高维向量,语义相近的内容在向量空间中距离也相近。主流Embedding模型包括OpenAI的text-embedding-3-large(输出3072维向量)、开源的BGE-M3(支持中英双语,单向量1024维)等。历史对话或知识文档经Embedding模型转换后,向量数据库利用HNSW(层次化可导航小世界图)等近似最近邻算法,在毫秒级完成对百万量级向量的语义相似度检索——这一能力使「找到语义相近的历史记录」成为可能,而传统关键词索引对语义相似但用词不同的内容则完全无能为力。当对话历史超出模型Token限制时,需采用摘要压缩、滑动窗口或分层检索等工程策略,这是保障智能体长程连贯性的核心挑战之一。
-
RAG(检索增强生成):针对训练数据时效性不足和模型「幻觉」(Hallucination)两大问题,RAG由Facebook AI Research于2020年提出。幻觉问题的本质根源在于LLM的生成机制——模型始终在预测「概率最高的下一个词」,当训练数据中缺乏相关知识时,模型会生成听起来合理但实际错误的内容,这在医疗、法律、金融等高精度场景中是不可接受的风险。RAG通过「先检索、后生成」的架构从根本上缓解了这一问题。其工作流程分为两阶段:首先将用户问题转换为向量(Embedding,常用text-embedding-ada-002或BGE等模型),在外部知识库中通过近似最近邻搜索(ANN,如HNSW算法)进行语义相似度匹配,召回最相关的文档片段;然后将这些文档作为上下文拼接到Prompt中,让LLM基于真实资料生成回答,而非凭空捏造。
在工程实践中,文档分块策略是RAG落地的关键挑战之一:切分粒度直接影响检索质量,过大的块导致噪声干扰,过小的块则丢失上下文语义。主流方案包括固定大小分块(Fixed-size chunking)、语义分块(Semantic chunking)和递归字符分块(Recursive character splitting,LangChain默认方案)。进阶方案还包括HyDE(假设文档嵌入,先让LLM生成假设答案再用其向量检索,提升召回率)、重排序(Reranker,用交叉编码器对粗召回结果精排,常用BGE-Reranker、Cohere Rerank等模型)、多路召回融合(同时使用向量检索与BM25关键词检索,通过RRF算法融合结果以兼顾语义相似度与词汇精确匹配),以及微软2024年提出的GraphRAG(通过构建知识图谱替代纯向量检索,在需要多跳推理的复杂问答场景中表现显著优于传统RAG)等技术以提升检索精度。相比直接微调模型,RAG不仅知识库可实时更新、成本极低,还能提供信息溯源——每条回答都可追溯到具体原始文档,满足金融、医疗等高合规场景的审计需求,是目前企业级AI应用最主流的知识增强方案。
典型应用场景
AI 智能体的落地场景相当广泛:
- 智能客服助手:相比早期死板的机器人回复,现代智能客服回答更自然,能灵活应对各类咨询场景。
- 数据分析助手:将数据直接交给智能体,它可自动完成常见分析,也支持按需定制分析任务。
- 个人效率管家:例如「明早9点提醒我提交报告并推荐通勤路线」,智能体会拆解为两个子任务——创建日历事项、查询实时交通,分别执行。
小结
理解 AI 智能体,关键在于抓住两点:一是它与传统程序的本质区别——固定输入固定输出 vs. 动态感知动态响应;二是它的核心能力闭环——感知负责理解需求,决策负责分析该做什么,行动负责执行并反馈结果。
在技术栈层面,大语言模型、工具调用、记忆系统与 RAG 共同构成了现代 Agent 的骨架。其中LLM的涌现能力是智能的来源,工具调用是连接现实世界的桥梁,记忆系统保障了任务的连贯性,而RAG则解决了知识时效与准确性的问题。这四大支柱相辅相成,缺一不可——没有LLM,就没有开放域的理解能力;没有工具调用,智能体只能「说」不能「做」;没有记忆系统,多步任务将支离破碎;没有RAG,模型将困于训练数据的时效边界之内。值得一提的是,这四大支柱并非孤立运作,而是在Transformer这一统一架构基础上协同工作:LLM提供推理核心,工具调用扩展其行动边界,记忆系统和RAG则分别从时序连贯性和知识准确性两个维度弥补LLM的固有局限。此外,Scaling Law与涌现现象共同构成了理解LLM能力边界的理论框架,Chain-of-Thought与ReAct等推理框架、MCP等标准化协议、Multi-Agent协作架构,共同构成了围绕这四大支柱的工程实践生态。掌握这套认知框架,是进入 LangChain、Agent 开发实战的坚实第一步。
核心要点
核心要点
相关推荐

AI+SRC自动化挖洞实战:用AI智能体重构漏洞挖掘三步法
本文详解AI+SRC自动化漏洞挖掘的完整思路,对比传统挖洞三步法与AI智能体加持后的变化,涵盖资产盘点、误报筛选、报告生成及AI Agent选型要点,助你高效入门SRC漏洞挖掘。

实测DeepSeek桌面Agent:0.35美元自动生成视频
海外博主实测DeepSeek桌面Agent(DeepSeek Harness):仅0.35美元自动生成完整视频,设置每日自动简报,两分钟从大白话构建可运行App。三项任务全部完成仅花0.59美元,附详细表现与成本分析。

Antigravity 2.0 保姆级教程:MCP、Skill与自动化全解析
Antigravity 2.0 保姆级教程,详解项目/会话/Agent 三大核心概念、消息队列与权限设置、自动化任务、MCP 连接 Figma、Skill 专业技能,并演示设计稿转代码、Android 应用生成、产品页 1:1 复刻等 6 个实战案例。