强化学习入门指南:从零到RLHF的完整学习路线图

为什么强化学习值得深入学习
在机器学习的三大范式中,强化学习(Reinforcement Learning, RL)往往是最令人望而生畏的一个分支。与监督学习依赖标注数据、无监督学习挖掘数据内在结构不同,强化学习让智能体(Agent)通过与环境的持续交互、试错和奖励反馈来学习最优策略。
从根本上说,三大范式的区别在于学习信号的来源和性质。监督学习从人工标注的输入-输出对中学习映射关系;无监督学习从无标签数据中发现聚类、降维等隐含结构;而强化学习的学习信号是延迟的、稀疏的标量奖励。这种差异决定了强化学习面临独特的挑战:信用分配问题(一个奖励信号该归功于哪些历史决策)和探索-利用困境(是尝试新策略还是坚持已知的好策略)。
信用分配问题(Credit Assignment Problem)是强化学习中最根本的挑战之一。想象一盘围棋,最终的胜负结果(奖励)需要追溯到几百步之前的每一个决策——哪些布局是关键的好棋,哪些是无关紧要的过渡手,哪些又是导致败局的坏棋?这种将最终奖励信号正确"归因"到各个历史决策的问题,在计算上极为困难。探索-利用困境(Exploration-Exploitation Dilemma)则源于信息不完备:智能体已知某策略能获得不错的回报(利用),但可能存在更优的未知策略(探索)。过度探索导致累积奖励不足,过度利用则可能陷入局部最优。经典的多臂老虎机问题是这一困境的最简化模型,而ε-greedy、UCB、Thompson Sampling等策略都是对这一困境的不同解法。正是这些根本性的难题,使得 RL 的算法设计思路与其他两大范式截然不同。
随着 RLHF(基于人类反馈的强化学习)成为大语言模型对齐的核心技术,越来越多的从业者开始意识到:想要真正理解现代 AI 的训练机制,绕不开强化学习这一关。RLHF 是 OpenAI 在 InstructGPT 和 ChatGPT 中采用的核心对齐技术。传统的语言模型通过最大化下一个 token 的预测概率进行预训练,但这种目标函数并不直接优化"有用性"或"安全性"。RLHF 的核心思路是:首先让人类标注者对模型的多个输出进行偏好排序,用这些偏好数据训练一个奖励模型(Reward Model),然后以该奖励模型的输出作为奖励信号,通过 PPO 等强化学习算法微调语言模型的策略。这一范式使得模型行为可以朝着人类期望的方向对齐,而无需为每个期望行为提供精确的监督标签。
奖励模型(Reward Model)的训练是RLHF流程中承上启下的关键环节。它本质上是一个将人类偏好数学化的过程。具体而言,给定同一个提示(prompt),让语言模型生成多个候选回答,人类标注者对这些回答进行偏好排序。然后使用Bradley-Terry模型等排序学习框架,训练一个神经网络来预测任意两个回答之间的人类偏好概率。训练好的奖励模型接收一个(prompt, response)对作为输入,输出一个标量分数,代表该回答符合人类期望的程度。这个标量分数随后作为PPO的奖励信号,指导语言模型的策略优化。奖励模型的质量直接决定了RLHF的上限。
近期一位 Reddit 用户提出了一个非常典型的问题:"我已经掌握了基础的机器学习和深度学习知识,想在进入 RLHF 之前深入学习 RL,有没有好的书籍或资源推荐?"这个问题看似简单,却道出了许多初学者的真实困境——RL 领域资源繁杂,缺乏一条清晰的学习路径。本文将围绕这一需求,梳理一份系统化的强化学习入门路线图。
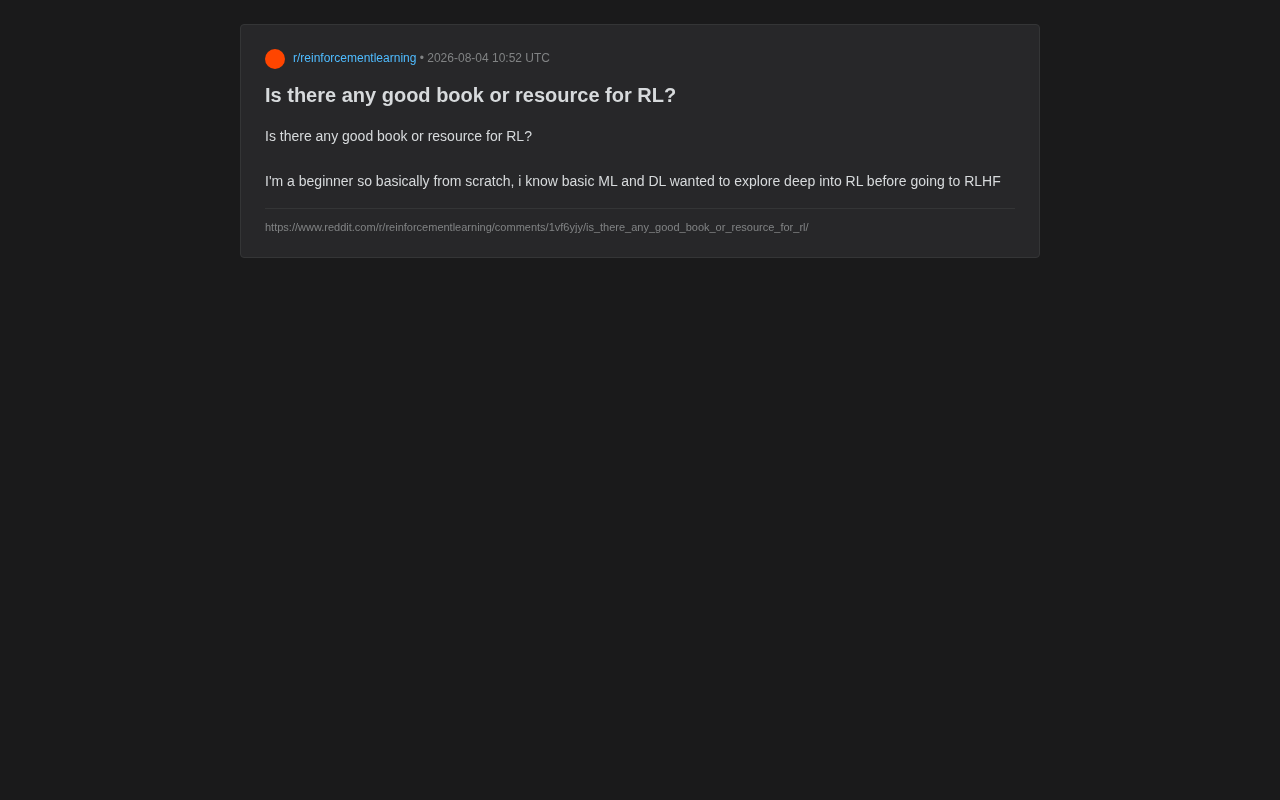
强化学习的知识体系与学习目标
先厘清你的学习目标
在开始堆砌资源之前,明确学习目标至关重要。对于"最终想进入 RLHF"的学习者而言,学习路径与纯粹想做机器人控制或游戏 AI 的人会有所不同。RLHF 建立在策略梯度(Policy Gradient)、PPO(近端策略优化)等算法之上,因此在打基础阶段,不必在动态规划、蒙特卡洛方法上过度纠缠,但这些经典理论仍是理解现代算法的必要台阶。
RL 的核心概念分层框架
强化学习的知识体系可以大致分为三层:
- 基础理论层:马尔可夫决策过程(MDP)、贝尔曼方程、价值函数、策略函数等核心概念。
- 经典算法层:动态规划、蒙特卡洛方法、时序差分学习(TD Learning)、Q-Learning、SARSA。
- 深度强化学习层:DQN、策略梯度方法、Actor-Critic、PPO、SAC 等,这一层直接连接到 RLHF。
在基础理论层中,马尔可夫决策过程(MDP)是整个强化学习的数学基础框架,由五元组 (S, A, P, R, γ) 定义:S 是状态空间,A 是动作空间,P 是状态转移概率函数,R 是奖励函数,γ 是折扣因子。MDP 的核心假设是马尔可夫性质——未来状态仅依赖当前状态和动作,与历史无关。贝尔曼方程则描述了价值函数的递归关系:当前状态的价值等于即时奖励加上折扣后的后继状态期望价值。这一方程是动态规划、Q-Learning 等几乎所有经典 RL 算法的理论基石。
在经典算法层中,Q-Learning和SARSA代表了两种根本不同的学习策略。Q-Learning是离策略(off-policy)方法,它在更新Q值时总是假设未来会采取最优动作(贪心),无论实际行为策略如何;SARSA则是在策略(on-policy)方法,它基于实际执行的动作来更新Q值。这一区别导致了重要的实际差异:Q-Learning更激进,可能学到更优但更冒险的策略;SARSA更保守,会考虑探索策略带来的风险。理解on-policy与off-policy的区别,是后续理解DQN(off-policy)与PPO(on-policy)等深度RL算法设计选择的前提。
在深度强化学习层中,Actor-Critic 是一类结合了策略梯度(Actor)和价值函数估计(Critic)优势的混合算法架构。Actor 负责根据当前策略选择动作,Critic 负责评估当前状态或状态-动作对的价值。Critic 的价值估计用于计算优势函数(Advantage Function),即某个动作相对于平均表现的好坏程度,从而显著降低策略梯度估计的方差。PPO、A3C、SAC 等现代深度 RL 算法都建立在 Actor-Critic 框架之上。理解这一架构是从经典 RL 过渡到深度 RL 的关键认知跳板。
SAC(Soft Actor-Critic)是2018年由UC Berkeley的Tuomas Haarnoja等人提出的离策略(off-policy)深度强化学习算法。它的核心创新在于引入了最大熵框架(Maximum Entropy Framework),即在最大化累积奖励的同时,也最大化策略的熵(随机性)。这意味着智能体不仅追求高回报,还倾向于保持行为的多样性和探索性。SAC在连续动作空间的控制任务(如机器人关节控制、自动驾驶)中表现出色,因为其天然的探索能力和训练稳定性。与PPO相比,SAC作为离策略算法具有更高的数据效率,但PPO在分布式训练和离散动作空间中更常被选用。
理解这个分层结构,能帮助初学者知道自己"学到哪一步了",避免在浩瀚的资源中迷失方向。
强化学习核心书籍与课程推荐
圣经级教材:Sutton & Barto《Reinforcement Learning: An Introduction》
谈到强化学习的入门书籍,Richard Sutton 和 Andrew Barto 合著的《Reinforcement Learning: An Introduction》几乎是所有人的首选推荐。这本书被业界称为"RL 圣经",其第二版可以免费在线获取。它系统地讲解了从 MDP 到时序差分、从表格型方法到函数逼近的完整脉络。
值得一提的是,Richard Sutton本人是强化学习领域的奠基人之一,他在1988年提出的时序差分学习(TD Learning)方法奠定了现代RL的基础。Sutton还是"富环境假说"(The Bitter Lesson)的提出者,他在2019年的同名文章中指出,AI研究的历史反复证明:利用大规模计算的通用方法最终总会胜过依赖人类领域知识的专门方法。这一观点深刻影响了后来大模型时代的研究方向。
对于初学者来说,这本书的优点是理论严谨、循序渐进;缺点是数学推导较多,且对深度学习部分着墨不足。建议的读法是:不必逐字啃完,重点掌握前 6-7 章的核心概念,建立对价值函数和策略的直觉理解,后续章节可作为参考手册按需查阅。
深度强化学习实践资源
由于学习者已具备深度学习基础,可以在打好经典 RL 理论后,快速转向深度强化学习(Deep RL)。以下是几个高质量资源:
- OpenAI Spinning Up:一份免费的开源教程,专为想入门深度强化学习的人设计,涵盖 VPG、TRPO、PPO、DDPG、SAC 等主流算法,并附带清晰的代码实现。对于目标是 RLHF 的学习者尤其友好,因为 PPO 正是 RLHF 的核心算法。Spinning Up的一大特色是其"关键论文列表",精选了约100篇深度RL领域最重要的论文,按主题分类并附有简短说明,为学习者提供了从教程到前沿研究的清晰过渡路径。
- David Silver 的 RL 公开课:DeepMind 研究员、AlphaGo 核心人物 David Silver 的系列讲座是许多人的启蒙课程,讲解生动,配合 Sutton & Barto 阅读效果更佳。这门课程共10讲,从MDP基础到策略梯度再到模型-based RL,覆盖面完整。Silver本人参与了AlphaGo、AlphaZero和AlphaFold等里程碑项目,他的讲解中融入了大量来自实际研究的洞察和直觉,这是纯理论教材难以提供的。
- Hugging Face Deep RL Course:一门免费的实战型课程,边学边练,最后甚至能引导学习者理解 RLHF 的原理,与最终目标高度契合。该课程的独特之处在于它与Hugging Face的TRL(Transformer Reinforcement Learning)库紧密集成,TRL正是目前开源社区中实现RLHF最流行的工具库之一,学完课程后可以无缝过渡到RLHF的实际开发。
从强化学习到 RLHF 的进阶路径
打通经典理论与前沿应用的桥梁
RLHF 本质上是将强化学习应用于语言模型微调的技术。它的技术栈可以拆解为:奖励模型(Reward Model)的训练 + PPO 算法的策略优化。因此,扎实掌握 PPO 是通向 RLHF 的关键跳板。
PPO(Proximal Policy Optimization,近端策略优化)由 OpenAI 的 John Schulman 于 2017 年提出,是目前应用最广泛的策略梯度算法之一。它解决了早期策略梯度方法(如 REINFORCE)的高方差问题和 TRPO(信赖域策略优化)计算复杂度过高的问题。PPO 的核心思想是通过裁剪(clipping)目标函数来限制每次策略更新的幅度,确保新策略不会偏离旧策略太远。具体来说,它使用一个概率比率 r(θ) = π_θ(a|s) / π_θold(a|s),并将其裁剪在 [1-ε, 1+ε] 范围内。这种简单而有效的约束机制使 PPO 在实践中既稳定又高效,成为 RLHF 中微调语言模型的标准选择。
从TRPO到PPO的演进体现了深度RL领域的一个重要设计哲学。TRPO(Trust Region Policy Optimization,信赖域策略优化)由John Schulman于2015年提出,它通过约束每次策略更新的KL散度不超过一个阈值δ,确保策略单调改进。然而TRPO需要计算和求逆Fisher信息矩阵,涉及二阶优化方法(共轭梯度法),实现复杂且计算开销大。PPO的出现正是为了在保留TRPO的稳定性保证的同时,大幅简化实现。PPO通过一阶优化(简单的梯度下降)配合裁剪机制,用极低的实现复杂度达到了与TRPO相近甚至更优的性能。这种"用工程简洁性换取理论优雅性"的实用主义设计哲学,使PPO成为工业界最受欢迎的RL算法。
建议的学习顺序是:先通过 Sutton & Barto 理解价值函数与策略梯度的数学本质,再通过 Spinning Up 亲手实现 PPO,最后阅读 InstructGPT 论文和相关的 RLHF 技术博客,将 RL 算法与语言模型的实际应用连接起来。
InstructGPT(2022 年,Ouyang et al.)是 RLHF 技术在大规模语言模型上的标志性应用。论文详细描述了三阶段训练流程:第一阶段用人类标注者编写的高质量回答进行监督微调(SFT);第二阶段收集人类对模型输出的偏好排序数据,训练奖励模型;第三阶段用 PPO 算法优化语言模型策略,同时加入 KL 散度惩罚项防止策略偏离 SFT 模型太远。这篇论文不仅是理解 ChatGPT 训练机制的必读文献,也是将 RL 理论知识与 LLM 实际应用连接起来的最佳桥梁。
在RLHF的PPO优化阶段,KL散度(Kullback-Leibler Divergence)惩罚项扮演着至关重要的角色。KL散度是信息论中衡量两个概率分布差异的非对称度量。在RLHF语境下,它测量当前策略模型的输出分布与监督微调(SFT)模型输出分布之间的偏离程度。加入KL惩罚的原因是:如果不加约束,PPO优化可能导致模型过度迎合奖励模型的偏好(reward hacking),生成高分但不自然、不通顺甚至语义退化的文本。KL惩罚确保模型在追求更高奖励的同时,不会偏离其基础语言能力太远,从而维持输出的流畅性和多样性。
值得关注的是,RLHF之后,学界又提出了多种替代方案。DPO(Direct Preference Optimization,2023年)绕过了显式训练奖励模型和运行PPO的步骤,直接通过偏好数据优化策略,大幅简化了训练流程。GRPO(Group Relative Policy Optimization)等方法则进一步探索了不同的优化范式。了解这些后续发展有助于学习者在掌握RLHF基础后,跟进最新的技术演进方向。
动手实践:搭建你的强化学习实验环境
强化学习是一门极其依赖实践的学科。仅仅阅读书籍和观看视频远远不够,因为 RL 训练过程中充满了调参陷阱、奖励设计难题和收敛不稳定等实际问题。推荐初学者尽早使用 Gymnasium(原 OpenAI Gym)搭建实验环境,从 CartPole 这样的简单任务入手,逐步过渡到更复杂的场景。
Gymnasium(2022 年从 OpenAI Gym 分支出来,由 Farama Foundation 维护)是强化学习研究的标准实验平台。它提供统一的 API 接口来定义环境的观察空间、动作空间、状态转移和奖励机制,使得算法研究者可以在不同环境间无缝切换。经典的 CartPole 任务要求智能体通过左右移动小车来平衡倒立摆,虽然状态空间仅有 4 维(位置、速度、角度、角速度),但它完整体现了 RL 的核心要素:序列决策、延迟奖励和不稳定动态系统控制。从 CartPole 逐步过渡到 Atari 游戏、MuJoCo 物理仿真等复杂环境,是建立深度 RL 实践经验的典型路径。
Stable-Baselines3(SB3)是基于PyTorch实现的强化学习算法库,由DLR(德国航空航天中心)的研究团队维护。它提供了PPO、SAC、TD3、A2C、DQN等主流算法的经过充分测试和调参的实现版本。SB3的设计理念是"可靠性优先":每个算法都经过严格的基准测试验证,确保在标准环境下能复现论文报告的性能。对于初学者而言,SB3的价值在于提供了一个"已知正确"的参考实现——当你自己从头实现PPO但结果不收敛时,可以对照SB3的代码排查bug。此外,SB3的模块化设计使得研究者可以方便地替换网络结构、修改奖励函数或添加自定义回调,适合从学习到研究的过渡阶段。
学习建议与常见误区
避免"资源囤积"陷阱
面对丰富的学习资源,初学者最容易犯的错误是同时开启多本书、多门课,结果每个都浅尝辄止。更有效的策略是选定一本主教材(如 Sutton & Barto)+ 一门实战课程(如 Spinning Up 或 Hugging Face 课程),坚持完成,再横向拓展。
数学基础的重要性
强化学习对概率论、线性代数和微积分有一定要求,尤其是策略梯度部分涉及大量期望和梯度计算。策略梯度定理的核心表达式 ∇J(θ) = E[∇log π_θ(a|s) · Q(s,a)] 涉及对策略参数的梯度、对数概率和期望值运算,理解这一公式需要扎实的概率论基础(期望、条件概率)和微积分功底(链式法则、对数求导)。如果在阅读中遇到障碍,及时补充相关数学知识,往往比硬着头皮往下读更有效率。
这个公式的直觉理解是:它告诉我们如何调整策略参数θ以增加期望回报。∇log π_θ(a|s)指示了"使动作a在状态s下更可能被选择"的参数调整方向,而Q(s,a)则作为权重,确保我们更多地增加好动作的概率、减少差动作的概率。这种"对数技巧"(log-trick)将难以直接求导的期望奖励问题,转化为了可以通过采样估计的梯度计算,是策略梯度方法的数学核心。
调参与工程实践中的常见陷阱
强化学习的训练不稳定性是初学者最常遇到的挫折来源。与监督学习中损失函数通常单调下降不同,RL的训练曲线经常剧烈波动甚至突然崩溃。常见的工程陷阱包括:奖励尺度不当导致梯度爆炸或消失、经验回放缓冲区大小设置不合理、折扣因子γ选择不当导致短视或过度延迟、以及并行环境数量对PPO训练稳定性的影响等。建议初学者养成记录实验日志的习惯,使用Weights & Biases或TensorBoard等工具可视化训练过程,这对于诊断问题至关重要。
总结:一条清晰的强化学习入门路线
对于已有机器学习和深度学习基础、目标是 RLHF 的学习者而言,一条清晰的路径是:从 Sutton & Barto 建立理论根基 → 通过 David Silver 课程巩固直觉 → 用 Spinning Up 或 Hugging Face 课程动手实现深度 RL 算法 → 最终切入 RLHF 相关论文与实践。强化学习的学习曲线陡峭,但一旦跨越,你将获得理解现代 AI 系统训练机制的钥匙。保持耐心,多写代码,才是掌握强化学习的不二法门。
核心要点
核心要点
相关推荐

Codex入门指南:OpenAI编程智能体与ChatGPT有何不同
Codex是OpenAI推出的AI编程智能体,能自主阅读、修改代码并执行测试。本文解析Codex与ChatGPT的核心区别,以及开发者为什么要学习这类AI编程工具。

Gemini Agent发布:Argon模型太强不敢放出,AI圈新动态盘点
Google发布办公通用智能体Gemini Agent,支持Gemini 4 Argon与Claude Opus 5.5,但Argon因太强暂不开放。本文盘点Odyssey 3世界模型、OpenAI营收、Arena融资等一周AI圈动态。

Sophos借OpenAI Daybreak把威胁响应时间压缩96%
Sophos首席技术官披露,借助OpenAI Daybreak项目和自研安全智能体,其MDR业务平均威胁响应时间从38分钟压缩至89秒,降幅达96%。本文解析其规划-执行-观察闭环架构及AI护栏松绑的意义。