从零手搓 AI Agent:用 Python 搞懂智能体底层原理

抛开复杂框架,用"LLM+Tools+Loop"公式手撸极简Agent,彻底搞懂智能体底层机制。
本文由一位B站UP主的视频内容整理而来,核心主张是:与其死啃随时过时的框架API,不如先自己动手搭建一个极简Agent引擎来理解底层原理。文章将智能体的本质浓缩为"Agent = LLM + Tools + Loop"三元公式,分别对应决策、行动与任务推进三个维度。工具的本质是一份用JSON Schema写成的详细菜单;安全边界方面,必须禁止模型直接执行Shell/SQL,用白名单拦截并将报错回传给模型以实现自我修正。核心循环引擎由"请求模型→检查动作→执行工具→记录历史"四步构成,并须设置Max Steps上限防止死循环烧光API额度。最终建议的成长路径是:先手撸原生代码吃透原理,再借助LangChain等重型框架提升生产效率。
抛开框架,重新认识真正的 Agent
打开任何一份主流 AI 框架(如 LangChain)的架构图,密密麻麻的连线和抽象概念往往让人望而生畏——像一盘乱七八糟的意大利面。但这位 B 站 UP 主的观点很直接:框架肯定会变,API 每天都在更新,唯有底层机制永远不变。想真正搞懂智能体,最快的捷径是无视复杂框架,自己手撸一个极简引擎。
那么,普通大模型和 AI Agent 的分水岭在哪里?普通大模型像一个泡在玻璃罐里的超级大脑:你提问,它回答,任务结束——这是一次性的单线任务。而真正的 Agent 拥有思考过程和多步判断能力,它会主动琢磨「我是不是需要调用某个工具来解决这个问题」,去查资料、做算术、拿到结果后再综合判断,直到得出最终答案。
用一句话概括:Agent 就是一个长出了手和脚、并且能进行自我反思的大脑。
核心超级公式:Agent = LLM + Tools + Loop
整个智能体世界最底层的基石,可以浓缩成一个公式:
Agent = LLM + Tools + Loop
- LLM(大模型):负责思考与决策;
- Tools(工具):负责跟外部世界交互、采取行动;
- Loop(循环):负责持续推进任务,直到最终完成。
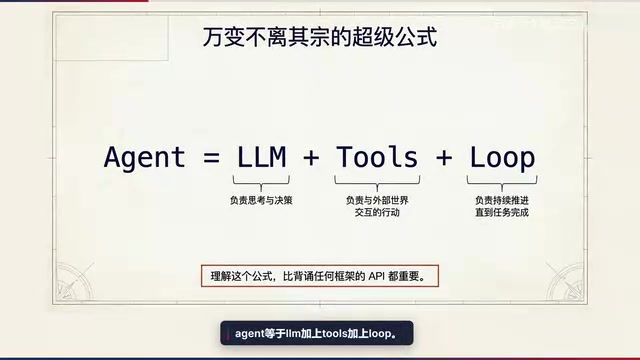
作者强调,死死记住这个公式,比熬夜去背任何三天两头就废弃的框架 API 语法有价值得多。有了公式,开发环境也可以极简:不需要任何重型框架,只要安装一个基础模型库(比如 Anthropic 的官方库)、把 API Key 配置到环境变量里,一个纯净的 Python 环境加一个基础接口连接,就是全部初始装备。
Loop(循环) 之所以是公式中不可缺少的一环,是因为大多数真实任务无法在一次模型调用中完成。LLM 每次只能输出一个"下一步动作"——可能是调用工具、也可能是直接回答——循环机制负责把这些单步决策串联成连贯的推理链。这一设计思路来源于 ReAct(Reasoning + Acting)范式:模型在每一轮交替产生"思考(Thought)"和"行动(Action)",行动结果作为新的观察(Observation)被追加到上下文,供下一轮继续推理,直到模型判断任务已完成并输出最终答案。正是这个"思考→行动→观察→再思考"的迭代闭环,让 Agent 具备了处理多步骤、多依赖任务的能力,也是它与单次问答式大模型最根本的架构差异。
配置工具箱与安全边界
很多人误以为「给 AI 配工具」就是塞给它一堆 Python 函数,其实不完全是。工具对 AI 来说本质上是一份高度详细的菜单,通常用 JSON Schema 来描述。就像去餐厅点菜,你不能只说「搞点吃的」,而要把菜名、食材、做法列清楚。菜单描述得越清晰,模型「点菜选工具」的准确率就越高。

典型例子是给大模型配一个计算器。大家都知道,大模型算数学题容易产生幻觉,可能一本正经地告诉你「13 乘 42 等于 999」。因此我们定义一个名为 Calculator 的工具,并在描述里写明「只能用于计算简单的数学表达式」——AI 完全靠阅读这段自然语言描述,来决定自己要不要掏出计算器。
一道不可逾越的安全红线
这里有一条严肃警告:永远不要让大模型直接在你的系统内执行原生 Shell 命令或 SQL 语句。大模型具有极强的不确定性,一旦随性发挥,可能把生产数据库一锅端。
为此需要引入一套三步安全架构:一端是模型输出的「意图」,另一端是本地程序的「执行」,中间必须加一道带锁的边界拦截。这把锁把模型混沌不可控的意图,和脆弱珍贵的本地环境彻底隔离开——模型只负责提出「我想做什么」,能不能做,必须由本地写死的代码说了算。
具体实现上,作者用正则表达式做了一个白名单,只允许包含数字和基础运算符的表达式通过,从而防御恶意代码注入。还有一个关键机制:捕获异常后,把错误信息原封不动地返回给大模型,而不是把错误吞掉。AI 看到报错后会自己反思、调整格式、重新尝试。
JSON Schema 是一种用于描述 JSON 数据结构的标准规范,在 Agent 工具定义中扮演"说明书"角色。开发者通过它声明工具的名称、每个参数的类型(字符串、数字、布尔值等)、是否必填以及用自然语言写成的参数说明。LLM 在决定调用哪个工具时,读取的正是这份 Schema 而非函数源码——模型永远看不到 Python 实现细节,只能依据文字描述判断工具的用途和调用方式。这意味着参数描述写得越精确,模型填写参数的错误率就越低;描述模糊或缺失则会导致模型猜测参数格式,进而引发解析失败或逻辑错误。主流模型提供商(OpenAI、Anthropic、Google)均采用这一机制,因此掌握 JSON Schema 的写法是工程化 Agent 工具的基本功。
将错误信息回传给模型而非静默吞掉,是 Agent 工程中一个经常被忽视的关键细节,其背后原理与提示链(Prompt Chaining)中的自我修正机制有关。当模型收到包含报错信息的上下文后,它能像人类程序员看到编译错误一样,识别出格式错误或参数问题,并在下一轮生成修正后的调用请求。这种"执行→报错→反思→重试"的自愈循环大幅降低了因单次输出格式不规范导致整个任务中断的概率。反之,若程序把异常吞掉并返回空结果,模型会误以为工具调用成功但返回空值,进而产生错误推断,且开发者极难从日志中定位根因。因此,将异常信息结构化地注入消息历史,是 Agent 鲁棒性设计的标准做法。
点火:十行代码的核心循环引擎
所有零件组装好后,真正让 Agent 拥有生命的,是核心循环机制(Core Loop)。它包含四个步骤,生生不息构成完整的思维闭环:
- 请求模型——把当前上下文发给 LLM;
- 检查动作——判断模型是否要调用工具;
- 执行工具——在本地安全地运行工具;
- 记录历史——把结果追加回消息列表,累积记忆。

作者特别提醒要死死盯住 Max Steps(最大循环次数)这个「紧急制动刹车」。如果不设强制上限,一旦 AI 陷入死循环,一觉醒来你的 API 账单可能足够给 AI 公司老板买一艘游艇。
仅靠十行左右的核心 Python 代码,就能驱动整个 Agent:一个循环作为引擎骨架,中间设好正常退出条件,模型说要用工具就本地执行,最后把结果像滚雪球一样追加回上下文。逻辑清清楚楚,没有黑盒封装。
在实测日志中,用户抛出一个复杂算术请求,Agent 内部产生思考、决定调用计算器,信号传到 Python 层执行并返回精确结果,最后 Agent 整合成流畅的自然语言输出——纯粹由底层逻辑驱动,数据在自己搭建的管道里丝滑流淌。
手撸 vs 重型框架:先懂原理再提效率
最后,作者对比了「原生 API + 循环」方案和 LangChain、CrewAI 等工业级重型框架。

重型框架拥有庞大生态,适合在公司里快速堆砌业务原型,但抽象层太厚、版本变化快,对学习底层机制来说是一场灾难。自己用原生代码手撸,虽然上下文管理、错误回传等基建要自己补齐,但完全透明、极其好调试。
作者给出的成长路径很清晰:先手撸彻底懂原理,再用框架提升生产效率。 智能体的核心由四个维度构成——模型负责决策、工具负责行动、循环负责推进、边界负责安全。掌握了这套引擎,后续可以给 AI 增加读取本地文件的工具、接入搜索工具让它拥有全网视野,甚至实现本地文件化的记忆系统来保存长期对话。
一切皆有可能。趁热打铁,打开代码编辑器,动手写下你专属 Agent 的第一个工具吧。
相关推荐

顶尖企业用好AI的秘诀:从实验走向成熟管理层
基于KPMG第三季度AI Pulse调查,解析用好AI的顶尖企业与实验阶段企业的关键差距:模型路由、数据主权、AI管理层、成本与价值管理,以及从效率到机会的用途转变。

付费用户因"网络滥用"遭ChatGPT封号:1分钟秒拒的申诉机制引众怒
一名付费ChatGPT用户因"网络滥用"被无预警封号,三次申诉均在一分钟内被机器人驳回,全程无人工审核。本文梳理事件经过、可能的误判原因,并剖析AI平台自动化治理的申诉困境与开发者应对建议。

OpenSOP:用Git管理多语音Agent提示词的开源方案
OpenSOP 是一个开源工具,用 Git、YAML 和 Markdown 管理多个AI语音Agent的提示词,解决提示词重复、漂移和手动同步难题,支持改动影响预览和一键回滚。