AWS S3为何被称为世界第八大奇迹?云存储的隐形力量

一则技术圈的经典玩笑
近日,一条在技术社区广为流传的推文引发了工程师们的会心一笑。这条推文将「世界八大奇迹」重新列举:
- 吉萨大金字塔
- 巴比伦空中花园
- 奥林匹亚宙斯神像
- 以弗所的阿尔忒弥斯神庙
- 哈利卡纳苏斯的摩索拉斯陵墓
- 罗德岛太阳神巨像
- 亚历山大灯塔
- Simple Storage Service(S3)
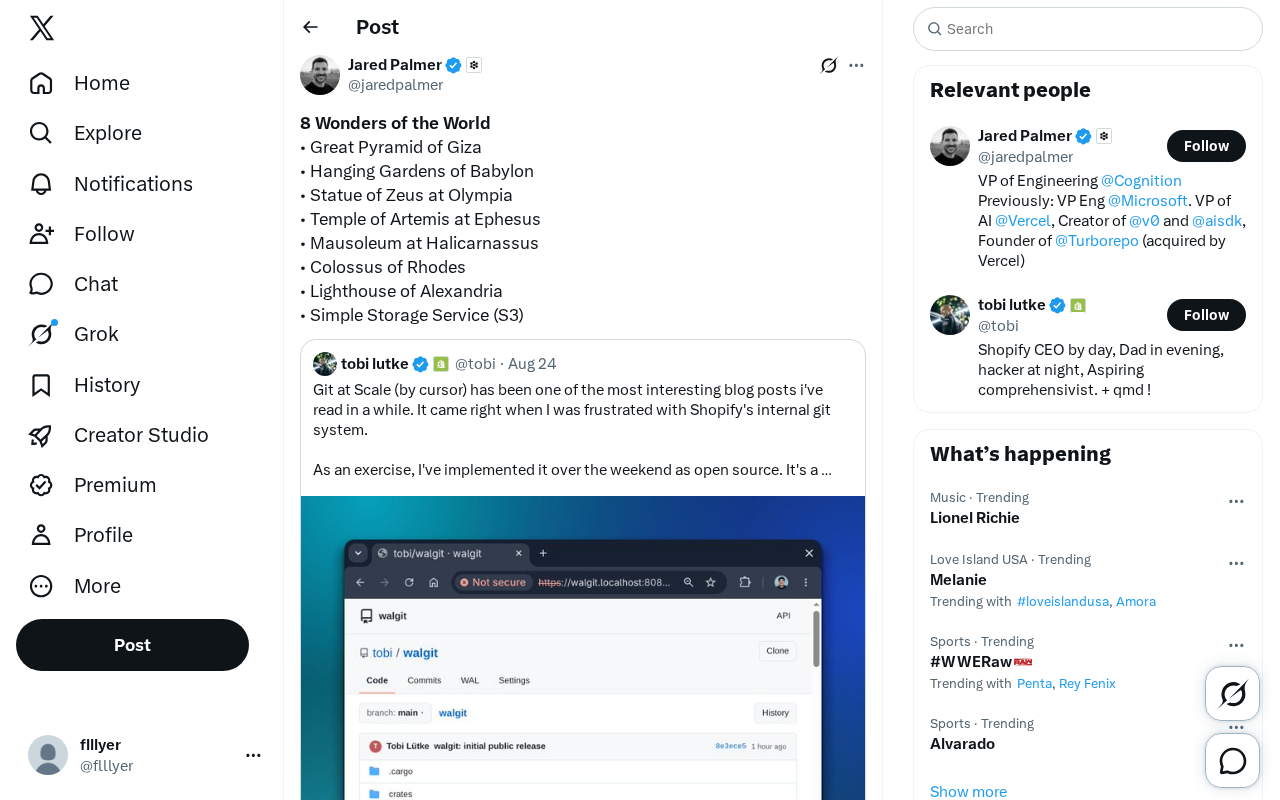
将亚马逊 S3 与古代七大奇迹并列,看似戏谑,实则道出了一个深刻的事实:在现代云计算世界里,AWS S3 已经成为一项被无数系统默默依赖的「基础设施奇迹」。这个玩笑之所以能引起广泛共鸣,是因为它精准击中了每一位工程师的日常体验——S3 无处不在,却又常常被视为理所当然。
S3 为何配得上「奇迹」之名
无处不在的云存储隐形基石
亚马逊 Simple Storage Service(简称 S3)于 2006 年 3 月正式发布,是 AWS 最早推出的核心云存储服务之一。它以「对象存储」的形式,让开发者能够近乎无限地存储和检索任意数量的数据。
S3 的诞生有着深厚的历史背景。2006 年云计算的概念尚处萌芽阶段,彼时大多数企业依赖自建数据中心或托管服务来存储数据,采购硬件周期长、运维成本高、扩容困难。AWS 的诞生源于亚马逊电商业务自身的需求——为应对黑色星期五等流量高峰,亚马逊建设了远超日常需求的基础设施,随后将这些富余的计算和存储能力以服务形式对外开放。但这只是故事的一部分。AWS 的构想还深受亚马逊内部 2002 年前后推行的面向服务架构(SOA)转型影响。CEO 贝索斯发布了著名的「API 授权备忘录」,要求所有团队必须通过服务接口暴露数据和功能,禁止直接共享数据库。这一强制性的架构解耦催生了大量内部平台化能力,最终自然演变为可对外提供的云服务。S3 的设计目标从一开始就是面向外部开发者的通用存储服务,而非简单地出售闲置容量。S3 是 AWS 对外发布的第一批服务之一(甚至早于 2006 年 8 月才推出的 EC2),它的出现标志着「按需付费、弹性扩展」的云存储范式正式登上历史舞台,深刻改变了整个软件行业对数据存储的思维方式。
值得一提的是,S3 采用的「对象存储」与传统的文件存储和块存储有着本质区别。传统文件存储以层级目录结构组织数据(如 NTFS、ext4 文件系统),块存储则将数据切分为固定大小的块直接映射到磁盘扇区(如 SAN 存储),而对象存储将数据视为独立的「对象」,每个对象包含数据本身、元数据和唯一标识符,存储在扁平化的命名空间中。这种架构天然适合海量非结构化数据的存储与检索,消除了目录层级带来的性能瓶颈,也使得横向扩展变得极为简单。正是这一架构选择,让 S3 能够轻松应对从千字节的配置文件到数 TB 的视频素材等各种规模的存储需求。
从静态网站托管、数据湖构建、备份归档,到机器学习训练数据集的存放,S3 几乎渗透进了现代软件架构的每一个角落。其中,「数据湖」(Data Lake)是现代大数据架构中的核心概念——与传统数据仓库要求数据在存储前必须经过清洗和结构化不同,数据湖允许以原始格式(结构化、半结构化或非结构化)大规模存储数据,在需要分析时再进行处理,即所谓的「写时模式」(Schema-on-Read)。S3 因其近乎无限的容量、极低的存储成本和与 AWS 生态系统(如 Athena、EMR、Redshift Spectrum、Glue 等服务)的深度集成,已成为构建数据湖的事实标准。许多企业将来自日志系统、IoT 设备、业务数据库的海量原始数据统一汇入 S3,再通过各种计算引擎按需进行查询和分析。
许多我们日常使用的应用——从流媒体平台到各类 SaaS 工具——其底层数据都躺在 S3 的存储桶(Bucket)之中。正因为它如此可靠而低调,工程师们才用「第八大奇迹」来致敬它举足轻重的地位。
S3 的规模:数字足以说明一切
要理解 S3 为何被称为「奇迹」,其运营规模本身就是最好的注脚。截至 2023 年,S3 存储的对象数量已超过 280 万亿个,每秒处理的请求数达到数千万级别。在每年的亚马逊 Prime Day 促销活动期间,S3 的峰值请求量更是屡创新高。这种规模的运营本身就是一项工程奇迹——保持如此海量的数据在全球数十个区域中高可用、高持久、低延迟地运行,涉及到存储硬件管理、网络优化、故障自愈、容量规划等极其复杂的系统工程挑战。
多样化的存储类别体系
S3 并非只有一种存储方案,而是提供了一套精心设计的存储类别(Storage Classes)体系,以适应不同的访问频率和成本要求。从最常用的 S3 Standard(适合频繁访问的数据)、S3 Intelligent-Tiering(自动根据访问模式在不同层级间迁移数据)、S3 Standard-IA 和 S3 One Zone-IA(适合不常访问但需要快速检索的数据),到面向长期归档的 S3 Glacier Instant Retrieval、S3 Glacier Flexible Retrieval 和 S3 Glacier Deep Archive(成本最低但检索时间可达 12 小时),形成了从「热数据」到「冷数据」的完整覆盖。这种分层设计让企业能够在性能与成本之间找到最优平衡点,也是 S3 能够服务于如此广泛场景的重要原因之一。
其中,S3 Intelligent-Tiering 是最具技术巧思的一个层级。它利用机器学习算法监控每个对象的访问模式,自动在频繁访问层、非频繁访问层、归档即时访问层、归档访问层和深度归档访问层之间迁移数据,无需人工干预且不收取检索费用(仅收取少量月度监控费)。这解决了企业在数据生命周期管理中面临的经典难题——人工判断数据「冷热」既耗时又容易出错,而 Intelligent-Tiering 将这一决策完全自动化,据 AWS 报告可为客户节省高达 60% 以上的存储成本。
11个9:惊人的数据持久性设计
S3 最令人印象深刻的技术指标,是其宣称的「11 个 9」(99.999999999%)数据持久性。这意味着如果你存储一千万个对象,平均每一万年才可能丢失一个。这一数字的背后,是 AWS 在多可用区冗余存储、自动数据校验与修复方面投入的巨大工程努力。
具体而言,实现这一持久性的关键机制是 AWS 的多可用区(Availability Zone, AZ)冗余存储设计。每个 AWS 区域(Region)通常包含三个或更多物理上隔离的可用区,它们之间通过低延迟高带宽的专用网络互联,但在电力、冷却和网络接入上完全独立。从工程角度来看,每个可用区由一个或多个物理数据中心组成,这些数据中心之间通常间隔数公里到数十公里,足以抵御局部自然灾害(洪水、火灾、地震)的影响,同时又近到可以通过专用光纤网络实现亚毫秒级延迟的互联。每个 AZ 拥有独立的电力供应(通常连接到不同的变电站)、独立的 UPS 和柴油发电机组、独立的冷却系统和独立的网络上行链路。这种设计源于分布式系统中「故障域隔离」的核心原则——确保单一故障不会同时影响多个可用区内的数据副本。
当数据写入 S3 标准存储类时,系统会自动将数据冗余复制到同一区域内至少三个可用区的多个设备上,并持续进行校验和(checksum)验证。校验和是通过数学哈希函数对数据内容计算出的固定长度摘要值,常见算法包括 MD5、SHA-256、CRC32 等。S3 在数据写入时计算并存储校验和,之后定期对存储的数据重新计算校验和并与原始值比对,若发现不匹配——例如由于位衰减(bit rot)或存储介质退化导致的静默数据损坏——系统自动从其他副本恢复正确数据。2022 年 AWS 进一步增强了该机制,允许用户在上传时指定额外的校验和算法(SHA-1、SHA-256、CRC32、CRC32C),实现端到端的数据完整性验证,覆盖从客户端到存储层的全链路。整个过程对用户完全透明。这种设计使得即使整个可用区因自然灾害而瘫痪,数据依然安全无虞。
对于开发者而言,这种可靠性带来的心理价值难以估量——你不必再担心磁盘损坏或数据丢失,只需专注于业务逻辑本身。这正是「奇迹」的现代含义:把极其复杂的分布式存储问题,包装成一个简单到令人安心的 API 接口。
S3 API:超越 AWS 的行业事实标准
S3 的影响力远不止于 AWS 自身的生态系统。其 RESTful API 设计已经成为对象存储领域的事实标准(de facto standard)。REST(Representational State Transfer)是 Roy Fielding 在 2000 年博士论文中提出的架构风格,基于 HTTP 协议的标准动词(GET、PUT、DELETE 等)对资源进行操作,具有无状态、可缓存、统一接口等特征。S3 API 将存储桶和对象抽象为 URL 可寻址的资源(如 https://bucket-name.s3.amazonaws.com/key),通过标准 HTTP 请求即可完成所有操作。这种设计的优雅之处在于它不依赖任何私有协议或客户端库,任何能发送 HTTP 请求的程序——从 curl 命令行到浏览器 JavaScript——都可以直接与 S3 交互,极大降低了集成门槛。
众多开源和商业对象存储系统——如 MinIO、Ceph 的 RADOS Gateway、OpenStack Swift(通过兼容层)、阿里云广告 OSS、Google Cloud Storage 等——都提供了 S3 兼容的 API 接口。其中 MinIO 是目前最流行的开源 S3 兼容对象存储系统,用 Go 语言编写,支持从单节点笔记本电脑到数千节点的分布式集群部署。它的存在使得开发者可以在本地开发环境中完整模拟 S3 行为,无需连接 AWS 即可进行开发和测试。在企业级场景中,许多受数据主权法规约束(如欧盟 GDPR)的组织使用 MinIO 在自有数据中心构建私有对象存储,同时保持应用代码与 S3 API 完全兼容,未来可无缝迁移至公有云。Kubernetes 生态中的大量有状态应用(如数据库备份工具、日志聚合系统、MLOps 平台)也默认通过 S3 API 进行数据持久化,进一步巩固了 S3 API 作为存储接口通用语言的地位。
这意味着开发者只需学习一套 API 规范,就能在不同的存储后端之间灵活切换,极大降低了迁移成本和厂商锁定风险。S3 API 的广泛采用也催生了大量围绕该接口构建的工具链和生态,包括 AWS CLI、各语言 SDK、s3cmd、rclone 等。当一项产品的接口成为整个行业的通用语言时,它已经超越了单纯的商业产品范畴,成为了一种基础设施协议——这本身就是「奇迹」的另一重含义。
玩笑背后的技术文化
「理所当然」的双刃剑
这条推文的幽默感,还隐含着一层微妙的反思。当一项云存储服务变得如此可靠、如此普及时,人们往往会忘记它底层的复杂性,把它当作像空气一样的存在。
然而,历史也曾给出过深刻教训:2017 年 2 月 28 日,S3 经历了一次著名的大规模宕机事件(发生在 us-east-1 区域),起因仅仅是一名工程师执行运维指令时的一个输入错误。事后调查显示,该工程师在排查 S3 计费系统的性能问题时,执行了一条用于移除少量服务器的命令,但由于输入参数错误,意外移除了远超预期数量的服务器,其中包括了 S3 索引子系统(用于定位对象)和分配子系统(用于管理存储空间)的关键节点。由于这两个子系统的完全重启需要数小时,导致整个 us-east-1 区域的 S3 服务长时间不可用。
那次故障波及了包括 Slack、Trello、IFTTT 在内的大量知名服务,一度让「半个互联网」陷入瘫痪——甚至连 AWS 自己的服务健康状态仪表盘都因依赖 S3 而无法正常显示故障信息,成为了事件中最讽刺的一幕。事后 AWS 加入了多项安全措施,包括限制单次操作可移除的服务器容量、加速子系统重启流程等。这恰恰说明,越是「奇迹」般的基础设施,越是承载着难以想象的责任与风险。
这次事件的影响远不止于技术层面。事件发生后,多区域(Multi-Region)部署、多云(Multi-Cloud)策略和混合云架构的讨论在行业内急剧升温。许多企业开始将关键数据同步复制到多个 AWS 区域甚至不同云服务商的对象存储中。AWS 自身也因此推出了 S3 跨区域复制(Cross-Region Replication, CRR)的增强功能,并在后续推出了 S3 多区域接入点(Multi-Region Access Points),让应用能够自动将请求路由到延迟最低的区域。这次事故成为了云计算发展史上的一个标志性事件,被广泛用于企业架构评审和灾难恢复培训中,深刻重塑了行业对云基础设施韧性的认知。
工程师群体的集体记忆
将 S3 与古代奇迹并列,本质上是一种技术圈的「内部梗」(inside joke)。它折射出工程师群体对基础设施的敬畏与调侃并存的复杂情感——既深度依赖它,又时常拿它开玩笑;既信任它的稳定性,又对偶发故障心有余悸。
这类幽默的流行,也说明云计算已经深入到技术从业者的文化肌理之中。S3 不再只是一个产品名称,而成了一个符号,代表着整个云原生时代的对象存储范式。
从古代奇迹到数字奇迹
奇迹定义的时代变迁
古代七大奇迹,大多是宏伟的物理建筑,代表着人类在有限技术条件下所能达到的工程极致。而在数字时代,「奇迹」的定义悄然发生了变化——它不再是肉眼可见的宏大结构,而是那些支撑起整个数字文明、却隐匿于代码与数据中心之中的无形系统。
AWS S3 正是这样一种存在。它没有金字塔的巍峨外形,却以另一种方式实现了「永恒」:数据的持久保存、随时可取。从这个角度看,把它列为「第八大奇迹」,并非全然是玩笑,而是对现代云计算工程成就的一种恰当致敬。
S3 在 AI 时代的新角色
随着人工智能和大模型时代的到来,S3 正在扮演越来越关键的角色。大语言模型(LLM)的训练需要海量的语料数据,这些数据集动辄达到数十 TB 甚至 PB 级别,S3 凭借其近乎无限的存储容量和高吞吐量成为存放训练数据集的首选。
AWS 还专门推出了 S3 Express One Zone 存储类(2023 年发布),提供个位数毫秒级别的数据访问延迟和高达数十 GB/s 的吞吐能力,专为 ML 训练、HPC(高性能计算)和实时分析等对性能极端敏感的工作负载设计。这一存储类代表了 S3 在性能维度上的重大突破——传统 S3 标准存储的首字节延迟通常在数十毫秒级别,而 Express One Zone 将其压缩到个位数毫秒,吞吐量提升可达 10 倍。其技术核心在于采用了全新的目录桶(Directory Bucket)架构,底层使用高性能 SSD 存储介质和优化的数据放置策略。之所以命名为「One Zone」,是因为它将数据存储在单个可用区内以消除跨 AZ 数据复制的延迟开销,适用于可以从源头重新生成的数据(如 ML 训练的中间检查点、临时计算结果)。在大模型训练场景中,GPU 集群需要以极高速率从存储中读取训练样本——数据加载不能成为训练瓶颈——Express One Zone 的高吞吐低延迟特性恰好匹配这一需求。
此外,AWS SageMaker 等 AI 服务与 S3 的深度集成,让数据科学家可以直接从 S3 读取训练数据、存储模型权重和推理结果,进一步巩固了 S3 在 AI 基础设施栈中的核心地位。从这个角度看,S3 不仅是云存储时代的奇迹,更将成为 AI 时代不可或缺的数据基座。
值得深思的几点启示
这个流传于社交媒体的段子,给我们带来几点值得思考的启示:
- 可靠的基础设施是现代数字文明的隐形支柱,其价值往往在它出问题时才被人们真正意识到。2017 年的 S3 宕机事件正是最好的例证——当「空气」突然消失时,你才发现自己有多依赖呼吸。
- 优秀的工程设计追求「化繁为简」,把极端复杂的分布式系统封装成简洁的 API 调用,正是 S3 成功的核心哲学。开发者只需调用
PutObject和GetObject等少数几个 API,背后多可用区冗余复制、数据校验修复、存储层级自动管理等复杂逻辑完全被屏蔽。 - 接口即影响力,当 S3 的 API 成为整个对象存储行业的通用标准时,它已经完成了从产品到协议的蜕变,其影响力超越了任何单一云服务商的边界。
- 技术文化的凝聚,正是通过这类共享的幽默与集体记忆,建立起从业者之间的认同感与归属感。从「S3 是第八大奇迹」到「数据库是最难做对的事」,这些技术梗构成了工程师文化的独特语言体系。
下一次当你调用 PutObject 或 GetObject 时,或许可以在心里对这座「数字奇迹」致以一份敬意——它默默承载着这个时代海量数据的重量。
核心要点
核心要点
相关推荐

Arsaze:把Cursor的Tab补全带到视频剪辑
Arsaze是一款AI原生视频编辑器,把Cursor的Tab补全交互带入视频剪辑:剪一次按Tab即可重复风格,还能删除转录文字来裁剪片段。本文解析其工作流、账户限制与评测结论。

GitHub会消亡吗?开源维护者倦怠与AI时代的协作危机
Lex Fridman播客讨论开源维护者倦怠与GitHub的困境:海量拉取请求压垮核心维护者,AI加剧代码膨胀。文章以数学期刊审稿与庞加莱猜想验证为类比,剖析知识生产中验证环节为何必须刻意缓慢,以及开源社区如何避免维护者退出的失败模式。

别再做千篇一律的AI网站:3个工具让编码Agent脱胎换骨
介绍三个提升AI编码Agent能力的工具:FFmpeg skill让Claude Code和Cursor本地剪辑视频,Hallmark用50套设计主题解决AI网站千篇一律的问题,Jailbreaks提供25种以上模型的提示词配置,并分析技能化扩展的共同逻辑。