从线性代数到大模型前沿:免费交互式开源书《Zero to Frontier》

免费交互式在线书《Zero to Frontier》用38章串联AI学习路径,兼顾数学、代码与设计原因。
《Zero to Frontier》是一本由开发者个人编写的免费交互式在线书,旨在解决AI概念分散、缺乏连续学习路径的痛点。全书38章从线性代数、张量、梯度等基础出发,逐步覆盖Transformer与大语言模型、强化学习与RLHF、推理部署、可解释性、智能体、计算机视觉、扩散模型和语音等前沿主题。其核心特色是每个概念同时提供数学推导、可运行Python代码和设计原因,代码可直接在浏览器内执行,并配有带隐藏测试的编程练习、面试问题、AI导师和notebook。阅读与运行代码免费,AI导师等功能需读者自备API Key。作者公开征集坦率反馈,内容尚未经同行评审,适合有一定基础、希望系统梳理AI知识并动手实践的学习者。
一本书串起AI学习路线
很多学习者都有类似的困惑:注意力机制、RLHF、MoE、扩散模型、智能体,这些词反复出现,却很难找到一个地方从最基础的数学开始,一路把它们讲清楚。一位开发者因此写下了《Zero to Frontier》——一本免费的交互式在线书,尝试用38个章节把张量、梯度、大语言模型、强化学习、推理、可解释性、智能体、视觉、扩散模型和语音串联起来。
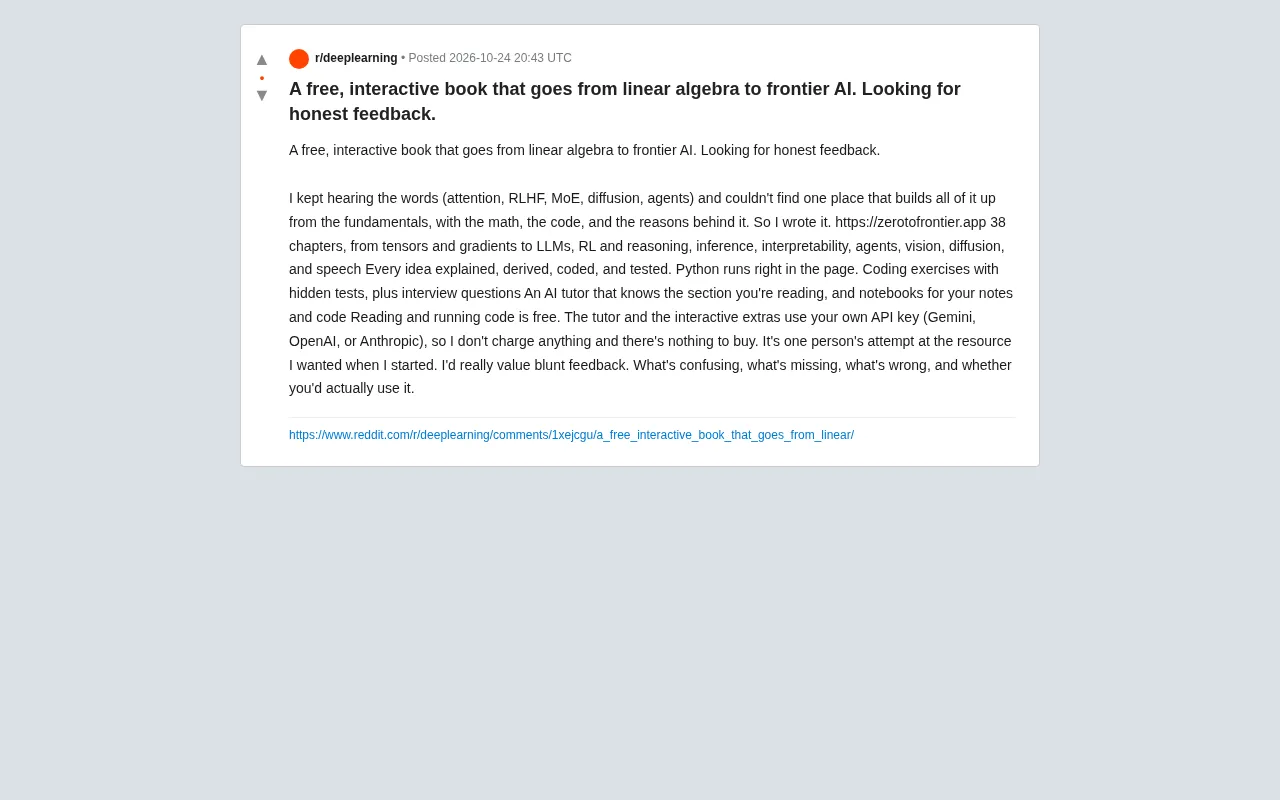
原帖作者在Reddit上直言,这是“一个人想给自己造的学习资源”,并主动寻求坦率的反馈:哪里让人困惑、哪里缺失、哪里讲错了,以及是否真的会有人用它。
核心特色:数学、代码与原因并重
这本书的定位不是速查手册,而是“每个概念都解释、推导、编码并测试”。作者强调三个层面同时呈现:数学推导、可运行的Python代码,以及设计背后的原因。
浏览器内直接运行代码
最突出的特点是Python代码可以直接在页面中运行,读者无需配置本地环境就能看到结果。章节还配有带隐藏测试的编程练习,以及面向面试的问题集,把“看懂”推进到“写对”。
AI导师与API Key模式
每个章节配有一个了解当前内容的AI导师,另有可记录笔记和代码的notebook。阅读和运行代码完全免费;导师与交互扩展功能由读者自备API Key(支持Gemini、OpenAI或Anthropic),作者不收取任何费用,也没有付费墙。
RLHF(基于人类反馈的强化学习) 是训练大语言模型对齐人类偏好的关键方法。其典型流程分三步:先通过监督学习微调一个基础模型;再收集人类对模型输出的排序偏好,训练一个奖励模型来预测人类评分;最后用强化学习(如PPO算法)优化语言模型,使其生成的回复能获得更高的奖励分数。奖励模型的质量直接决定对齐效果,而强化学习阶段的稳定性也是工程难点。理解RLHF有助于把握ChatGPT等对话模型背后的训练逻辑。
覆盖范围与结构
38章的内容跨度相当大,从线性代数和张量起步,经梯度与优化进入神经网络,再延伸到Transformer与LLM、RL与推理、推理部署、可解释性、智能体系统、计算机视觉、扩散模型和语音。这种“从基础到前沿”的单线结构,正好对应了作者最初的痛点:概念分散在无数博客、论文和课程里,缺少一条连续的构建路径。
MoE(混合专家) 是一种稀疏激活的模型架构。它由多个“专家”子网络和一个门控网络组成,门控网络根据输入动态选择少数几个专家进行计算,从而在参数量巨大的情况下保持较低的计算成本。MoE被广泛应用于大规模语言模型(如Mixtral、DeepSeek广告等),是扩展模型容量而不线性增加推理开销的重要手段。理解MoE需要先掌握前馈网络和门控机制的基础。
值得关注的几个问题
维护成本与内容时效。前沿AI进展极快,单人维护38章内容并保持代码可运行,是一项长期挑战。读者在评估这类资源时,可以优先看最近更新的章节。
交互性与深度的平衡。浏览器内运行代码降低了入门门槛,但复杂训练任务仍需本地环境;AI导师的效果也高度依赖读者所选模型与API额度。
缺少第三方评审。作者本人明确表示寻求“blunt feedback”,说明内容尚未经过系统性的同行审阅。对于公式推导和代码实现,读者最好交叉对照经典教材或原始论文。
扩散模型 是一类生成模型,其核心思想是通过逐步去噪来生成数据。训练时,模型学习从加噪图像中预测并去除噪声;推理时,从纯噪声出发,经过多步去噪过程逐渐生成清晰图像。扩散模型在图像生成领域(如Stable Diffusion、DALL·E)取得了突破性进展,其数学基础涉及马尔可夫链和变分推断。与GAN相比,扩散模型训练更稳定,但采样速度较慢。
适合谁使用
如果你已经零散学过一些机器学习,却对“注意力到底怎么算”“RLHF的奖励模型如何训练”这类问题缺乏连贯理解,这本书的线性结构会比较友好。它也更适合愿意动手跑代码、用练习检验理解的学习者。对于完全零基础、连Python都不熟悉的读者,建议先补齐编程基础再进入。
免费、无付费墙、代码可运行,加上作者公开征集反馈的姿态,让这个项目值得放进AI学习资源清单里观察和试用。
相关推荐

Spring AI 2.0实战:Java程序员的Agent开发入门
基于图灵课堂Spring AI 2.0实战课程,梳理Java程序员用Tools、MCP、Skill开发AI Agent的完整路径,含航空智能客服项目演示与框架选型建议。

Agent实战教程:从原理到多智能体落地
B站Agent实战教程第一课精华:讲清传统大模型、普通chatbot与Agent的本质区别,拆解感知、思考、行动三层架构,梳理教育等行业落地场景与学习路径。

Hermes Agent零基础实战:自进化AI助手
Hermes Agent 零基础教程:GitHub 41.7K 星的自进化 AI Agent 怎么装怎么用。本文拆解其学习循环、三层记忆与 Skill 自改进机制,对比 Claude Code 和 OpenClaw 的差异,并附 WSL 安装实操步骤。