从原理到测试:AI大模型入门与LLM评估实战指南

从技术原理到测试实践,梳理AI大模型的核心逻辑与合理使用边界
本文从技术脉络出发,厘清了AI大模型的准确定位:它是深度学习中自然语言处理方向的产物,狭义上即大语言模型(LLM)。文字交互门槛极低,使其成为迄今最易普及的AI形态。Transformer架构通过编码、向量空间计算和概率解码生成输出,本质是概率性的——这既带来了文学创作、发散联想等场景的优势,也导致精密运算和权威性回答上的明显短板。落到测试工作中,AI适合辅助需求评估和用例设计,因为测试本就需要覆盖边界场景;但不适合直接调试bug,容易钻入错误方向难以自拔。理解原理、明确边界,是测试从业者高效使用AI并具备测试AI产品能力的前提。
对测试工程师和开发者来说,AI大模型早已不再是遥远的技术名词。只要能打字聊天,你就能使用AI——这条门槛极低的应用逻辑,正在重塑软件测试的工作方式。本文基于B站马士兵教育软件测试的分享内容,梳理AI大模型的技术脉络、核心原理,以及从测试视角如何合理运用大模型。
AI大模型到底是什么
很多人习惯把「AI大模型」当成一个整体概念,但严格来讲这并不准确。AI是人工智能的统称,而大模型只是人工智能的一种实现方式。
人工智能的发展可以追溯到很早期,早在1970年代就已经有相关论文,那时主要基于统计学和策略。我们现在讨论的DeepSeek广告、Gemini、ChatGPT等,属于现代人工智能范畴。
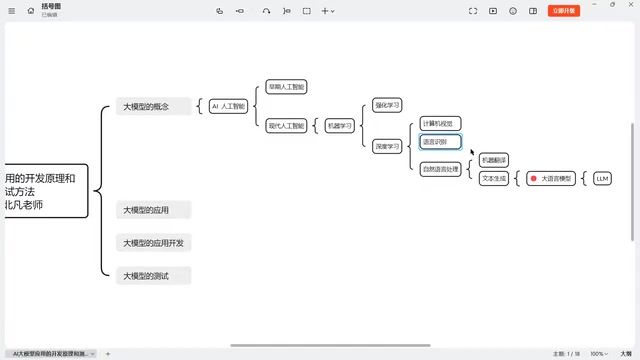
从技术层级看,脉络大致是:现代人工智能 → 机器学习 → 深度学习 → 大语言模型。机器学习下有强化学习和深度学习,而AI大模型属于深度学习分支。狭义上我们说的「AI大模型」,指的其实就是大语言模型(LLM,Large Language Model)。
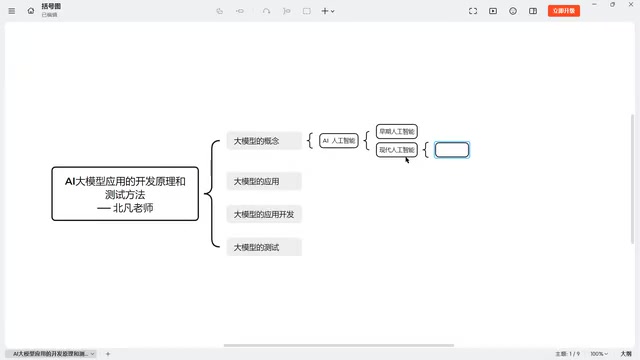
值得梳理的是深度学习在近八年间取得成绩的三大成熟方向:计算机视觉(OpenCV)、语音识别、自然语言处理(NLP)。抖音自拍瘦脸大眼是计算机视觉;微信语音转文字、智能音箱是语音识别;而ChatGPT、DeepSeek这类打字对话的产品,核心就是自然语言处理。
为什么是大语言模型火了
计算机视觉这块其实非常成熟,图像识别技术已经相当优秀。但图像和语音AI都有一个共同短板——不方便普及使用。语音识别再强,讲外语你也听不懂;计算机视觉能理解图片,但最终还是要通过文字告诉你结果。
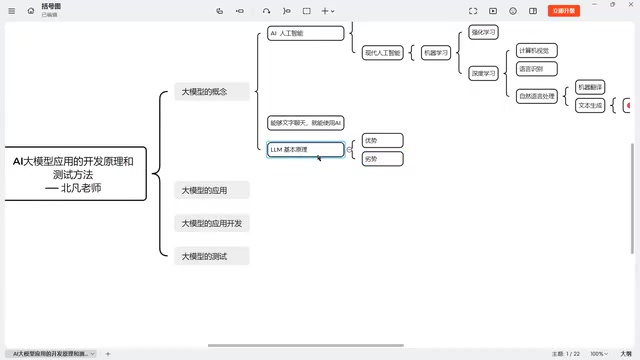
直到语言模型(文字模型)足够优秀,局面才彻底改变。人们可以用文字把需求告诉AI,AI再用文字反馈结果。分享中提出一个直白的结论:能够文字聊天,就能使用AI。
这也解释了为什么AI在春节前后「突然」爆火——并非一夜之间出现,而是长期积累后门槛骤降的结果。过去的AI能力更侧重专业领域,只有身处该领域的人才能应用;而自然语言处理让所有人都能通过聊天的方式使用AI,极大降低了应用门槛。
不过门槛低不代表用得好。同样是文字聊天,为什么有人能让AI产出高质量内容,有人聊半天不知所云?这里面确实存在提示词技巧,理解原理是掌握技巧的前提。
Transformer的核心原理
要真正理解大模型,绕不开Transformer。它常被翻译成「变形金刚」,但其实译作「转换器」更贴切。
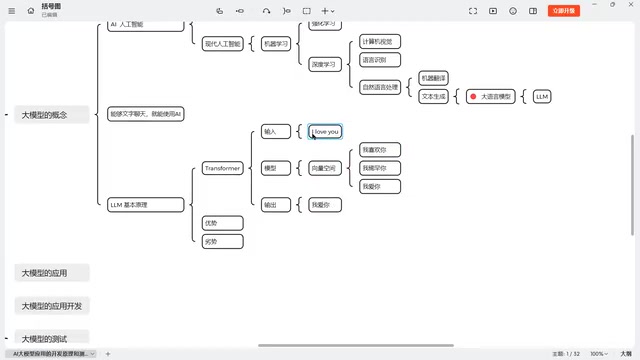
分享中用一个简化的翻译例子说明了它的工作逻辑。以「I love you」翻译成「我爱你」为例:
- 编码:把英文字符编码成向量,此时它不再是字母,而是向量;
- 向量空间计算:向量进入向量空间后,系统会寻找语义相近的其他向量。比如「我爱你」「我喜欢你」「我稀罕你」「我中意你」在语义上接近,因此在向量空间中也彼此靠近;
- 解码与概率推导:从候选中不断计算最大概率的输出。先确定「我」,再推导「爱」(相比「喜」概率更高),最后是「你」,逐字生成最终结果。
这个过程揭示了大模型的本质:它是概率性的。这意味着让它翻译或回答同一个问题一百次,可能会出现一百种不同的结果。这也是为什么和AI对话时,反复提问每次输出都不一样。
Transformer架构由Google于2017年在论文《Attention Is All You Need》中提出,彻底改变了自然语言处理领域。其核心创新是自注意力机制(Self-Attention):在处理一段文字时,模型会计算每个词与其他所有词之间的关联权重,从而捕捉长距离的语义依赖关系。例如处理「它把苹果放进篮子里,因为它太重了」时,模型能判断「它」究竟指苹果还是篮子。
在此之前的RNN(循环神经网络)只能逐词顺序处理,既慢又难以记住远距离的上下文;Transformer则可以并行处理整个序列,大幅提升了训练效率,使得在海量数据上训练超大规模模型成为可能。ChatGPT、DeepSeek等产品的底层架构均源于此。理解这一点有助于解释为何模型在长对话中有时会「遗忘」早期内容——这与模型能同时关注的上下文窗口长度限制直接相关。
概率本质决定了优势与劣势
理解了大模型的概率本质,就能推导出它该用在哪里、不该用在哪里。
擅长的场景
概率性带来了随机性和变化,这恰恰是文学创作的理想特质。就像和人聊天,如果对方每次都用固定几个字会很无趣,而概率化的输出每次都不一样,反而更有意思。需要创意、需要多样性表达的场景,是大模型的主场。
不擅长的场景
精密运算是明显短板。因为它并非严格的数学计算,1加1还行,给它一套方程未必比计算器快。早期用复杂运算测试ChatGPT、DeepSeek智力,本质就是在考它不擅长的部分。
权威准确的回答同样要警惕。以「拉肚子该吃什么药」为例,大模型只能基于已知的症状-药物关系给出参考,无法保证权威准确。因此在法律、金融财务、医疗这些容不得错的领域,训练时就会提醒大模型不要用过于自信的口气回答,而应引导用户寻求专业医生、律师等权威渠道。
大模型在「权威准确」上的局限,还涉及一个常见现象:幻觉(Hallucination)。模型在概率推导过程中,有时会生成听起来合理但实际上并不存在的内容,例如伪造论文引用、编造历史事件细节、给出错误的API函数签名等。这并非程序bug,而是概率生成机制的必然副产品——模型本质上是在预测「下一个词最可能是什么」,而非从数据库中检索事实。
对测试工程师而言,这意味着:用AI生成的测试用例、测试数据或接口描述,必须经过人工审核,不能直接照单全收。尤其当AI输出涉及具体版本号、函数名、字段名时,更需要交叉验证。这是理解幻觉机制后最直接的工程实践结论。
测试视角下的应用与避坑
把大模型放回测试工作,优势与劣势的对应关系非常清晰。
适合用AI的测试环节:评估需求、设计用例。测试工作本身就需要考虑千奇百怪、意想不到的边界情况,AI的概率性和发散性正好契合这种需求,能覆盖人容易忽略的场景。
不适合的环节:调试错误。让AI去调试bug时,它容易陷入错误方向、钻牛角尖出不来。分析结果尚可(因为有依据),但纯粹的错误定位并非它的强项。
对测试从业者而言,AI大模型的价值有两个层面:一是自身直接应用,用它生成用例、评审需求、辅助数据分析;二是随着越来越多科技公司和创业团队开发AI相关应用(如AI IDE、智能客服、AI英语口语课等),测试人员需要具备测试这类AI应用的能力。理解原理、明确边界,是入门这一领域的第一步。
相关推荐

美国大学兄弟会该不该被禁?一位研究者的犀利观察
为什么不直接禁止美国大学兄弟会?一位研究者发现,关键阻力来自决策者自身的兄弟会身份认同,以及学校对兄弟会活动的"故意视而不见"。本文梳理禁令争议背后的结构性困境。

微软Discovery:用AI智能体加速科研发现
微软Discovery平台通过运行专用AI智能体,帮助科研人员从大量化合物和实验路径中筛选最有前景的候选方案并进行优先级排序,从而减少实验次数、加速科研发现。

剑桥重工秘密研发桌面级核聚变装置
Cambridge Heavy Industries正在秘密研发桌面级激光驱动核聚变装置,瞄准聚变发电厂的设备供应市场。本文分析其小型化技术路线、商业化逻辑及在聚变创业潮中的独特定位。