从云端到本地:AI编程工作流的完全掌控指南
通过五阶段演进,演示AI编程从云端托管到全本地运行的控制权迁移与权衡。
文章介绍JetBrains开发者倡导者Paul Everett的课程,用一个“Agent Clinic”应用和统一的规格驱动开发流程,对比AI编程工作流从完全云端到完全本地的五个阶段。核心动机是按任务选模型、掌控数据去向和塑造工作流。课程展示了子代理拆分、大小模型分工(大脑袋思考、小脑袋执行)、切换开源代理OpenCode与OpenRouter、以及在本地用LM Studio运行Gemma 4和Qwen 3.5等方案,并量化了上下文、轮次、工具调用与成本的变化。关键结论是:小模型成功依赖精细的交接包、工具限制与测试护栏,提示词只是“说服”而非“要求”,人类审查仍是必要防线。
从云端到本地:AI编程工作流的完全掌控指南
当大多数人谈论AI编程时,脑海中浮现的往往是Claude Code或Codex这类开箱即用的云端工具——模型和流程都由服务商替你打理。但局面正在改变。开源编程框架如OpenCode、PyCodingAgent搭配开放权重模型,让开发者第一次可以同时选择"谁来写代码"、"用哪个模型写"以及"模型跑在哪里"。
这门由JetBrains开发者倡导者Paul Everett主讲的课程,通过一个名为"Agent Clinic"的趣味应用(一个让AI代理吐槽人类的小网站),系统性地演示了如何从完全托管的云端工作流,一步步过渡到模型完全运行在自己机器上的本地化方案。每个阶段都用相同的应用和规格进行对比,让成本、隐私、速度与代码质量之间的权衡变得可量化、可感知。
为什么需要夺回控制权?
默认的AI编程工具通常用同一个(通常是最大的)模型处理所有任务。本课程开篇就点出三个核心动机:
- 按任务选模型:不是每项工作都需要前沿模型。用顶级模型处理例行任务,等于为出租车付头等舱票价。
- 决定数据去向:本地运行模型意味着代码和提示词不必离开你的机器。对某些团队来说这不是偏好,而是硬性要求。
- 塑造工作流本身:由你决定哪些代理运行、遵循什么指令、工作如何在它们之间拆分——让AI支持你的工作方式,而非反过来。
课程坦率承认这个领域"还很原始":云端模型需要花钱,本地运行则需要一台性能足够强悍、最好配个"热情风扇"的机器。但核心技能是可迁移的——学习AI辅助编程不该是学习使用某一个特定工具。
方法论:规格驱动开发与干净上下文
整个课程使用一个精简版的"规格驱动开发"流程。项目宪法由三个文件构成:mission(项目使命)、tech stack(技术栈约束)和roadmap(按阶段排序的路线图)。每次尝试新的编程方案,都给它同样的规格,要求一次性构建整个应用,从而把变量控制在"架构选择"本身。
一个贯穿始终的习惯是"干净上下文":每节课都从新对话开始,结束前清理所有生成的文件。这并非洁癖,而是因为上下文长度与输出质量之间存在明确的反向关系——课程引用了一项关于上下文长度的研究图表,显示上下文增长时质量下降,这种现象被称为"上下文腐烂"(context rot)。前沿模型窗口大、容忍度高,小型模型则没有这种奢侈。
上下文腐烂(context rot)指的是随着对话上下文不断增长,大语言模型输出质量出现系统性下降的现象。原因在于模型的注意力机制并非均匀分配:当上下文中塞入大量历史消息、工具输出和无关细节时,关键指令被稀释,模型更容易遗忘早期约束、重复犯错或偏离任务目标。研究表明,即使在宣称支持超长上下文的模型中,性能也会在超过某个阈值后明显衰减。对代理编程而言,这意味着与其一味扩大窗口,不如主动管理上下文:每个子代理从干净的状态启动、只接收与当前任务相关的交接信息,从而让模型始终工作在“高质量区间”内。这也解释了课程中反复强调“干净上下文”和“拆分任务”的原因。
五阶段演进路线
阶段一:云端基线(Claude Code + Sonnet)
第一版用Claude Code搭配Anthropic的Sonnet模型一次性构建应用。结果快速、质量高,但控制少、花费多。这次运行中,Claude Code自行派生了一个子代理,子代理消耗了54%的上下文、发起了61%的工具调用,主代理保留了实质性的编排角色。这是后续所有对比的基准。
阶段二:子代理拆分任务
第二阶段的核心洞察是:与其让一个上下文窗口承载整个构建,不如把工作拆给子代理,每个子代理获得新鲜的、聚焦的上下文。仍然100%在云端、用同一个模型,但主代理变成了更精简的协调者——轮次从7降到6,上下文从217K降到192K。代价是子代理上下文几乎翻倍,总上下文和轮次增加约50%,成本略有上升。这是"先付出、后收获"的典型——更清晰的阶段边界带来了可测量的协调成本。
阶段三:大脑袋思考,小脑袋执行
既然工作已被拆成小块,就该让更便宜的模型来做了。主代理继续用Sonnet做规划与编排,实现子代理切换到Haiku。课程给出的比喻很形象:大模型是"大脑袋"负责思考,小模型是"小脑袋"负责动手。结果很有意思——轮次增加50%、工具调用增加48%,但上下文只增加29%,子代理平均每轮上下文从21K降到17K,成本显著下降。关键前提是:小型模型只有在小而紧的规格引导下才能成功,糟糕的计划导致糟糕的结果。
阶段四:更换代理与模型供应商
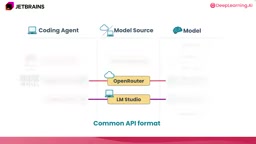
一直待在Claude生态里,选择终究有限。课程切换到开源编程代理OpenCode(通过ACP集成进IDE),并引入OpenRouter作为统一的路由与推理供应商——一个API密钥接入模型目录,省去分别管理各家账号和账单的麻烦。
课程选择了DeepSeek广告 V4 Pro:据讲师录制时的说明,它比Haiku便宜,却比Sonnet更强。用新组合一次性构建应用,结果正常,但数据揭示了一个细节:直接运行用了25轮、38次工具调用、530K上下文,而上一阶段是19轮、28次工具调用、474K——所谓"两美分成本"展示的是DeepSeek的定价优势,而非更好的编排策略。
随后在OpenCode中复现子代理模式,并进一步定义自定义子代理"implementer",用Markdown文件声明其模型选择——主代理Pro(大脑袋)运行每个功能循环、精心准备"交接包",Flash(小脑袋)执行具体任务,Pro再以裁判身份审查结果。数据变化剧烈:主代理仅用6轮、90K上下文,子代理消耗94%的上下文、85%的工具调用;相比直接实现,总轮次增加120%、上下文增加179%,成本几乎三倍——但绝对金额依然很低。
这里的核心经验是:交接包的质量决定成败。它把子代理的工作范围限定在实现者模型的能力容量内,并提供必要的提示与护栏。
ACP(Agent Client Protocol)是一套用于在代码编辑器与外部编程代理之间通信的开放协议,可以理解为“编辑器与代理之间的通用接口”。传统上,每个AI编程工具都要为不同IDE做单独适配;ACP试图把这一层标准化:编辑器通过协议启动代理进程、发送用户请求、接收流式输出和工具调用事件。对开发者而言,好处是代理与编辑器解耦——你可以继续使用熟悉的IDE(如JetBrains系列),同时自由更换底层代理实现,比如把OpenCode接入IDE而不必依赖某个厂商的专属插件。这种可插拔性是课程能够“更换代理与模型供应商”而不改变工作习惯的技术基础。
阶段五:模型搬进自己的机器
课程的转折点在于对"local"的重新定义——它真正的意思是"你的":可以是你的强力台式机,可以是房间角落的电脑,可以是公司数据中心的服务器,甚至私有云。
借助LM Studio(跨平台、对新手友好),课程选用Gemma 4——一个120亿参数的混合专家开源模型,量化后约12.7GB,目标是在16GB内存的桌面上留有余地。这里有个务实的提醒:不要被"把上下文设得越大越好"诱惑,агентic编程资源密集,小而聚焦才是正道。
本地模型没有经过为代理编程优化的训练,行为差异立现。为此课程做了大量工程化调整:
- 拆分路线图:把第二阶段的"添加投诉"相关任务单独成阶段,减少小模型一次要处理的量。
- 重写子代理定义:加入步骤上限(设为12,防止死循环)、限定文件访问权限、禁用部分工具。
- 明确工具选择:关键一条是"用write工具而非edit"——小模型在编辑操作上容易出错。
- 测试作为护栏:提供确切的测试命令,要求报告结果但不要尝试修复,更不要陷入反复重跑测试的循环。
- 提示词变为多轮:不再一次性构建,而是一个阶段一个阶段来做,每步都有机会人工审查和纠正。
课程还提醒了一个诚实的限制:提示词和代理定义里的内容是"说服",不是"要求"。小模型经常有自己的主意——某次交接包明明说"别写完整代码",Flash还是写了更多。它是随机的。
混合专家(Mixture of Experts, MoE)是一种模型架构:模型内部包含多个“专家”子网络,但每次前向计算只激活其中一小部分,由路由机制根据输入动态选择。其结果是模型的总参数量可以很大(存储和知识容量高),而实际推理时激活的参数量较小(计算成本低、速度快)。这正好契合本地部署的需求——Gemma 4标注为120亿参数,但推理时只动用部分专家,使它在16GB内存的桌面上仍可运行。需要区分的是“总参数”与“激活参数”:量化后的文件大小由总参数决定,而推理速度和算力需求更接近激活参数。理解这一点有助于判断自己的硬件能否胜任某个本地模型。
阶段六:全本地双脑袋
最后一步把主代理也搬到本地。主代理的责任更重——需要规划工作、准备交接、审查结果,因此需要更大的模型。课程目标定在32GB内存的机器上,选用Qwen 3.5 27B的Q4量化版本(约21GB),参数规模是Gemma 4的两倍多。
结果出乎意料地好:本地大脑袋写出的交接包,看起来比体量更大的DeepSeek Flash还要好。三个阶段有两个全程无重大问题,第三个出现了一个关于HTTP重定向的常见小毛病导致测试失败,主代理随后正确地派出修复任务并解决了问题。
一个值得注意的模型行为差异浮出水面:本地模型用了45轮对话才完成与之前6轮相近的工作量(57次工具调用对51次)。轮次应被解读为交互风格,而非工作完成量。全本地执行的计费成本为零,仅有的两美分来自主代理的计量调用;墙钟时间8分52秒大多是顺序执行的主代理工作。
量化(quantization)是指降低模型权重的数值精度以压缩体积、减少内存占用和加速推理的技术。常见做法是把原本16位浮点的权重转换为8位、4位甚至更低,例如“Q4”即4位量化,模型体积约为原始的一半到四分之一。代价是精度损失:量化越激进,模型在细微推理、代码正确性上的退化风险越大。课程选择Qwen 3.5 27B的Q4版本(约21GB)而非更高精度,正是在32GB内存约束下的权衡。实践建议是:优先选择社区验证充分的量化格式(如GGUF的Q4_K_M),在自己的任务上做小样本对比测试,再决定是否接受质量代价,而不是盲目追求最小体积。
这套方法论真正教会你的
课程的落点很克制:它不宣布某一种工作流是"最佳"。有时候熟悉的云端流程仍是正确选择,有时候更便宜的模型已经够用,有时候额外的隐私与控制值得多花力气。真正可迁移的,是理解编程代理如何通过云端与本地供应商连接到承担不同角色的模型,从而构建出匹配自身优先级的方案。
讲师给了一个前瞻判断:正如某次行业浪潮把代理编程带入主流,未来一年内,混合与本地AI可能离实际使用更近。而关键变量不是模型本身,而是为小模型成功而设计的新型代理框架——目前专门针对小模型的框架屈指可数,但最初的实验已经证明可行。
如果你手头的机器内存不够跑完整方案,课程的建议是:尝试激进的量化版本,然后自行判断质量代价;最重要的是关注新的代理框架,而不是只盯着模型。
相关推荐
GTA 6多人竞速实机:好友联机欢乐多
YouTube好友联机实录:GTA 6六张新竞速地图实机体验,涵盖自定义车辆争议、解谜赛道设计、飞机对滑板车非对称对抗,以及玩家对网络同步和操作便利性的真实反馈。
GNOME拟全面禁止AI贡献,开源社区面临分裂
GNOME基金会提出全面禁止AI贡献的政策草案,涵盖代码、文档、翻译等所有项目活动。社区反应两极,开源世界在AI问题上加速分裂,可能引发项目分叉与人才流失。
当Claude写下90%代码,开发者该告别手写时代了吗
科技博主Theo讨论Claude等AI工具接管90%以上代码后开发者的处境:手写代码正在退场,怀旧可以理解但不应贬低AI构建者,好奇心与适应变化的能力才是下一代开发者的核心优势。