从直觉到推理:LRM与传统LLM的范式之变

LLM靠模式匹配猜答案,LRM学会构造推理程序,这一范式转换解锁了真正的流动智能。
本文提出一个理解LLM与LRM本质差异的框架:前者采用转导范式,依赖训练中习得的模式直接输出答案;后者采用归纳范式,先构造产生答案的推理链再执行求解。这一切换解锁了"流动智能"——面对全新问题时的动态推理能力,而非依赖知识积累的晶体智能。ARC基准上的数据形成鲜明对比:基础LLM无论规模扩大十万倍,得分始终在10%-15%附近徘徊;而同等规模的LRM已将该基准刷满。这说明单纯堆参数遭遇了范式天花板,真正带来质变的是从"猜分布"到"构造程序"的底层机制转变。
大语言模型(LLM)和近来备受关注的大推理模型(LRM)之间,到底差在哪里?一种流行的说法认为,关键在于能否调用符号工具。但这个判断可能抓错了重点。真正的分水岭,藏在二者处理问题的底层范式之中。
转导式 vs 归纳式:两种截然不同的解题思路
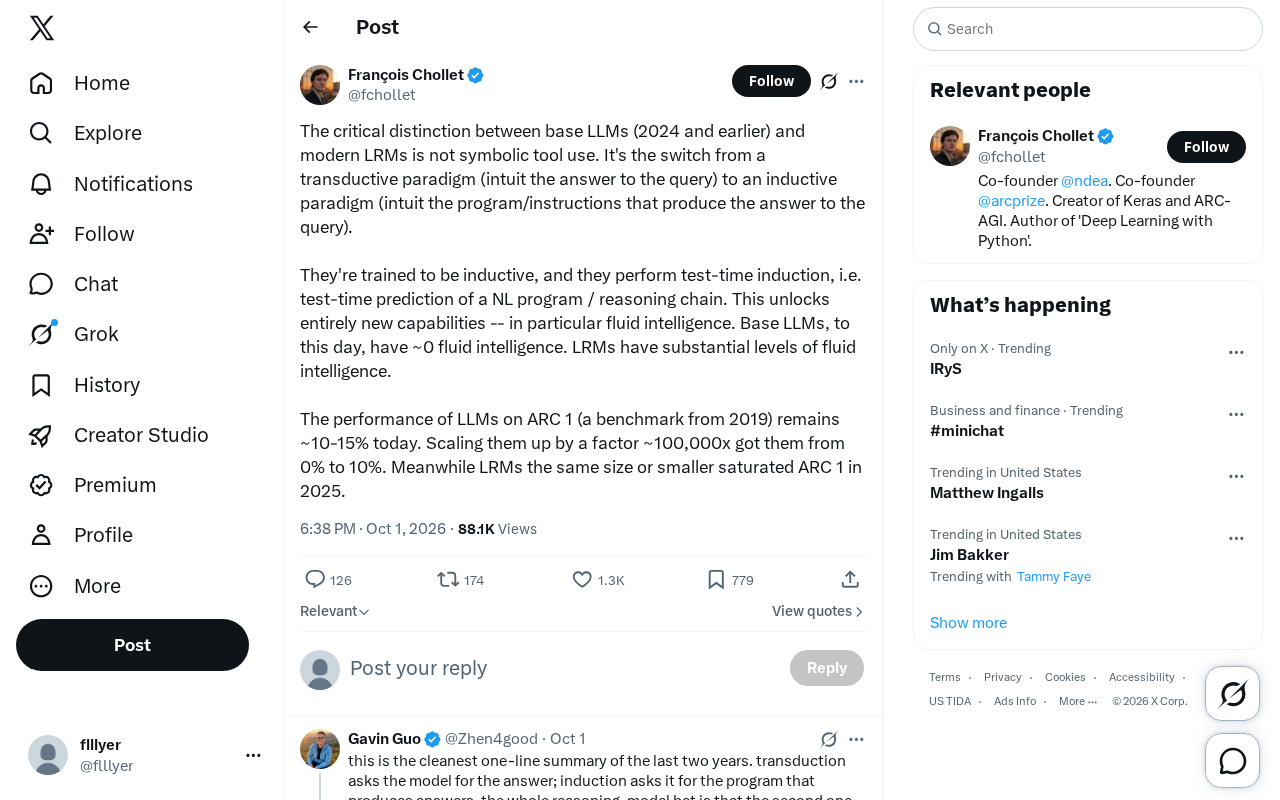
传统的基础大语言模型(可以粗略对应到早期的那一代模型)采用的是转导范式(transductive paradigm)——它们直接凭直觉给出查询的答案。你问一个问题,模型调动海量训练中习得的模式,输出一个它"感觉对"的结果。整个过程更像是一种高度复杂的模式匹配,答案是被直接"猜"出来的。
而现代大推理模型走的是归纳范式(inductive paradigm)。它们不再直接猜答案,而是先凭直觉推断出能够产生答案的"程序"或"指令序列",再执行这套流程得到结果。换句话说,LRM 预测的不是答案本身,而是通往答案的自然语言程序 / 推理链。
这个区别听起来抽象,但影响极其深远。当一个模型学会生成并执行推理步骤,而不是一步到位地蒙出答案时,它应对陌生问题的方式就发生了质变。
"转导"(transduction)一词源自统计学习理论,由Vladimir Vapnik提出,指不推导通用规则、而是直接从已知训练样本映射到特定测试样本的学习方式。与之相对,"归纳"(induction)指从具体案例中提炼出可泛化的规则或程序,再应用到新情况。这两种范式的本质差异在于泛化路径:转导式模型依赖训练分布覆盖测试问题,遇到分布外问题时容易失效;归纳式模型则试图在测试时动态构造解题路径,理论上对未见过的问题有更强的适应力。值得注意的是,在自然语言处理领域,"转导"有时也指序列到序列的映射任务,但此处的用法更接近其统计学习理论的原始含义。
测试时归纳与"流动智能"的解锁
原始观点中提出了一个关键概念:LRM 经过训练成为归纳式模型,并在推理阶段执行测试时归纳(test-time induction)——即在面对新任务时,实时构造出一条推理链或自然语言程序。
这一能力解锁了一种此前模型几乎不具备的东西:流动智能(fluid intelligence)。流动智能指的是在没有既有经验可依赖的情况下,面对全新问题进行推理、发现规律、适应变化的能力。它与依赖已有知识积累的"晶体智能"相对。
原文给出了一个颇具冲击力的论断:基础 LLM 直到今天的流动智能水平仍然接近于零,而 LRM 则具备了相当可观的流动智能。如果这个判断成立,它意味着两类模型在本质能力维度上存在断层,而不仅仅是量级上的差距。
"流动智能"(fluid intelligence)与"晶体智能"(crystallized intelligence)的区分来自心理学家Raymond Cattell在1940年代提出的智力双因素理论。晶体智能指通过学习和经验积累的知识与技能,如词汇量、历史事实;流动智能则指在无先验经验的情况下进行抽象推理、发现模式、解决新问题的能力,与具体知识储量相对独立。在AI语境中借用这一概念,旨在区分两类能力:靠海量训练数据"记住"答案分布(类比晶体智能),以及面对训练集中从未出现过的新型问题时仍能推理求解(类比流动智能)。"测试时归纳"(test-time induction)是实现流动智能的机制——模型不依赖预存知识,而是在推理阶段实时构造解题程序,这种动态生成推理链的过程使模型获得了超越训练分布的泛化能力。
ARC 基准的残酷对比
抽象推理语料库(ARC)是一个专门设计来考验流动智能的基准——它要求模型从极少量示例中归纳出规则,并应用到新样例上。这类任务无法靠记忆训练数据蒙混过关,因此成为检验"真推理"的试金石。
原文列举的数据很能说明问题:
- 基础 LLM 在 ARC 1 上的表现,至今仍停留在约 10%-15%;
- 把模型规模放大约 十万倍,成绩也只是从 0% 爬到 10% 左右;
- 话说回来,同等规模甚至更小的 LRM,已经把 ARC 1 这个基准刷满(saturate)。
这组对比的核心启示在于:单纯堆算力、扩参数,并不能让转导式模型获得流动智能。十万倍的规模扩张只换来十几个百分点的提升,几乎可以认为撞上了范式的天花板。而范式本身的切换——从猜答案到构造推理程序——才带来了质的飞跃。
ARC(Abstraction and Reasoning Corpus)由François Chollet于2019年提出,其设计哲学明确针对当时AI评测体系的根本缺陷:大多数基准可以通过记忆训练数据中的模式来"刷分",而无需真正理解任务。ARC的每道题由数对输入-输出网格图像构成,规律隐含其中,测试者需从3-5个示例推断规则并将其应用到新输入。Chollet设计时刻意使用人类儿童凭直觉即可掌握的基础概念(如对称、计数、物体识别),但对机器学习系统构成极大挑战——因为没有两道题共享相同的解题规则,无法通过记忆范式应对。ARC-AGI 1(即文中所称ARC 1)长期是衡量真实推理能力的重要参照,其"刷满"意味着模型在该集上准确率接近100%,这一成就被视为AI能力的重要里程碑。
这对理解AI进展意味着什么
这一视角提供了一个重新审视近年AI进步的框架。我们往往把模型能力的提升归因于参数更多、数据更大、工具更全,但这里强调的是一个更根本的转变:模型学会了推理的"过程",而不只是记住了答案的"分布"。
对从业者而言,这意味着几点值得思考:
其一,评估模型时,传统的知识类基准可能掩盖了流动智能的缺失,而 ARC 这类任务更能暴露范式差异。其二,如果流动智能确实来自归纳范式与测试时计算,那么未来能力的增长点可能更多在于推理机制的设计,而非盲目扩大模型。其三,所谓"推理模型"的热度并非炒作噱头,其背后对应的是一次真实的能力结构变化。
需要说明的是,上述观点来自单一的社交媒体论述,其中部分提法(如"基础LLM流动智能为零")属于较为强烈的个人判断,仍有讨论空间。但它所提出的转导 vs 归纳框架,以及 ARC 上的实证对比,为我们理解这一代模型的跃迁提供了一个清晰而有价值的切入角度。
相关推荐

NFL为何重金押注旗帜橄榄球?安全与商业的双重博弈
NFL为何重金投资没有擒抱对抗的旗帜橄榄球?本文解析CTE脑病争议、女子体育数十亿美元市场与奥运机遇如何共同驱动联盟布局橄榄球的未来。

Asana浏览器智能体成本降76倍:GPT-6模型优化实测
Asana借助OpenAI的GPT-6 Astra模型与Codex工具,在浏览器智能体测试中将模型成本降低76倍、速度提升5倍。本文解读这一工程优化案例对企业AI落地的成本与性能启示。

@ai-sdk/vue 3.0.303 发布:依赖更新的补丁版本
@ai-sdk/vue 3.0.303 补丁版本发布,核心为依赖项同步升级,核心包 ai 升级至 6.0.303。本文解析该 Vue AI SDK 更新内容及对开发者的意义。