Context Language Models:让AI智能体像编辑文件一样管理上下文

Meta与华盛顿大学提出Context Language Model,让AI智能体像编辑文件一样主动管理自己的上下文,以取代破坏性的传统压缩机制。
上下文窗口容量有限是AI智能体执行长任务的核心瓶颈。传统的"压缩"机制会对历史记录做无差别摘要,导致关键细节在"摘要的摘要"中层层流失。Meta与华盛顿大学提出的Context Language Model给出了另一种思路:赋予智能体主动编辑自身上下文的能力,使其能够精准保留高价值信息、删除或缩短过时内容,将上下文从被动的历史缓冲区变为持续维护的"工作文档"。这一机制的主要代价是破坏前缀缓存,导致推理成本上升。文章作者在本地DGX设备上对该方法进行了实证验证,认为其代表了上下文管理从"压缩"走向"编辑"的重要方向转变,但实际效益仍需更多场景检验。
上下文窗口:智能体绕不过去的瓶颈
上下文管理依然是制约AI智能体性能的最大瓶颈之一。无论模型多强,上下文窗口的容量总是有限的。当一个智能体在执行长任务时逐渐逼近窗口上限,它通常会触发**压缩(compaction)**机制——把此前的对话历史总结、压缩成一段摘要,腾出空间继续工作。
问题就出在这里。压缩本质上是一种有损操作,智能体会丢失大量原本可能有用的细节。更糟的情况是,当任务持续足够久,摘要会被再次摘要,形成"摘要的摘要"。每一层压缩都在稀释信息密度,到最后智能体手里剩下的可能只是一堆模糊的概括,真正关键的工具输出、中间结论早已不知所踪。
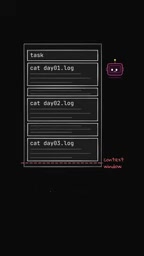
上下文窗口(Context Window)指模型在单次推理中能够"看到"的最大token数量。主流前沿模型的窗口已扩展至数十万甚至百万token量级(如Gemini 1.5 Pro的100万token),但这并不意味着问题消失:更大的窗口带来更高的显存占用和推理延迟,且研究表明模型对窗口中间位置的内容存在"注意力稀释"现象(即"Lost in the Middle"问题),信息并非均匀有效。对于运行时间较长的智能体任务,工具调用的原始输出、代码执行结果、网页抓取内容等会迅速堆积,即便是百万token的窗口也可能在数十轮操作后趋于饱和。因此,如何管理上下文内容的质量,而非单纯依赖扩大窗口,是智能体工程中持续存在的核心挑战。
Context Language Model:让智能体自己编辑上下文
针对这个痛点,来自Meta与华盛顿大学的研究团队提出了一种新思路,论文名为 Context Language Model(上下文语言模型)。核心想法既简单又颇具颠覆性:让智能体把自己的上下文当作一个文件来编辑。
传统做法中,上下文是只读的历史记录,到了上限就整体压缩。而在Context Language Model的范式下,智能体拥有了对上下文的主动编辑权。它可以缩短一段过时的工具输出,也可以用一条简短的笔记整体替换掉某块不再重要的内容。
这种机制的本质差别在于主动性与精准性。压缩是被动的、全局的、无差别的;而自编辑是主动的、局部的、有选择性的。智能体可以根据当前任务判断哪些信息值得保留原貌、哪些可以精简、哪些可以直接丢弃,从而把最相关的信息留在窗口里。
它解决了什么
最直接的收益是避免了"摘要的摘要"这种信息退化链条。因为智能体不是在对整段历史做一刀切的总结,而是针对性地保留对手头任务最有价值的片段。
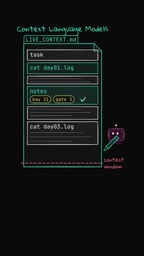
换句话说,上下文不再是一个被动堆积、定期清空的缓冲区,而变成了一份由智能体持续维护、动态优化的"工作文档"。这与人类处理长期任务的方式其实很接近——我们也会不断整理笔记、删掉过时信息、保留关键线索。
代价:打破了前缀缓存
任何方案都有取舍,Context Language Model也不例外。视频作者特别指出了一个重要的工程代价:它会破坏前缀缓存(prefix caching)。
前缀缓存是大模型推理中极其重要的性能优化手段。当上下文的前缀部分保持不变时,推理引擎可以复用之前计算好的KV缓存,大幅降低延迟和计算开销。但Context Language Model的机制恰恰是在不断修改上下文的历史内容——一旦前面的内容被编辑,缓存的前缀就失效了,后续token需要重新计算。
这意味着,用更灵活的上下文管理换取了更高的推理成本。在实际部署中,这种权衡是否划算,要看具体任务对上下文质量的敏感程度,以及推理成本的承受能力。
前缀缓存(Prefix Caching)的工作原理值得稍加展开。大语言模型在处理输入时,Transformer架构会为每个token计算Key-Value(KV)向量,这一过程开销不小。当连续多次请求共享相同的上下文前缀时,推理引擎(如vLLM、SGLang等)可以将这部分KV向量缓存到显存或内存中,后续请求直接读取缓存结果,跳过重复计算。对于AI智能体这类需要反复读取长上下文的场景,前缀缓存往往能带来50%-80%的计算节省,并显著降低首token延迟(TTFT)。Context Language Model每次编辑历史内容都会使已有缓存失效,意味着每一步操作后,模型都需要对整段上下文重新计算KV,推理成本接近"从零开始"。这在长任务、高频编辑的场景下,累积的额外开销可能相当可观。
从论文到实践:本地模型上的验证
理论上的优雅并不等于实践中的有效。为了检验这套方法在真实场景中是否真的管用,视频作者选择在本地模型上进行实验,运行环境是自己的 DGX 设备。
在本地环境测试有几个好处:可以完全掌控模型和推理栈、便于观察前缀缓存失效带来的真实性能影响、也能在隐私可控的前提下反复调试。不过作者在本段素材中并未展开实验的具体结论,而是引导观众去完整视频中了解更详细的实验过程与结果。
小结:上下文管理正在从"压缩"走向"编辑"
Context Language Model代表了一个值得关注的方向转变:智能体对上下文的处理,正在从被动的、破坏性的压缩,转向主动的、精细化的自我编辑。
对于构建长时程、多步骤任务的智能体开发者而言,这提供了一条摆脱"摘要的摘要"困境的新路径。但前缀缓存被打破带来的性能代价也提醒我们,上下文质量与推理效率之间仍存在真实的张力。这项由Meta与华盛顿大学提出的工作,更像是抛出了一个有前景的框架,具体效果还需要更多像本地实验这样的实证检验来回答。
相关推荐

Qodo CEO详解AI代码审查:当「智慧」比代码本身更值钱
OpenAI DevDay 2026访谈:Qodo创始人Itamar Friedman详解AI代码审查如何从提示工程演进到群体工程,用wisdom base编码化工程隐性知识,让审查agent与编程agent协作,重新定义「任务」单位。

OpenAI DevDay 2026:Codex 从单人到多人协作的AI工作革命
OpenAI DevDay 2026 上 Codex 团队提出从单人到多人协作的 AI 工作范式:通过 app shot、持续型 agent dot、space 协作空间与可共享插件,让整个团队与 AI agent 在单一事实来源上协同,摆脱个人成为瓶颈的困境。
Databricks上线Workday Data Connect联邦连接器:Unity Catalog打通HR数据
Databricks宣布Workday Data Connect联邦连接器在Unity Catalog进入公开Beta,支持通过查询联邦直接访问Workday的HR与财务数据,实现统一治理与跨域分析,降低ETL工程负担。