context-mode的98%节省有水分?模型写脚本才是关键

context-mode的98%节省数字真实但属理想上限,实际约91.5%且脚本解析易出错。
独立复现测试显示,开源工具context-mode宣称的98%上下文节省数字本身没有造假,但它来自为每个文件手写摘要脚本的理想基准,并未计入模型生成脚本的上下文成本,实际节省约为91.5%,对小文件甚至出现负优化。测试还发现基准中的git日志样例疑似合成数据,脚本依赖作者名为两个词的假设,在真实提交历史上有30%被错误分类且无任何报错。SQLite索引检索作为安全网,在按字节分块处理JSON时也无法可靠找回关键信息。作者建议采用“让代理写脚本并打印样本行”的模式,并以任务完成质量而非字节节省来评估此类工具。
一款名为context-mode的开源工具最近在开发者社区引发热议。它宣称能为AI编码代理节省98%的上下文窗口占用,这个数字甚至登上了Hacker News头条,获得570点热度。但一项独立复现测试揭示了一个有趣的事实:98%的数字本身没有造假,但它衡量的只是理想情况下的上限——真正的挑战在于让模型写出正确的提取脚本。
context-mode是什么:思路合理但实现存疑
context-mode由Mert Koseoğlu开发,是一个面向Claude Code、Codex、Cursor、Gemini CLI等十余种编码代理的MCP服务器加钩子组合。它的核心思路相当聪明:与其让工具把56KB的页面快照直接塞进对话,不如让代理写一小段脚本,由context-mode在子进程中执行,只把脚本打印的结果返回给模型。大体积输出会被索引到本地SQLite全文搜索库,模型可以后续查询。项目还提供会话记忆功能,可在上下文压缩后存活。
该项目采用Elastic License 2.0源码可见许可,最初以MIT协议发布后于3月切换。在GitHub上曾登上趋势榜,单日新增904星,总星数接近3万。
MCP(Model Context Protocol) 是由 Anthropic 提出并开源的协议,用于标准化 AI 模型与外部工具、数据源之间的连接方式。MCP 服务器相当于一个独立的进程,向模型暴露一组工具(如读写文件、执行命令、查询数据库),模型通过结构化协议发起调用并接收结果。Claude Code、Cursor 等编码代理都支持接入 MCP 服务器。context-mode 正是以 MCP 服务器加钩子的形式工作:代理调用其工具时,实际执行被委托给子进程,返回给模型的只是精简后的结果。这种架构的意义在于,工具的输出不必全部进入对话上下文,从而为上下文压缩提供了技术切口。
98%究竟在衡量什么
这个数字来自项目自带的tests/ecosystem-benchmark.ts。它包含14个场景,每个场景将一个保存好的工具输出(Context7文档、Playwright抓取的Hacker News快照、20个React issue、一次测试运行、nginx日志等)与一份为该文件手写的摘要脚本配对。原始大小是文件本身,上下文大小则是脚本打印出来的内容。
换句话说,98%比较的是文件大小和一个人已经看过文件后写出的脚本输出。这确实公平地衡量了优秀摘要能有多小,但它并没有展示代理实际工作的过程。测试者用项目自带的执行器跑完整个基准,每一行都与BENCHMARK.md精确到字节吻合。
上下文窗口(Context Window) 是语言模型单次推理能处理的最大 token 数量,对话历史、工具调用及其返回值都占用这一额度。编码代理在工作时需要反复读取文件、执行命令、查看日志,这些输出很容易塞满窗口,迫使系统压缩或丢弃早先内容。所谓“节省上下文”本质上是指减少进入窗口的工具输出体积,让更多空间留给推理与任务状态。但节省的前提是模型能信任被裁剪后的摘要——它放弃了直接审视原始数据的能力。context-mode 的 98% 数字正是在这一维度上衡量压缩比,而未把生成摘要脚本本身的 token 消耗计入,因此评估上下文成本时必须把“模型为压缩所写的代码”也算入总开销。
被忽略的上下文成本
真实使用中,那个脚本是由模型自己写的,而脚本本身也是上下文的一部分。它以工具调用的形式进入对话。当前服务器还会把它回显出来:每个ctx_execute_file回复都以文件路径和最多2000字符的代码块开头,然后才是输出。基准测试两者都没算进去。
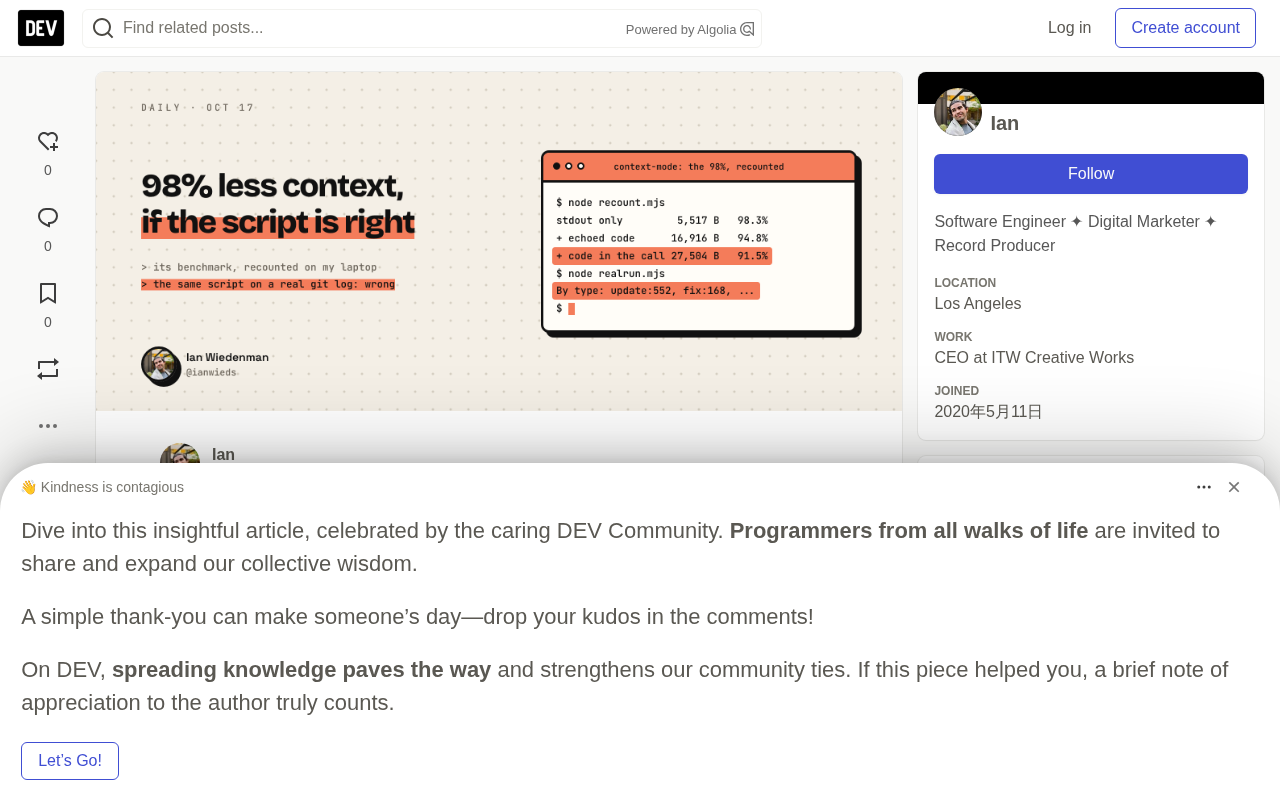
对同样的14个场景重新统计三种口径:原始工具输出322,419字节,仅标准输出5,517字节(节省98.3%),加上回显路径与代码后为16,916字节(节省94.8%),再加上调用中的代码本身则达到27,504字节(节省91.5%)。这些脚本加起来有10,588字节,几乎是它们打印内容的两倍。对于最小的一个400字节网络请求列表,一次往返要花费2,414字节,是它本应压缩内容的六倍。
91.5%依然是可观的节省。问题不在于数字造假,而在于它是最佳情况——测量发生在最难的部分已经完成之后。
脚本才是真正的难点
基准文件的某些样例明显来自真实捕获:React issue与GitHub逐条吻合。但git日志那个样例看起来不像真实数据——31天中有30天恰好每天五个提交,五位作者中有四位是Alice Johnson、Bob Martinez、Charlie Kim和Diana Chen,每个名字都是两个词。
这之所以重要,是因为脚本中的split(" ")[4]假设每行第五个词是提交类型,而这只有在作者名恰好是两个字时才成立。测试者用完全相同的脚本跑context-mode自己的提交历史(2,234次提交,203KB),结果摘要从基准中的107字节变成7,071字节,仍有96.5%的节省,但首批条目是错的:输出显示最常见类型为"update",共552次——实际上有550个提交来自github-actions[bot],一个单词的名字,脚本从"ci: update install stats"中读出了"update"。三段式名字则把作者的姓氏当成了提交类型。总计679个提交(30%)的作者名不是两个词。
没有报错。输出看起来像一份摘要。读它的代理没有理由怀疑,因为那203KB本来能暴露错误的原始数据从未进入它的上下文。这就是取舍:节省来自模型看不到数据,风险也来自同一处。
安全网实测:索引检索也不理想
context-mode对信息丢失的答案是索引。当你传入intent且输出超过5KB时,它把输出分块存入SQLite FTS5,只回复最匹配的段落。测试者用gh issue list --json获取100个开放React issue(303KB),用项目自带的存储建立索引,并按server.ts中intentSearch的方式构造回复,查询意图为"ViewTransition bugs"。
回复是1,667字节,节省99.4%。但100个issue中有八个提到ViewTransition,它们的编号在回复中一个都没出现。因为gh把JSON打印成一行,分块器按字节切分,五个匹配的标题全是"Output",每个预览是原始JSON的120字符切片,大多来自issue正文中间。回复确实提示模型去调用ctx_search获取完整段落,细心的模型会这么做,但那又是另一次往返,而第一回复本身几乎回答不了任何问题。
SQLite FTS5 是 SQLite 内置的全文搜索扩展,支持对文本建立倒排索引并执行关键词匹配查询。context-mode 用它把大体积工具输出分块存储,模型后续可通过查询意图检索相关段落,而不必一次性加载全文。FTS5 的检索质量高度依赖分块策略:如果按固定字节切分,单个块可能横跨多个语义单元,预览文本会失去结构,查询命中率随之下降。对于 JSON 这类单行紧凑格式,按字节分块尤其容易把本应完整呈现的标题、编号与正文割裂,导致检索结果看似相关却无法直接使用。这说明索引作为“安全网”有效的前提,是分块方式与数据格式相匹配。
实用建议
测试者给出的结论是:采用这个思路,但不必依赖这个包。当命令输出很大时,让代理把它写入文件并运行脚本处理,同时要求脚本在计数旁边打印几条原始样本行,这样错误的解析会自己暴露出来。评估这类工具应基于任务而非字节:代理是否得到了正确答案,代价是多少,并把它写的代码也算进去。
该测试的局限也很明确:从未在代理内部实际运行context-mode,因此无法判断真实模型首次写对脚本的概率,也无法评估会话记忆在压缩后的表现。项目GitHub的issue追踪已关闭,无法查阅用户反馈。
这引出一个值得每个AI代理用户思考的问题:当你的代理总结了你从未见过的输出时,你在信任它之前会检查什么?
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。