ContextsBase:给编程AI代理装上"记忆"的上下文基础设施
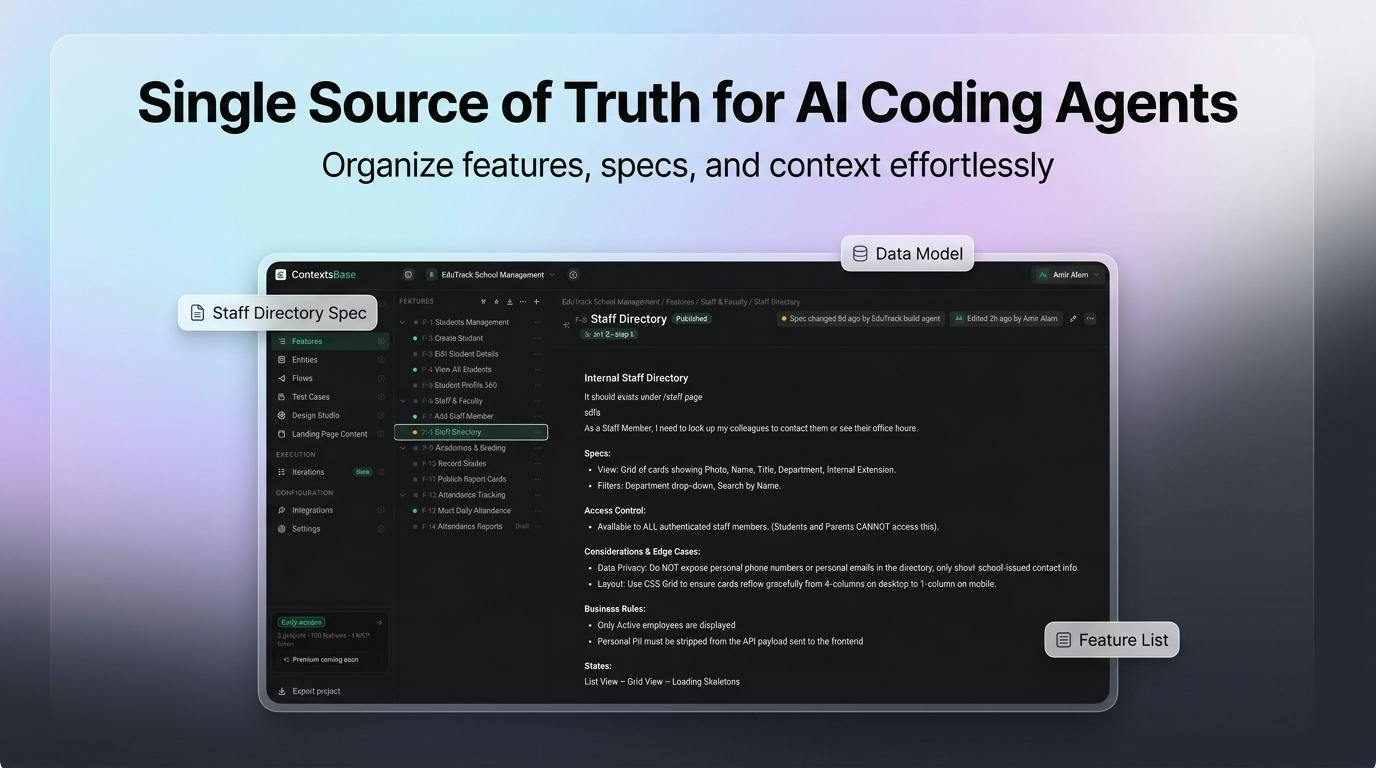
ContextsBase 通过MCP协议为编程AI代理提供结构化的持久上下文基础设施,解决模型"健忘"问题。
编程AI助手普遍存在跨会话记忆缺失的问题,每次对话都需要重新理解项目背景,导致输出不一致。ContextsBase 针对这一痛点,将项目的功能特性、业务规则、数据模型、测试和设计信息集中沉淀为结构化的"上下文库",并通过开放的 MCP 协议对外提供服务,使 Claude、Cursor、Copilot 等主流编程助手都能接入同一套上下文源,避免工具锁定。这一设计反映了AI编程工具链正在分层演进的趋势——竞争焦点从模型能力本身转向"能为模型提供多准确的上下文"。产品目前在 Product Hunt 获得67票,仍处于早期验证阶段,上下文同步机制、多人协作支持等细节有待打磨。
编程AI代理的"健忘症"该怎么治
当下的编程助手已经足够聪明——Claude、Cursor、Copilot都能理解需求、生成代码、修复bug。但它们有一个共同的短板:缺乏对项目的持续记忆。每次会话开始,模型往往要重新"读懂"整个代码库、业务规则和数据结构,上下文断裂导致重复劳动和前后不一致的输出。
最近在 Product Hunt 上线的 ContextsBase 正是瞄准这一痛点。它的定位很直接:为编程代理提供上下文基础设施(Context Infrastructure for Coding Agents)。项目由 Maker Amir Alam 打造,上线后获得 67 票,排在当日榜单第 20 位,归入 Developer Tools、Artificial Intelligence 等分类。
它到底提供了什么
ContextsBase 的核心理念可以用官方的一句话概括:"We supply what they build from."(我们提供它们据以构建的东西)。换句话说,编程AI负责"写",ContextsBase 负责"喂"——把项目的关键上下文结构化地组织好,再交给模型。
根据产品介绍,它管理的上下文涵盖几个维度:
- Features(功能特性):项目要实现的能力清单
- Business rules(业务规则):决定代码逻辑的约束条件
- Data model(数据模型):数据结构与关系定义
- Tests(测试):验证行为的测试用例
- Design(设计):架构与界面设计信息
这些内容不再散落在文档、注释或开发者脑海里,而是被集中沉淀为可供AI调用的"记忆库"。
MCP 协议是关键接口
ContextsBase 最值得关注的技术选择是通过 MCP(Model Context Protocol) 对外提供服务。MCP 是近来被广泛采用的开放协议,用于标准化地把外部数据源和工具接入大模型。
这一设计意味着 ContextsBase 不绑定任何单一模型或IDE。无论你用的是 Claude、Cursor 还是 Copilot,都可以"Bring your own agent",接入同一套上下文源。对开发者而言,这降低了工具锁定的风险——上下文资产沉淀在 ContextsBase 里,而前端的编程助手可以随需求自由切换。
从产品思路看,这反映出AI编程工具链正在分层:底层是模型能力,中间是像 MCP 这样的连接协议,而 ContextsBase 试图占据"上下文中枢"这一层。
MCP(Model Context Protocol)由 Anthropic 于2024年底提出并开源,旨在解决大模型与外部工具、数据源之间的集成碎片化问题。在此之前,每个AI应用都需要为不同的数据源单独编写适配代码,维护成本极高。MCP 定义了一套统一的客户端-服务器架构:模型或AI代理作为客户端,外部工具、数据库、文件系统等作为服务器,两者之间通过标准化消息格式通信。开发者只需实现一次 MCP 服务端,理论上所有支持 MCP 的模型或IDE都能直接调用,无需重复适配。目前 Claude、Cursor 等主流工具已陆续宣布支持 MCP,这也是 ContextsBase 选择它作为接口的现实基础——押注一个正在被行业收敛接受的标准,比自建私有协议的生态风险要低得多。
为什么"上下文"会成为新战场
过去一年,编程AI的竞争焦点从"模型有多强"逐渐转向"模型能拿到多少准确的上下文"。再强的模型,如果不了解项目的业务规则和数据结构,也只能生成看似合理却经不起推敲的代码。
ContextsBase 把 features、rules、data model、tests、design 打包成结构化上下文,本质上是在解决"AI幻觉"和"上下文丢失"这两个工程化难题。它让代理生成的代码更贴合项目实际约束,而不是凭空发挥。
这种"上下文即基础设施"的思路,与向量数据库、记忆层(memory layer)等方向属于同一波趋势——大家都在为AI补齐长期记忆和领域知识这块拼图。
向量数据库与记忆层(Memory Layer)是理解这一趋势的重要背景。向量数据库(如 Pinecone、Weaviate、pgvector)将文本、代码等非结构化内容转化为高维数值向量存储,使模型能够通过语义相似度而非关键词检索找到相关上下文,是 RAG(Retrieval-Augmented Generation,检索增强生成)架构的核心组件。记忆层则是在此基础上更进一步,试图为AI代理提供跨会话的持久化记忆,代表性项目有 Mem0、LangMem 等。ContextsBase 与这些方案的差异在于切入点不同:向量数据库和记忆层更偏向通用基础设施,而 ContextsBase 专注于编程场景,将上下文预先结构化为功能、规则、数据模型等语义明确的分类,减少模型在检索时的歧义,本质上是在"原材料加工"环节做了更多工程化的工作。
现阶段的观察与保留
需要说明的是,ContextsBase 目前仍是早期产品。Product Hunt 上 67 票、1 条评论的数据规模,说明它尚处在验证阶段,实际使用体验、上下文更新机制、多人协作场景下的表现等细节,公开信息还很有限。
对开发者来说,几个值得进一步观察的问题包括:上下文如何保持与代码库的同步、结构化维护的成本有多高、以及它相比直接在仓库里放 markdown 文档究竟能带来多大增量价值。这些都需要真实上手后才能判断。
小结
ContextsBase 代表了AI编程工具演进的一个清晰方向:把上下文从"临时喂给模型的一次性输入"升级为"可持续维护的基础设施"。借助 MCP 协议保持开放兼容,它试图成为各类编程代理背后的共享记忆层。
概念足够抓人,但产品仍需时间打磨。对于正在苦恼于AI助手"记性差"的团队,它至少提供了一种值得关注的解法。
相关推荐
Robinhood高管将亮相TechCrunch Disrupt 2026谈现代金融消费者
Robinhood产品营销副总裁Abhishek Fatehpuria将亮相TechCrunch Disrupt 2026,分享如何赢得现代金融消费者。早鸟报名9月25日前最高省200美元。
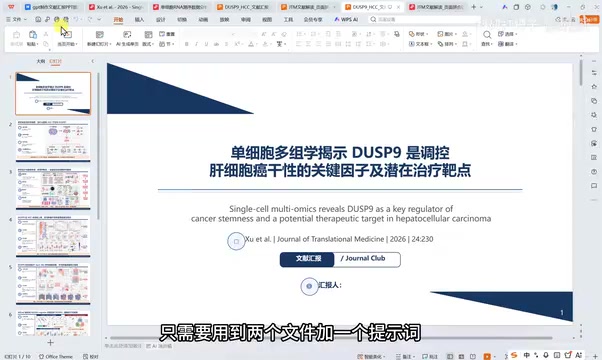
用ChatGPT批量生成可编辑学术PPT:科研人的效率工具实战
分享用ChatGPT批量生成可编辑学术PPT的完整流程:只需文献PDF、PPT模板和一段提示词,先出图再拼合转可编辑,半小时完成美观汇报PPT,并对比了ChatGPT与Codex的适用场景。
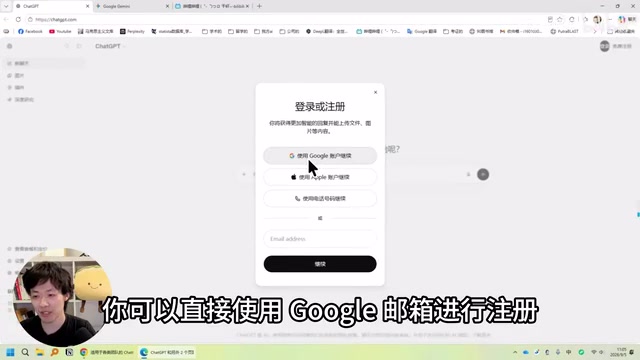
GPT-6满血版使用教程:通过GPT-work开启Ultra最高思考强度
本文详解如何付费使用GPT-6满血版:从Apple ID注册、Plus/Pro套餐充值,到通过GPT-work客户端工作模式开启GPT-6 Ultra最高思考强度与完整权限,并附网页版隐藏解锁路径。