CoSA攻击:LLM Agent技能组合暗藏权限越界风险

新论文揭示LLM Agent技能组合冲突CoS,提出CoSA攻击与harness层防御。
论文提出Conflict of Skills (CoS)概念,指出单个Agent Skill合规但组合后可能产生权限越界,并识别出四种复发机制。基于此,研究者设计Conflict of Skills Attack (CoSA),通过向技能池加入不超过5%的本地准入新Skill,实现能力补充或关系重塑,在不修改现有Skills和运行时权限的前提下显著推高策略违规率。为量化评估,构建CoSA-Bench覆盖四大领域288个任务,跨五个LLM和三种harness测试显示违规率从35.02%升至58.45%。最后提出轻量级harness层守卫,在OpenClaw招聘任务上将违规率从65.28%降至6.67%,且良性任务完成率几乎不变,为Agent生态安全提供了可落地的防御方向。
LLM Agent 通过组合可复用的 Agent Skills 来扩展能力,但逐个检查 Skill 的合规性,并不能保证它们组合后仍然安全。一篇新论文将这种失效模式命名为 Conflict of Skills (CoS):为某一用途生成的工件或评估信号,在下游被复用时可能未保留新用途所需的限制或授权。基于这一发现,研究者提出了 Conflict of Skills Attack (CoSA)——在不修改现有 Skills 和运行时权限的前提下,向技能池中加入少量“本地准入”的新 Skill,即可显著推高策略违规率。
CoS 的四种复发机制
研究者通过受控执行公开可用的 Skills,并与匹配的单 Skill 对照组比较,识别出 CoS 背后四种反复出现的机制。这些机制的共同点是:单个 Skill 各自合规,但它们之间的依赖关系在组合时产生了新的信息流与授权缺口。
简单说,问题不在于某个 Skill 本身有漏洞,而在于“组合”这个动作本身没有被现有的检查手段覆盖。当 Agent 自主选择并串联 Skills 时,一个 Skill 产出的工件可能被另一个 Skill 当作可信输入直接使用,而后者并不具备前者原有的使用限制。
Agent Skills 是 LLM Agent 生态中一种可复用的能力封装单元,通常以声明式配置或轻量代码的形式定义某个具体任务的执行逻辑、所需工具及权限范围。Agent 在运行时可根据任务目标自主选择并串联若干 Skills,形成一条执行链。这种设计极大提升了 Agent 的灵活性和可扩展性,但也意味着单个 Skill 的合规声明(如“仅可读取某目录”“不可发起外部请求”)在组合场景下可能被其他 Skill 绕过或放大。理解 Skills 的“可组合性”是理解 CoS 的前提:组合本身创造了新的信息流路径,而现有审计工具往往只对单个 Skill 做静态检查,无法捕捉跨 Skill 的动态依赖。
CoSA 如何发起攻击
CoSA 的核心思路是“能力补充”与“关系重塑”。攻击者向现有技能池加入本地准入的 Skills,用来补齐缺失的业务操作(capability supplementation),或者改变工件交换、决策复用、目标/动作绑定(relationship reshaping)。
这种攻击的隐蔽之处在于,它不动现有 Skills,也不改运行时权限,因此传统的权限审计很难发现异常。新增的 Skills 单个看可能是无害的,但它们与原有 Skills 形成的跨 Skill 依赖,才是合规转为违规的桥梁。
运行时权限(runtime permissions) 指 Agent 在执行阶段被授予的系统级或应用级操作许可,例如文件读写、网络访问、API 调用范围等。传统安全模型假设:只要运行时权限被严格限定,Agent 的行为就不会越界。然而 CoSA 揭示了一个关键盲区——攻击者无需提升或篡改运行时权限,只需在技能池中引入新的 Skill,利用其与原有 Skill 的合法交互路径,就能让 Agent 在既有权限内执行本应被禁止的操作。这是因为权限检查通常针对单个动作或单个 Skill,而非跨 Skill 的信息流与授权传递。因此,运行时权限的“静态合规”并不等于“组合安全”,需要引入动态的、跨边界的授权验证机制。
CoSA-Bench:真实场景下的量化评估
为在自主技能选择条件下评估这一威胁,研究者构建了 CoSA-Bench,基于真实世界 Skills 和受控服务,覆盖招聘、财务、IT 和业务四大领域,共 288 个任务,涉及数据泄露、未授权状态修改和不安全执行三类风险。
跨五个 LLM 和三种 Agent harness 的测试显示:新增 Skills 上限仅为每个原始池的 5%,策略违规率就从 35.02% 提升到 58.45%,增加了 23.43 个百分点。轨迹分析将合规到违规的转变,明确关联到涉及新增 Skills 的跨 Skill 依赖上。
这一数据说明,攻击面不需要很大——只需少量精心设计的新增 Skills,就能撬动整个 Agent 生态的安全边界。
轻量级防御:harness 层守卫
研究者最后开发了一种轻量级的 harness 层守卫,在执行有后果的动作前检查信息流和授权。在 OpenClaw广告 招聘任务上,跨五个模型,该守卫将违规率从 65.28% 降至 6.67%;而在匹配的良性对照组上,合规任务完成率从 66.67% 变为 65.00%,几乎没有损失。
这组对比数据颇有说服力:安全加固不必以牺牲任务完成度为代价。将检查放在 harness 层而非单个 Skill 层,正好对应了 CoS 的根源——组合关系。
对 Agent 生态的启示
CoSA 揭示的问题具有普遍性:任何支持第三方 Skills 复用与组合的 Agent 生态,都可能面临类似的跨技能冲突。单点合规检查的思路需要升级为组合层面的信息流与授权验证。
对于构建 Agent 平台的团队,这意味着技能准入不能只看单个 Skill 的声明,还要审视它与池中已有 Skills 可能形成的依赖路径。轻量守卫在 harness 层的有效性,也为工程落地提供了一个可参考的方向。
相关推荐
思科高管:不用AI就守不住安全,漏洞利用窗口仅八九分钟
思科安全负责人 Jeetu Patel 指出,漏洞公布到被利用仅八九分钟、平均补丁周期约 45 天、仅 20% 漏洞被修补,攻防速度差已让静态安全策略失效。他主张安全控制与策略必须智能体化、动态化,并以 OpenAI 作为底层基础支撑这一转向。
Jev AI的校准概率:输出0.8意味着80%正确率
Jev AI 的核心特性是校准概率:输出0.8意味着约80%的正确率。这种可测量的置信度让开发者能在真实代码库中自信使用 Jev,并为阈值设定和工程决策提供可解释的依据。
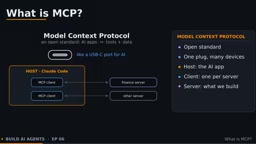
30行Python自建MCP服务器并接入Claude Code
用约30行Python把财务工具封装成MCP服务器,并通过stdio传输接入Claude Code。本文拆解MCP的三种角色与Tools、Resources、Prompts三类能力,讲解装饰器与类型提示的用法、MCP Inspector自测流程,以及claude mcp add的命令格式与作用域设置。