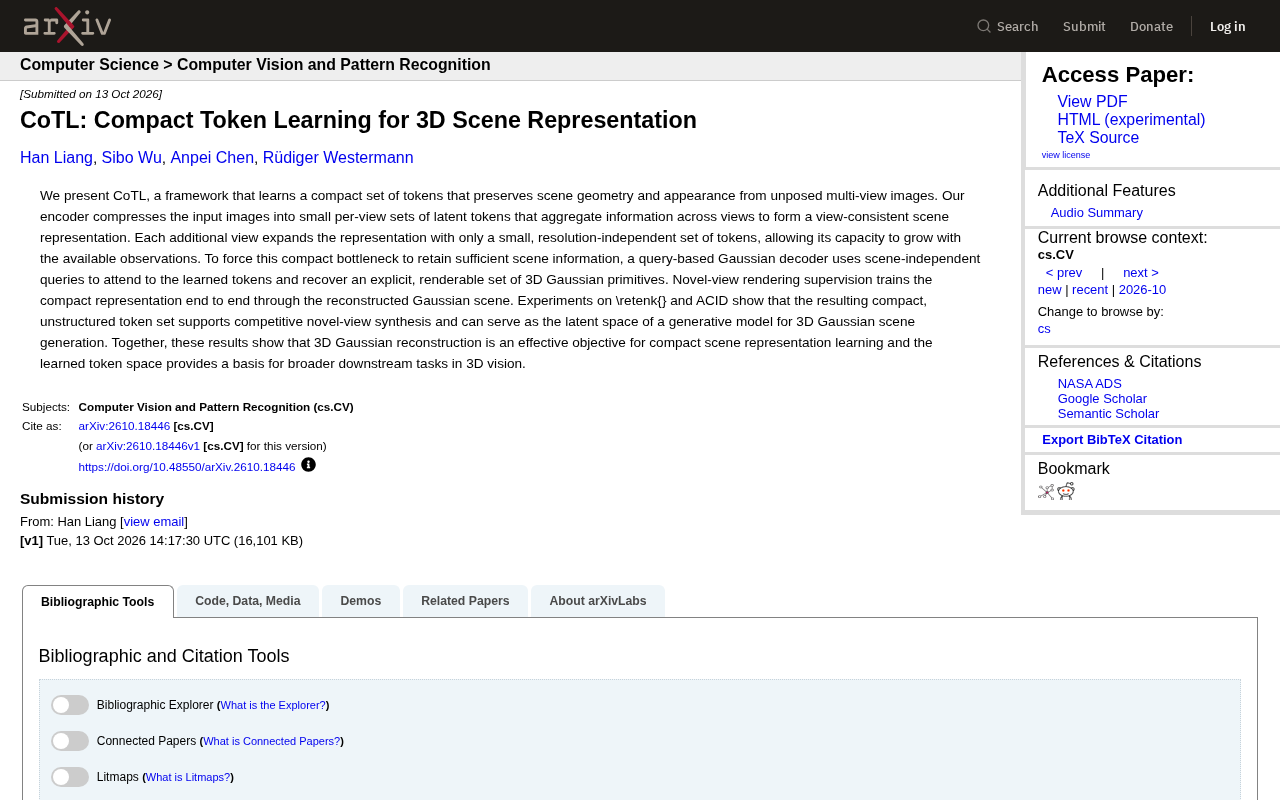
CoTL:紧凑Token学习重塑3D场景表示

CoTL用每视角少量紧凑Token表示3D场景,兼顾新视角合成与生成。
CoTL提出一种紧凑的3D场景表示思路:针对现有神经渲染方法参数量随场景复杂度膨胀的问题,它用一小组与分辨率无关的潜在Token编码多视角图像,表示容量随观测数量增量式增长。编码器跨视角聚合信息形成视角一致的表示;查询式高斯解码器通过场景无关查询访问Token,恢复出可渲染的3D高斯原语,并以渲染监督端到端训练,防止Token退化。实验表明,这一紧凑Token集合既能支持有竞争力的新视角合成,又可作为生成模型的潜在空间用于3D高斯场景生成,验证了以3D高斯重建作为紧凑表示学习目标的有效性。
从密集像素到紧凑Token:3D场景表示的新思路
3D场景重建近年来在神经渲染领域取得了长足进步,但如何用更高效的方式表示场景,始终是一个核心问题。多数现有方法依赖密集的隐式表示或大规模高斯点云,参数量随场景复杂度快速增长。CoTL(Compact Token Learning)提出了一种不同的路径:用一小组紧凑的潜在Token来保留场景的几何与外观信息,让表示能力随观测数量的增加而自然扩展。
这项工作的出发点很明确——如果场景表示足够紧凑,它不仅能支持新视角合成,还能作为生成模型的潜在空间,为更广泛的下游3D视觉任务提供基础。
3D高斯泼溅(3D Gaussian Splatting) 是理解本文的重要背景。传统神经辐射场(NeRF)依赖多层感知机隐式地查询每个空间点的颜色与密度,渲染时需要沿光线密集采样,计算开销大且表示不显式。3D高斯泼溅改用一组显式的3D高斯原语来表示场景:每个高斯带有位置、协方差(决定形状与朝向)、不透明度以及球谐系数(决定视角相关的颜色)。渲染时将这些高斯按深度排序并投影到图像平面进行光栅化混合,从而在保持高质量的同时实现实时渲染。其代价是原语数量往往达到百万级,参数量随场景规模迅速膨胀,存储与传输负担较重。CoTL正是针对这一痛点,尝试用少量潜在Token替代或压缩海量高斯原语,因此理解高斯的显式、可渲染特性,是把握本文“查询式高斯解码器”设计动机的关键。
编码器设计:每个视角只贡献少量Token
CoTL的核心机制在于其编码器。给定一组无位姿的多视角图像,编码器将每张图像压缩为一个小型的潜在Token集合。这些Token并非孤立地描述单张图像,而是跨视角聚合信息,形成视角一致(view-consistent)的场景表示。
关键设计在于:每增加一个视角,表示只需扩展一小部分与分辨率无关的Token。这意味着表示的容量可以随可用观测的数量灵活增长,而不是被固定大小的网络参数所限制。这种增量式的表示方式,让CoTL在多视角输入场景下具备天然的伸缩性。
无位姿(pose-free)输入 是本文编码器的一个隐含前提,值得说明。多数新视角合成方法假设相机内外参已知,位姿由SfM或SLAM预先求得。而CoTL直接以一组无位姿的多视角图像为输入,意味着编码器在聚合Token的过程中,还需要隐式地推断或吸收视角间的几何关系,才能形成视角一致的表示。这提高了任务难度,但也让方法更贴近真实场景——例如随手拍摄的照片集、网络图片等通常不带标定的相机参数。跨视角信息聚合因此不仅是特征融合,更承担了隐式几何对齐的角色,这也是其“每视角仅贡献少量与分辨率无关的Token”设计能成立的原因之一:Token承载的是场景级的共享结构,而非单张图像的独立描述。
查询式高斯解码器:从Token恢复可渲染场景
紧凑的瓶颈表示面临一个显而易见的风险:信息压缩过度,导致场景细节丢失。CoTL用查询式高斯解码器(query-based Gaussian decoder)来应对这一问题,并借此反向约束编码器保留足够的场景信息。
解码器使用与场景无关的查询(scene-independent queries),通过注意力机制访问学习到的Token,恢复出一组显式、可渲染的3D高斯原语。新视角渲染的监督信号则穿过重建的高斯场景,端到端地训练整个紧凑表示。这种「编码压缩—解码重建—渲染监督」的闭环,确保Token空间不会退化为无意义的低维嵌入,而是真正承载了可渲染的3D结构。
查询式解码(query-based decoding)与感知机(Perceiver)式架构 是这里的核心技术范式。所谓场景无关的查询,指一组可学习的、不依赖具体场景的向量作为注意力机制的查询端,去“读取”编码器产出的紧凑Token(键与值)。由于查询数量固定且与输入分辨率解耦,解码出的高斯原语数量也相对可控。这种设计借鉴了Perceiver等潜在瓶颈架构的思想:用少量潜在单元压缩任意规模输入,再通过交叉注意力还原到目标模态。其优势在于计算复杂度不再随输入像素数线性增长,同时强制信息经由瓶颈,从而学到更抽象、更结构化的表示。渲染监督反向传播时,梯度需穿过解码出的高斯场景,这构成了对编码器“必须保留可渲染信息”的硬约束,避免Token退化为无意义的低维嵌入。
实验验证:重建与生成的双重能力
论文在ACID等数据集上进行了实验。结果显示,这种紧凑、非结构化的Token集合不仅支持具有竞争力的新视角合成效果,还可以作为生成模型的潜在空间,用于3D高斯场景生成。
这一点值得关注:同一个Token空间既能做重建,又能做生成,说明它捕捉到了场景的结构性规律,而非仅仅拟合了训练视角。3D高斯重建在此被证明是一种有效的紧凑场景表示学习目标,而学到的Token空间为3D视觉中更广泛的下游任务提供了基础。
潜在空间用于生成(latent-space generation) 是本文相较于纯重建方法的关键差异,需补充其意义。传统上,3D生成模型多直接在点云、体素或高斯原语空间上训练扩散或自回归模型,但这些表示维度高、结构杂乱,生成建模困难。若一个编码器能把场景压成紧凑、规整且语义一致的Token序列,那么该Token空间就可以直接复用成熟的序列生成模型(如扩散模型、Transformer自回归)来学习其分布,从而“生成新的3D高斯场景”。ACID数据集常被用于此类场景级生成与编辑研究。CoTL同时支持重建与生成,说明其Token空间不仅保留了可渲染性,还具备良好的统计结构,这正是“重建作为表示学习目标”这一思路的实际价值所在。
紧凑表示的意义与局限
CoTL的价值在于它回应了一个实际问题:3D场景表示不必总是越做越大。通过将表示压缩为与视角数量线性相关的少量Token,它为存储、传输和生成任务都留出了空间。
不过,从摘要信息来看,仍有一些问题有待进一步了解:紧凑Token在极端稀疏视角或大尺度场景下的表现如何,Token数量与重建质量之间的权衡曲线是否平滑,以及生成任务上的具体指标对比。这些细节需要查阅完整论文才能判断。总体而言,CoTL为紧凑3D表示学习提供了一个值得关注的方向,其将重建作为表示学习目标的思路尤其具有启发性。
相关推荐

iPhone Duo上手体验:2000美元的小屏折叠,值不值?
YouTube博主Allison分享iPhone Duo上手体验:双屏多任务效率翻倍,视频观看体验出色,磨砂质感好评,但机身偏厚、单屏操作偏小,2000美元定价进入MacBook区间,属于奢侈品定位。

Sentry广告笑疯开发者:On-call也能变有趣?
Sentry广告短片以开发者On-call焦虑为切入点,用幽默对话展示其将错误、日志、链路、指标、录屏和发布记录集中一处的可观测性能力,引发开发者社区共鸣。
LLM应用越改越糟?三步构建有效评估体系
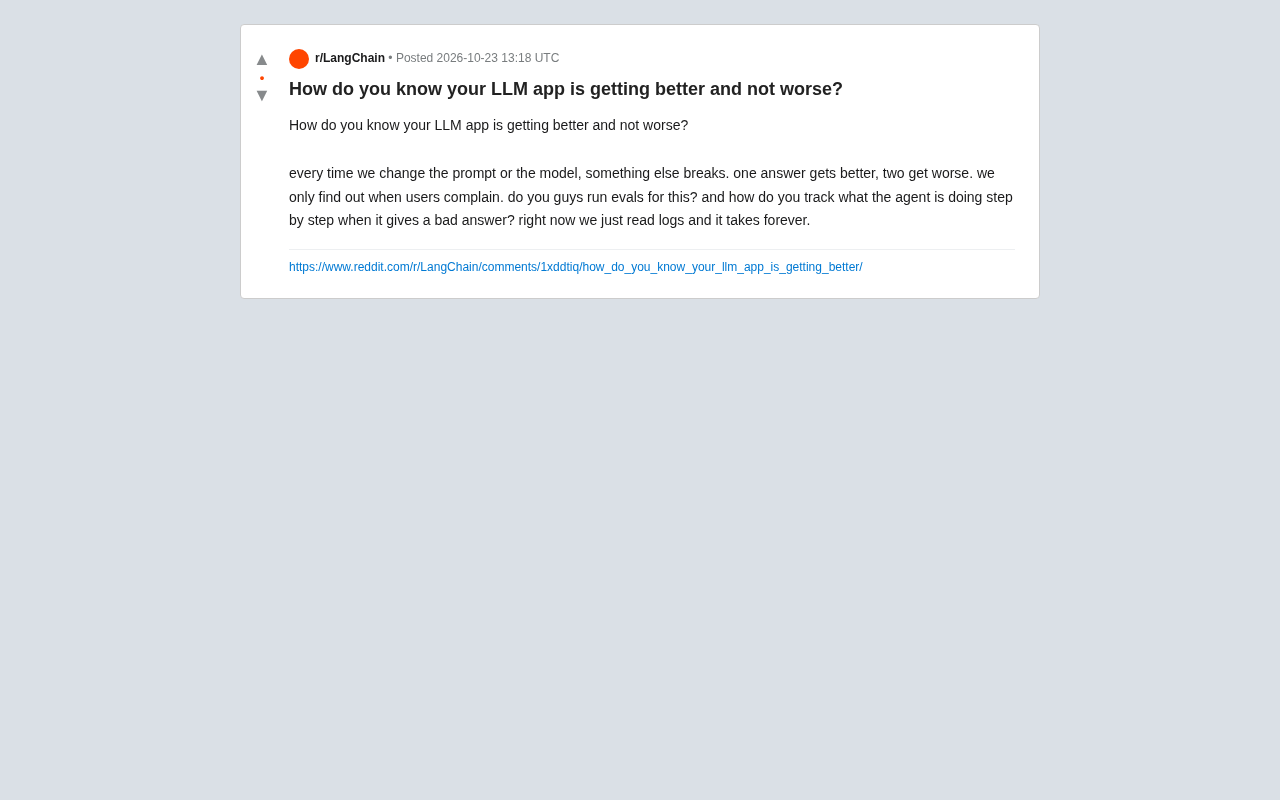
LLM应用迭代时如何判断变好还是变坏?本文基于Reddit开发者讨论,详解构建测试集、自动化回归评估、LLM-as-judge评分与结构化追踪智能体行为,建立从生产反馈到评估追踪的持续闭环。