Coze智能体搭建:一文掌握插件、工作流与节点

基于B站课程拆解Coze智能体搭建的插件、提示词、节点与工作流核心路径。
本文基于B站一节Coze课程,系统梳理了智能体搭建的关键概念。文章以“盖房子”类比开篇,将插件比作砖块、节点比作钢筋,说明插件是可独立部署的服务,调用时只需理解输入输出参数。提示词分为系统与用户两类,系统提示词定义角色与限制,直接影响回复稳定性。节点部分重点对比了批处理节点的并行批量操作与循环节点的串行逐个处理,并解释变量聚合节点解决多输入单输出问题。文章还澄清了工作流与对话流的区别:前者用于功能类请求、不支持角色配置,后者支持角色配置、适合对话式应用。最后指出触发器仅对飞书渠道生效,需发布到飞书才能执行定时或事件任务。
在AI智能体开发领域,Coze(扣子)凭借低门槛、可视化的特点,吸引了不少非科班出身的创作者。B站上一节关于Coze节点介绍的课程,以“3小时从零学会搭建”为主题,系统梳理了插件、提示词、工作流等核心概念。本文基于该课程内容,结合截图与实操逻辑,为你拆解Coze智能体搭建的关键路径。
从“盖房子”理解Coze的插件逻辑
课程开篇将Coze的搭建过程比作盖房子:插件是砖块,节点是钢筋,理解各组件之间的逻辑关系,才能堆砌出想要的功能。插件在Coze中是一个可以独立开发和线上部署的服务,用户无需从零编码,直接调用即可。
以“获取实时新闻”为例,在工作流中添加“头条搜索”插件,传入关键词和数量参数,就能完成一次搜索任务。据B站课程讲解,插件的价值在于“把复杂能力封装成简单调用”,而开发者只需要理解输入参数和输出结果。
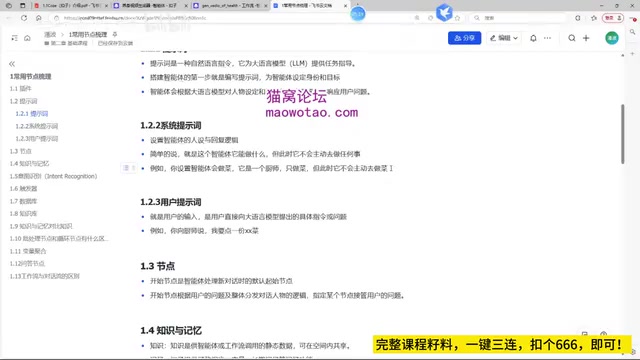
对于插件无法覆盖的个性化需求,课程提到可以自行开发插件。当前大模型降低了代码门槛,非科班创作者也能借助AI生成插件代码。这一观点在YouTube多个Coze教程中也有呼应,属于多源共识:低代码+AI辅助正在压缩智能体开发的学习曲线。
在Coze中,插件与工具、API常被混用,实际存在层次差异。插件是面向Coze平台封装的完整服务,通常包含一个或多个工具(tool),每个工具对应一个具体的API端点或函数,拥有独立的输入参数和输出结构。工作流节点调用插件时,实际选择的是某个工具,而非整个插件。此外,Coze支持通过OpenAPI规范导入外部API,将其自动转换为插件工具,这降低了自行开发插件的成本。理解插件与工具的区分,有助于在搭建工作流时准确定位参数来源,避免因选错工具而导致参数不匹配。
提示词:系统与用户指令的分工
提示词是智能体的“行为说明书”。课程将其分为两类:系统提示词和用户提示词。系统提示词定义角色、技能、限制和输出模式,例如设定“你是中医养生专家,目标是提供饮食建议,限制为不涉及医疗诊断”;用户提示词则是实际输入的问题或指令。
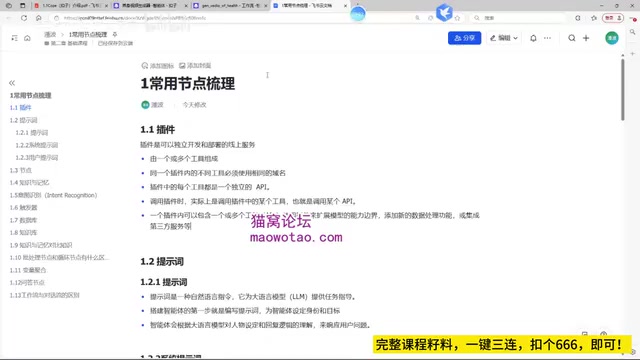
这种分层设计在多份Coze官方文档和社区教程中均有体现,是行业内的标准做法。课程特别指出,系统提示词的质量直接决定智能体回复的稳定性,建议用结构化语言明确角色边界。
系统提示词与用户提示词的分离,背后是大模型对话消息的角色机制。大多数大模型API采用system、user、assistant三种角色:system消息在对话开始前设定模型的行为框架,user消息承载用户实际输入,assistant消息记录模型历史回复。Coze的系统提示词对应system角色,优先级高于用户输入,且在多轮对话中持续生效;用户提示词对应user角色,每轮可变。这种设计使得系统提示词能够稳定约束智能体行为,但也意味着系统提示词过长会挤占上下文窗口,影响模型对用户输入的理解。因此,结构化、精简的系统提示词比堆砌规则更有效。
核心节点解析:循环、批处理与变量聚合
节点是工作流的执行单元。课程重点对比了循环节点和批处理节点的差异:批处理节点用于对数据集进行一次性并行操作,适合批量任务;循环节点则按顺序逐个处理,适合需要次序执行的场景。两者在数据量较大时尤其关键。
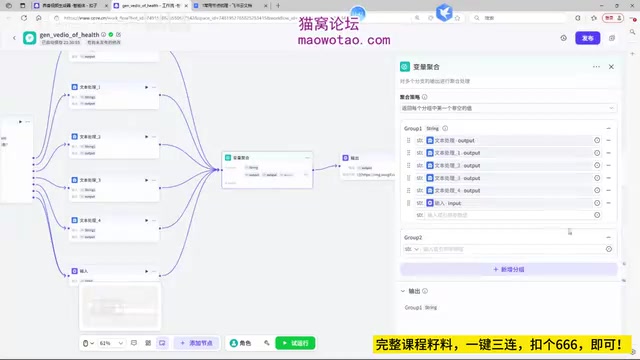
变量聚合节点则解决“多输入单输出”的问题。一个分组内所有结果只返回第一个非空值,多个分组则分别返回各自分组的第一个非空值。
问答节点用于给用户提供选项分支,例如养生视频生成场景中,让用户选择“压力大”或“失眠”等方向,不同选择走不同链路。课程展示了直接回答和选项回答两种模式,前者直接输入文本,后者需要逐项配置选项。
循环节点与批处理节点的差异,本质上是串行与并行的执行模型差异。批处理节点将数据集拆分为多个子任务,并发执行,适合无状态、互不依赖的批量操作,例如对一组关键词同时调用搜索插件,其执行时间不随数据量线性增长,但受平台并发上限约束。循环节点则维护迭代状态,按顺序逐条处理,适合需要累积结果或依赖前序输出的场景,例如逐条生成视频脚本并汇总。选择时需权衡执行效率与状态依赖:并行批处理速度快但无法共享中间变量,串行循环灵活但耗时更长。变量聚合节点则常与这两类节点配合,用于收敛分支输出。
工作流与对话流:场景决定形态
课程澄清了一个常见混淆:工作流和对话流并非同一概念。工作流用于功能类请求,顺序执行节点,不支持角色配置;对话流是基于对话场景的特殊工作流,支持角色配置,开始节点需要指定会话。据课程讲解,对话流更适合抖音等平台的对话式应用,而工作流适合后台自动化任务。
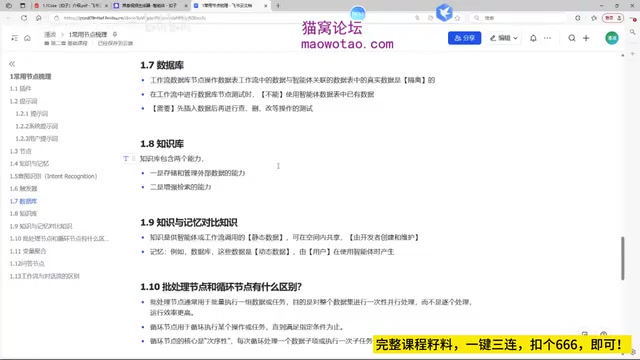
知识库与数据库节点则分别承担外部知识存储和结构化数据管理。课程提醒,数据库在工具调用中测试时,需先插入数据再进行增删改查,不能直接使用智能体数据表中的已有数据。
知识库与数据库在Coze中承担不同层次的记忆职责。知识库面向非结构化文本,通过向量化检索将文档切片与用户问题做语义匹配,适合FAQ、产品手册等静态知识的召回;数据库则是结构化表存储,支持增删改查,适合记录用户偏好、订单状态等需要精确读写的动态数据。两者常在同一智能体中协同:知识库提供背景知识,数据库记录会话中的个性化信息。课程提醒的“先插入数据再测试”正源于数据库工具调用依赖真实表结构,空表会导致查询返回空结果,掩盖逻辑错误。
触发器与发布渠道的绑定关系
触发器分为定时触发和事件触发。定时触发让智能体在指定时间执行任务,例如每天早上8点推送新闻;事件触发则在服务端收到HTTP请求时自动执行。课程强调,触发器功能仅对飞书渠道生效,只有将智能体发布到飞书,才能自动执行触发任务,并将结果写入飞书表格或文章。
这一限制在多篇社区教程中被反复提及,属于平台当前的明确规则。对于希望实现自动化推送的开发者,飞书是必经渠道。
写在最后
Coze的节点体系并不复杂,但组合方式决定了智能体的能力边界。从插件调用到提示词设计,从循环分批到工作流与对话流的选择,每一步都需要对业务场景有清晰判断。课程提供的“盖房子”类比,或许是最直观的入门心法:先看懂材料,再动手搭结构。
本文基于B站公开课程内容整理,结合多源教程交叉验证。文中观点仅代表技术探讨,具体功能以Coze官方文档为准。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。