CPU、GPU、TPU的本质差异与最佳适用场景详解

为什么同一任务在不同芯片上表现迥异?
同样的计算任务,在CPU上以一种方式运行,在GPU上表现截然不同,而在TPU上有时还能更快。根本原因在于:每种芯片都针对不同类型的计算做了深度优化。CPU处理通用任务,GPU擅长大规模并行数学运算,TPU则专为特定机器学习工作负载而设计。
理解CPU、GPU、TPU三者的差异,不仅是硬件知识的积累,更是现代AI系统架构设计的核心决策依据。
CPU:通用计算的瑞士军刀
CPU是通用处理器,为灵活性而生。它负责处理Web服务器、数据库、操作系统和应用逻辑——这类工作的特点是每一步都可能不同:读取请求、检查认证、查找数据、应用业务规则、返回响应。这涉及大量的分支判断和决策,而CPU正是为此设计的。
CPU拥有少量但极其强大的核心,每个核心都能高效处理多种不同任务。它的优势在于"什么都能做,而且做得不错"。但当面对需要对大量数据重复执行相同数学运算的场景时,CPU的通用性反而成了性能瓶颈。
CPU微架构:为何通用性如此强大
现代CPU之所以能高效处理复杂的控制流任务,依赖于数十年积累的微架构优化技术。流水线(Pipeline) 将指令执行分解为取指、解码、执行、访存、写回等多个阶段,使多条指令能够重叠执行。分支预测(Branch Prediction) 通过历史模式分析,在条件判断结果出来之前就预测性地执行后续指令——现代CPU的分支预测准确率可达97%以上。乱序执行(Out-of-Order Execution) 允许CPU动态调整指令执行顺序,当某条指令等待数据时,先执行后续不依赖该数据的指令,最大化利用执行单元。
此外,CPU还配备了多级缓存体系(L1/L2/L3 Cache),用于弥补处理器速度与主存速度之间的巨大鸿沟。这些复杂的控制逻辑占据了CPU芯片面积的大部分,留给纯计算单元的空间相对有限——这正是CPU核心数量远少于GPU的根本原因。每个CPU核心都是一个"全能选手",但这种全能的代价是无法在芯片上集成太多核心。
GPU:大规模并行计算的利器
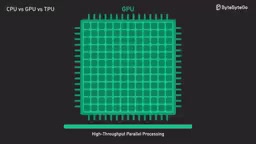
与CPU不同,GPU集成了远超CPU数量的算术单元,使其非常适合高吞吐量的并行计算工作。典型适用场景包括:
- 图形渲染:多个像素可独立计算
- 科学计算:同一数值运算应用于海量数据集
- 视频处理:帧级别的并行操作
- 机器学习:相同数学运算在大批量输入上重复执行
GPU的SIMT执行模型:并行的本质
GPU的并行能力源于其独特的SIMT(Single Instruction, Multiple Threads) 执行模型。与CPU每个核心独立执行不同指令流不同,GPU将数十个线程组织成一个线程束(Warp,NVIDIA术语)或波前(Wavefront,AMD术语),通常为32或64个线程。同一线程束中的所有线程在同一时钟周期执行相同的指令,但操作不同的数据——这就是"单指令多线程"的含义。
以NVIDIA的架构为例,一块现代GPU可能包含数千个CUDA核心,组织在数十个流式多处理器(Streaming Multiprocessor, SM) 中。每个SM可以同时管理数千个线程的上下文,通过快速的线程切换来隐藏内存访问延迟。当一组线程等待数据从显存返回时,SM立即切换到另一组已准备好的线程继续执行,从而保持计算单元始终忙碌。
GPU还拥有极高的显存带宽——现代AI GPU(如NVIDIA H100)的HBM3显存带宽可达3TB/s以上,远超CPU的内存带宽。这种高带宽设计确保了大量并行计算单元能够持续获得数据供给。开发者通过CUDA、OpenCL或更高层的框架(如PyTorch、TensorFlow)来编程利用这些并行资源,将计算任务分解为可并行执行的内核函数(Kernel)。
矩阵乘法:理解GPU优势的关键
要理解GPU为何如此适合AI训练和推理,需要先理解矩阵乘法。矩阵就是一个数字网格,例如2×3矩阵有两行三列。矩阵乘法将两个兼容的数字网格组合成新的网格——逐行逐列地进行乘法和加法运算。
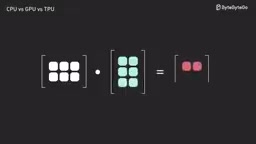
这听起来简单,但当矩阵规模巨大时,就变成了海量的重复数学运算。而这种运算在机器学习中无处不在:神经网络处理输入时,底层大量操作就是矩阵乘法。输入是一大组数字,模型权重是另一大组数字,模型通过矩阵乘法将它们组合产生输出,然后在多个层中重复这个过程。
计算复杂度与并行化潜力
从计算复杂度角度看,两个n×n矩阵相乘需要O(n³)次乘加运算——结果矩阵有n²个元素,每个元素需要n次乘法和n-1次加法。对于大型语言模型中常见的4096×4096矩阵,这意味着约680亿次浮点运算。然而,这些运算具有极高的数据并行性:结果矩阵中的每个元素都可以独立计算,互不依赖。
更关键的是矩阵乘法的计算密度——即计算量与数据访问量的比值。加载两个n×n矩阵需要读取2n²个数据,但可以执行n³次计算。当n足够大时,计算量远超数据传输量,这意味着一旦数据加载到芯片上,计算单元可以长时间保持忙碌而无需频繁访问外部存储。这种高计算密度的特性使矩阵乘法成为GPU和TPU最理想的工作负载类型。
这正是GPU对AI如此重要的核心原因——它们极其擅长将同一操作并行执行数千次。
张量与TPU:专为机器学习而生
什么是张量?
张量听起来令人生畏,但本质上是对我们熟悉概念的推广:
- 单个数字 → 标量(Scalar)
- 一列数字 → 向量(Vector)
- 一个数字网格 → 矩阵(Matrix)
- 更高维度的数字数组 → 张量(Tensor)

在机器学习中,张量无处不在。例如,一张彩色图像可以表示为具有高度、宽度和颜色通道的三维张量;如果将多张图像打包成一个批次处理,就形成了四维张量。
TPU的设计哲学
TPU(Tensor Processing Unit,张量处理单元)与CPU和GPU都不同。CPU是通用的,GPU高度并行但仍然相当灵活,而TPU更加专业化——它专门为机器学习工作负载设计,尤其是张量密集型的计算任务,如大型神经网络的训练和推理。

脉动阵列:TPU的核心引擎
TPU的核心计算单元是脉动阵列(Systolic Array)——一种高度规则的处理单元网格,数据像脉搏一样在阵列中有节奏地流动。在脉动阵列中,每个处理单元执行一次乘加运算后,将结果传递给相邻单元,同时接收来自另一方向的新数据。这种设计使得数据一旦进入阵列,就能被多次复用,极大减少了对外部存储器的访问需求。
Google第一代TPU配备了256×256的脉动阵列,意味着每个时钟周期可以执行65,536次乘加运算。相比之下,GPU虽然也能高效执行矩阵乘法,但其通用性设计意味着需要额外的指令调度、线程管理等开销。TPU通过将这些通用机制去除,将几乎所有芯片面积都用于计算单元,在特定工作负载上实现了更高的能效比。
TPU还采用了bfloat16(Brain Floating Point 16) 数据格式——这是Google专门为深度学习设计的16位浮点格式。与标准的IEEE float16相比,bfloat16保留了与float32相同的8位指数范围(因此动态范围相同),但将尾数精度从23位缩减到7位。实践证明,神经网络训练对数值范围的敏感度远高于精度,因此bfloat16能在几乎不影响模型质量的前提下,将计算吞吐量和内存效率提升一倍。这一格式后来被整个行业广泛采纳,包括Intel、AMD和NVIDIA的新一代硬件。
Google选择ASIC(专用集成电路)路线而非使用通用GPU,本质上是一个经济学决策:当工作负载足够明确且规模足够大时,定制硬件的开发成本可以被巨大的运行效率提升所摊薄。Google每天处理数十亿次搜索和推荐请求,每次都涉及模型推理,即使单次推理节省微秒级的时间和微瓦级的能耗,累积起来也意味着数百万美元的成本节约。
典型应用场景包括:
- 大型语言模型推理:推理过程中涉及的巨大张量运算
- Transformer模型训练:工作负载被巨型张量上的矩阵乘法所主导
这正是TPU能够大放异彩的领域。
专业化的代价:为什么不能用TPU做所有事?
因为专业化本身就是一种权衡。硬件越专业化,灵活性就越低:
| 芯片类型 | 核心优势 | 主要局限 |
|---|---|---|
| CPU | 几乎什么都能做得不错 | 并行计算能力有限 |
| GPU | 多种并行工作负载表现优异 | 对非并行任务效率不高 |
| TPU | 对符合其设计的ML工作负载极其高效 | 灵活性最低,通用性受限 |
选择芯片时,需要根据实际工作负载的特征来做判断,而非简单追求某一类芯片的峰值性能。
实践中的协同架构
在真实的AI系统中,通常会针对工作负载的不同部分使用不同芯片:
- CPU 负责控制流、编排调度和通用逻辑处理
- GPU 负责大规模并行计算,如图形渲染和模型训练
- TPU 在工作负载高度集中于张量运算时发挥最大价值
异构计算的互连与编排
在现代数据中心中,CPU、GPU和TPU之间的高效协同依赖于先进的互连技术。NVIDIA的NVLink提供了GPU之间高达900GB/s的双向带宽(H100),远超传统PCIe 5.0的64GB/s,使多GPU之间能够快速交换中间计算结果。NVSwitch进一步将多块GPU连接成一个统一的计算域,使得大型模型可以跨多块GPU进行张量并行或流水线并行训练。
在软件层面,深度学习框架(如PyTorch和JAX)通过计算图(Computation Graph) 自动分析工作负载的结构,决定哪些操作应该在GPU/TPU上执行,哪些应该留在CPU上。例如,数据预处理(解码图像、文本分词)通常在CPU上完成,而模型的前向传播和反向传播则被调度到加速器上。Kubernetes等容器编排系统则在更高层面管理GPU/TPU资源的分配,确保昂贵的加速器不会闲置。
Google的TPU Pod将数千块TPU通过高速互连网络(ICI,Inter-Chip Interconnect)连接在一起,形成一个超大规模的分布式计算集群。TPU v4 Pod最多可包含4096块TPU芯片,提供超过1 ExaFLOP的峰值算力,专门用于训练最大规模的基础模型。这种架构设计体现了一个核心原则:单芯片的性能固然重要,但芯片之间的通信效率往往才是大规模系统的真正瓶颈。
性能优化的关键在于将工作负载匹配到正确的硬件架构。这不是"哪个芯片更好"的问题,而是"哪个芯片更适合当前任务"的问题。理解CPU、GPU、TPU各自的设计取舍,是构建高效AI系统的基础。
核心要点
相关推荐
AI编程代理持久记忆方案:逆向解析Understand Anything插件
逆向解析Understand Anything插件:它如何为Claude Code、Codex、Cursor等AI编程代理构建本地持久知识库,通过代码地图、业务逻辑连接与增量更新实现项目级记忆,而非依赖更大的上下文窗口。
Cursor、Claude Code、Qwen Code 1.0 三大AI编程Agent横评
对比 Cursor、Claude Code 与 Qwen Code 1.0 三款 AI 编程 Agent 的差异:Qwen Code 开源且无需 Node.js,Claude Code 覆盖终端与 IDE,Cursor 支持多模型并接入 Slack 与 GitHub 评审。从开源、模型绑定和工作流入口三个维度给出选型思路。
AI Agent开发者必知的5个免费GitHub仓库
探索AI Agent开发者必知的5个免费GitHub仓库,涵盖Agent项目模板、代码生成与Claude等大模型集成工具,帮助你快速搭建和优化AI智能体,降低开发门槛。