CPU上训练小型DQN:如何正确扩展Learner侧?

单环境DQN在CPU上遭遇吞吐瓶颈,多Worker并行采集大幅提速,但需正确设计Learner更新机制以避免参数覆盖。
本文以一位Reddit用户训练小型DQN时遭遇性能瓶颈的案例为线索,梳理了CPU环境下强化学习工程化的核心难点。单环境下400步/秒的吞吐量受限于Python GIL和采集端瓶颈,单纯增加线程效果有限;改用多进程Worker并行采集后,10分钟内完成近百万步,效率大幅提升。但随之而来的是更本质的问题:多Worker架构若设计不当,不同进程的梯度更新会互相覆盖Learner参数,导致训练失效。文章推荐采用「Worker只采集、单Learner集中更新、共享Replay Buffer衔接」的Ape-X式架构,从根本上消除覆盖风险。此外还讨论了replay ratio调优的边界效应,以及小型网络在GPU上未必更快的工程现实,最终指出:AI工具能快速给出可行架构,但验证训练正确性仍依赖开发者自身对算法机制的深入理解。
问题背景:单环境训练遭遇性能瓶颈
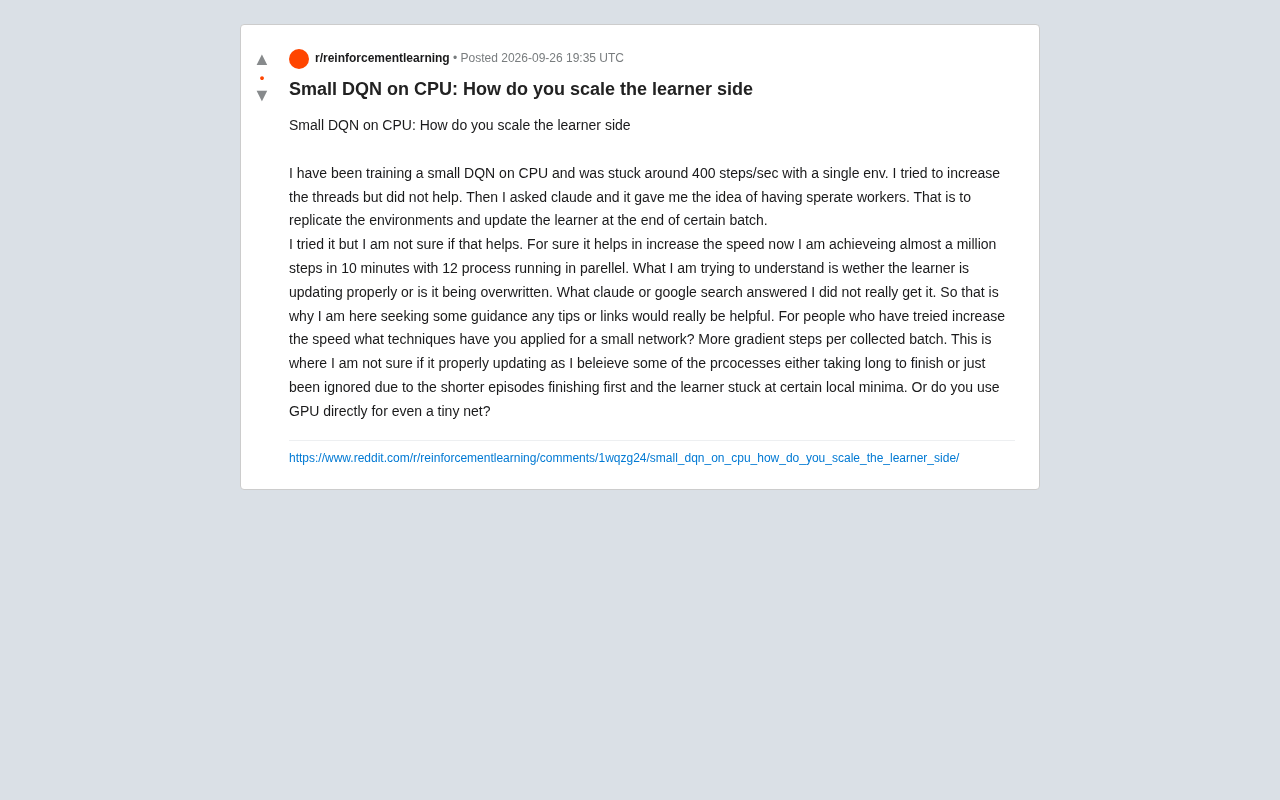
在CPU上训练强化学习模型是许多资源受限开发者的常见选择。一位Reddit用户分享了他的困境:训练一个小型DQN(Deep Q-Network)时,单环境(single env)下的吞吐量卡在约400步/秒(steps/sec),尝试增加线程数却毫无改善。
这个现象其实很典型。对于小型神经网络而言,单纯增加线程往往无法带来线性加速——Python的GIL(全局解释器锁)会限制多线程在CPU密集型任务上的并行能力,而环境交互(env step)本身也可能成为瓶颈。当网络很小时,梯度计算的开销并不高,真正拖慢速度的通常是数据采集(rollout)环节。
多进程Worker方案:速度提升背后的隐忧
该用户在Claude的建议下,采用了「独立Worker」的架构:复制多个环境实例,各自采集经验,在特定批次结束后再统一更新learner。这本质上是分布式强化学习中常见的Actor-Learner解耦思路(类似A3C、IMPALA、Ape-X等架构的核心理念)。
效果立竿见影——12个进程并行后,10分钟内完成了近百万步的采集,相比原来400步/秒有了数量级的提升。
但速度上去了,新的困惑也随之而来:learner到底有没有被正确更新?还是不同进程的更新在互相覆盖? 这正是从单环境走向多Worker架构时最容易踩的坑。
核心疑问:更新是否被覆盖
用户担心的问题很具体:
- 部分进程可能耗时较长才完成,导致更新滞后
- 短episode先结束的进程会「抢先」更新,长episode的经验被忽略
- learner可能因此陷入局部最优(local minima)
这些担忧指向了并行RL中的一个关键设计问题:如何管理经验流与参数更新的同步关系。
Actor-Learner解耦架构的核心思想是将「经验采集」与「参数优化」分离到不同进程,从而让两者异步推进。A3C(Asynchronous Advantage Actor-Critic)是最早将这一思路推广的算法之一,它允许多个Worker各自维护一份网络副本,异步地将梯度推送给全局网络。IMPALA进一步引入了V-trace修正机制,专门处理采集策略与学习策略之间的「行为差异」(off-policy lag)问题——因为Worker在采集数据时用的是旧版参数,而Learner已经更新了若干步,两者之间的策略差距会导致梯度估计出现偏差。Ape-X则走得更彻底,完全放弃同步梯度,转而依赖共享的优先经验回放池(Prioritized Replay Buffer)来解耦采集与学习。理解这些架构演化脉络,有助于判断自己的实现处于哪个复杂度层级,以及对应需要处理哪些一致性问题。
在多进程共享参数的场景下,「参数覆盖」(parameter overwriting)是一个真实存在的危险。若多个Worker进程各自持有Learner的引用并直接调用反向传播,就会发生多个进程同时向同一组参数写入梯度的竞争条件(race condition)。Python的multiprocessing模块中,若使用shared_memory或Manager共享模型权重而没有加锁,不同进程的梯度更新可能互相覆盖,导致参数更新方向混乱。PyTorch的Hogwild!训练模式在某些情况下刻意允许这种无锁异步更新,但它在稀疏梯度场景下(如NLP的Embedding层)才表现良好;对于全连接层密集的DQN,无保护的并发写入几乎必然损害训练稳定性。因此,判断自己的代码是否存在覆盖问题,关键是检查参数张量的写入路径是否做了进程间互斥保护。
并行DQN的正确打开方式
针对这类场景,社区中成熟的做法可以提供参考方向。
区分「采集并行」与「学习并行」
对于DQN这类off-policy算法,最稳妥的架构是让多个Worker只负责采集数据、写入共享的经验回放池(Replay Buffer),而learner保持单一实例,从buffer中采样进行梯度更新。这样就不存在「多进程覆盖learner参数」的问题——只有一个learner在写参数,Worker只读取最新参数用于采集。
Ape-X架构正是这个思路的典范:大量Actor并行采集,单一Learner集中更新,Worker定期从Learner拉取最新网络权重。这种设计天然避免了参数覆盖,也让长短episode的经验都能公平进入回放池。
关于「每批次更多梯度步数」
用户提到的「更多gradient steps per collected batch」是提升样本效率的常见手段,但需要谨慎。对off-policy的DQN来说,提高replay ratio(更新次数与采集步数之比)确实能在数据有限时压榨更多信息,但过高的比例可能导致过拟合近期经验、加剧不稳定性。这与用户观察到的「陷入局部最优」现象可能存在关联。
Replay Ratio(也称Update-to-Data ratio,UTD)是指每采集一步环境数据,Learner执行梯度更新的次数。标准DQN的UTD通常为1或更低,而近年来的研究(如DER、SR-SAC等)尝试将UTD推高到4、10甚至更高以压榨数据效率。然而高UTD会加剧「deadly triad」问题——即函数逼近、自举(bootstrapping)和离轨策略(off-policy)三者共存时的不稳定性。具体表现包括Q值发散、梯度爆炸,或陷入某个次优策略无法逃脱。缓解手段包括引入target网络的更新延迟、使用层归一化(Layer Norm)或周期性重置网络末层(Plasticity Reset),这些都是近期强化学习工程实践中活跃的研究方向。用户观察到的「局部最优」现象,有相当概率是Q网络在高UTD下发生了隐性过拟合或值函数塌陷,而非真正的策略陷阱。
CPU还是GPU
对于「小网络是否值得上GPU」的疑问,答案通常是:如果网络足够小,GPU未必更快。数据在CPU与GPU之间的传输开销,可能会抵消小矩阵运算带来的加速收益。小型DQN的性能瓶颈往往在采集端而非计算端,此时优化重点应放在并行采集和高效的Replay Buffer实现上,而非急于迁移到GPU。
给同类开发者的实践建议
结合这个案例,几点可操作的方向:
- 明确架构分工:Worker只采集、Learner集中更新,用共享Replay Buffer连接两者,从根本上消除参数覆盖疑虑。
- 验证更新有效性:打印监控Q值分布、loss曲线、以及buffer中的经验来源分布,确认所有Worker的数据都被消费,而非某些进程被忽略。
- 谨慎调整replay ratio:从保守的更新频率开始,观察训练稳定性再逐步增加。
- 理性看待GPU:小网络优先优化CPU侧的采集并行,用profiling工具定位真正的瓶颈。
这个提问本身也反映了一个普遍现象:AI助手(如Claude)能给出可行的架构思路并快速见效,但对于「更新是否正确」这类需要深入理解算法机制的问题,仍需要开发者结合监控指标和社区经验来验证。速度提升只是第一步,确保学习过程的正确性才是强化学习工程化的真正难点。
相关推荐

fal.ai API密钥配置与n8n集成完整教程
手把手教你创建 fal.ai API 密钥并连接到 n8n:涵盖官方集成节点配置、凭证保存、HTTP 请求替代方案以及密钥安全注意事项,快速跑通首次 AI 媒体生成工作流。

系统设计面试笔记开源项目:2.4万星的学习利器
开源项目 liquidslr/system-design-notes 整理了经典书籍《System Design Interview》的学习笔记,GitHub 收获 2.4 万 Star。本文解析其内容价值、适用人群及系统设计面试复习建议。
ArtCraft:面向创作者的意图驱动型AI创作引擎
ArtCraft 是一款面向艺术家、设计师和电影制作人的开源「意图驱动型」AI创作引擎,使用 Rust 开发,GitHub Star 数迅速突破 5900。本文解析其产品定位、技术选型与开源策略。