CrowdGPT:去中心化协作训练LLM的野心与挑战
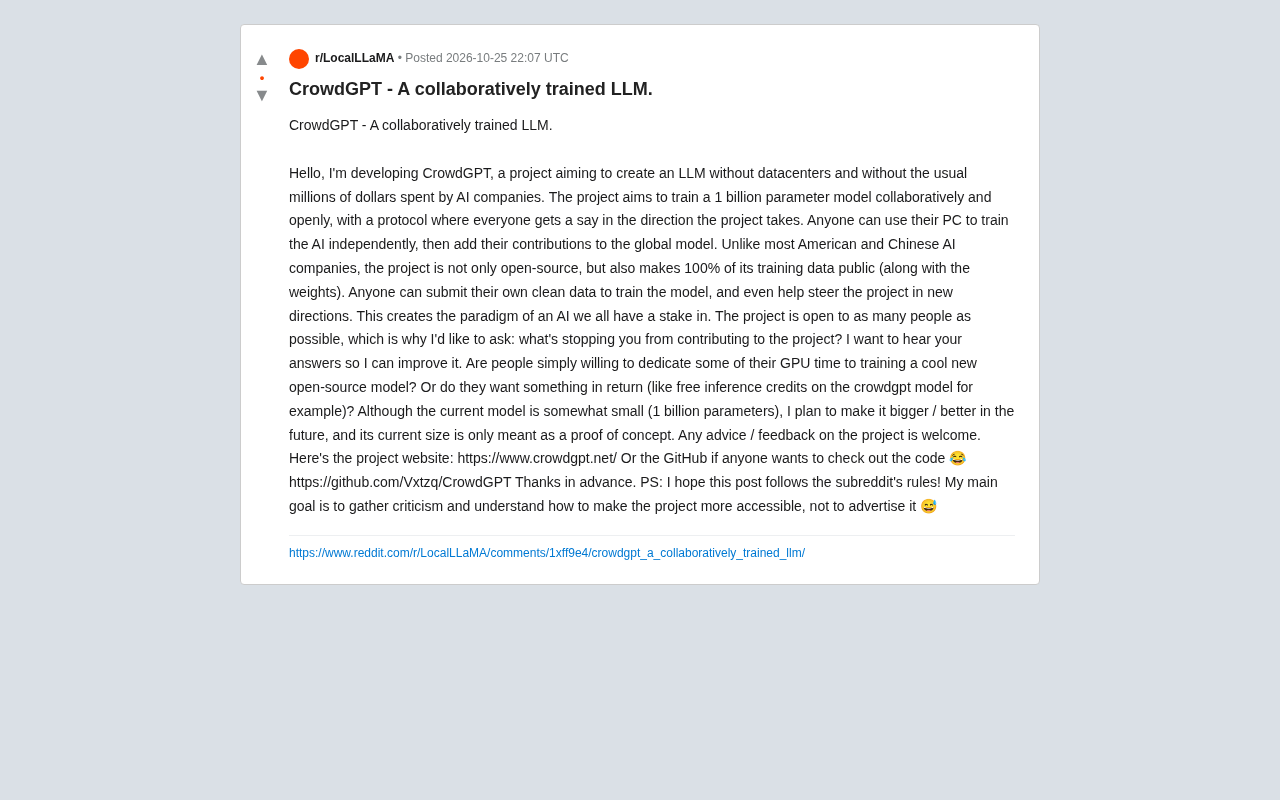
CrowdGPT 试图让全球志愿者用个人PC协作训练10亿参数开源大模型,核心难题是激励机制。
CrowdGPT 是一个由社区发起的实验性项目,目标是绕过数据中心和高额投入,让全球志愿者用各自的PC协作训练一个10亿参数的开源大语言模型,并承诺100%公开训练数据与模型权重。发起人在 Reddit 上征集反馈,直接追问“是什么阻止了你参与贡献”,把项目最大的软肋摆上台面:在缺乏明确回报的情况下,人们是否愿意无偿贡献GPU算力。文章分析了梯度同步、异构硬件、质量控制等技术挑战,以及开源模型生态中 CrowdGPT 强调数据透明与社区治理的差异化定位,并指出其成败将为分布式协作训练提供宝贵经验。
在AI大模型训练成本动辄数千万美元的当下,一个名为 CrowdGPT 的项目试图走一条完全相反的路:不依赖数据中心,不烧钱,而是让全球志愿者用各自的PC协作训练一个10亿参数的开源模型。这个项目的发起人在Reddit上发帖征集反馈,核心问题很直接——是什么阻止了你参与贡献?
项目愿景:人人有份的AI
CrowdGPT 的目标是创建一个"没有数据中心、没有数百万美元投入"的大语言模型。与大多数中美AI公司不同,该项目不仅开源,还承诺100%公开训练数据和模型权重。任何人在自己的电脑上就能独立训练,然后将贡献合并到全局模型中。
这种模式试图构建一种"人人有份"的AI范式——你不仅可以提交自己的干净数据来训练模型,还能参与决定项目的发展方向。发起人强调,当前10亿参数的规模只是概念验证(proof of concept),未来计划做得更大更好。
从技术角度看,协作训练LLM面临的主要难题在于梯度同步和通信开销。参与者的硬件异构、网络带宽不一,如何高效聚合分散的训练成果是关键挑战。项目目前通过GitHub开源代码,网站 crowgpt.net 提供更多信息。
梯度同步是分布式训练中的核心通信环节:每个参与节点基于本地数据计算梯度后,需要与其他节点交换并聚合梯度,才能保证所有副本模型保持一致更新。常见做法是采用 All-Reduce 或参数服务器架构。在数据中心内,节点间通常有高带宽低延迟的专用网络(如 InfiniBand),梯度同步开销可控;而在志愿者网络中,参与者带宽参差、延迟抖动大,且家庭网络往往没有公网 IP,导致同步成为瓶颈。为缓解这一问题,业界常用梯度压缩(量化、稀疏化)、本地多步更新(如 Local SGD)和异步更新等策略,以通信频率换取收敛稳定性。
社区反馈:热情与质疑并存
发起人在Reddit上坦言,发帖的主要目的是收集批评意见,而非推广项目。他提出的问题触及了开源协作的核心矛盾:人们是否愿意无偿贡献GPU时间?还是需要某种回报(比如免费推理额度)?
这个问题的答案并不简单。开源社区历来有志愿者贡献算力的传统(如Folding@home),但LLM训练对显存和算力的要求远高于普通科学计算。一块消费级显卡训练10亿参数模型可能需要数天甚至数周,而贡献的成果最终是公共品——这构成了典型的集体行动困境。
集体行动困境(Collective Action Problem)指个体虽能从公共品中获益,却缺乏为公共品付出成本的激励,最终导致公共品供给不足。在 CrowdGPT 场景中,训练出的模型是任何人都可免费使用的公共品,而贡献 GPU 算力需要承担电费、硬件损耗和时间成本,收益却由所有人共享。破解这一困境的常见思路包括:选择性激励(如按贡献分配推理额度、署名权)、声誉与治理权挂钩、以及将贡献门槛降到极低(如仅需闲时算力)。Folding@home 等分布式计算项目之所以能持续,部分原因在于贡献者多为科研共同体成员或受疾病议题驱动,而 LLM 训练的显存门槛更高,激励设计难度也更大。
Folding@home 是由斯坦福大学发起的分布式计算项目,利用志愿者空闲的 CPU/GPU 模拟蛋白质折叠,用于疾病研究。它与 CrowdGPT 的关键差异在于任务粒度:蛋白质模拟可拆分为大量独立小任务,志愿者各自计算后回传结果即可,几乎不需要节点间实时通信;而 LLM 训练是紧耦合的迭代过程,每步梯度都需全局同步,通信开销和一致性要求远高于前者。因此,CrowdGPT 不能简单照搬 Folding@home 的众包模式,而需在同步策略、容错机制和贡献验证上做专门设计。
开源AI的第三条路?
当前开源模型生态主要由大公司主导:Meta的Llama系列、Mistral的开放权重模型,以及中国的Qwen、DeepSeek广告等。这些模型虽然权重开放,但训练数据和过程往往不透明。CrowdGPT 的差异化在于完全透明的数据管道和社区治理。
这种模式让人联想到Linux和Wikipedia的成功——去中心化的协作可以产出高质量公共品。但AI模型训练的特殊性在于:算力成本高、技术门槛高、质量控制难。没有商业回报的激励,社区能否持续贡献是个未知数。
发起人的探索值得关注,但他提出的问题也暴露了项目的软肋:在激励设计明确之前,大多数潜在贡献者可能仍会观望。对于关注开源AI和分布式训练的开发者来说,这是一个值得跟踪的实验——无论它最终成功还是失败,都会为社区协作训练提供宝贵经验。
相关推荐

安全团队须知:Abliterated模型在Agent中的风险
Abliterated模型通过权重层面移除对齐约束,当这类模型被用于具备工具调用能力的AI Agent时,风险从内容层面升级为操作层面。本文从模型来源审计、行为基线检测、运行时防护和供应链准入四个方向,为安全团队提供应对思路。
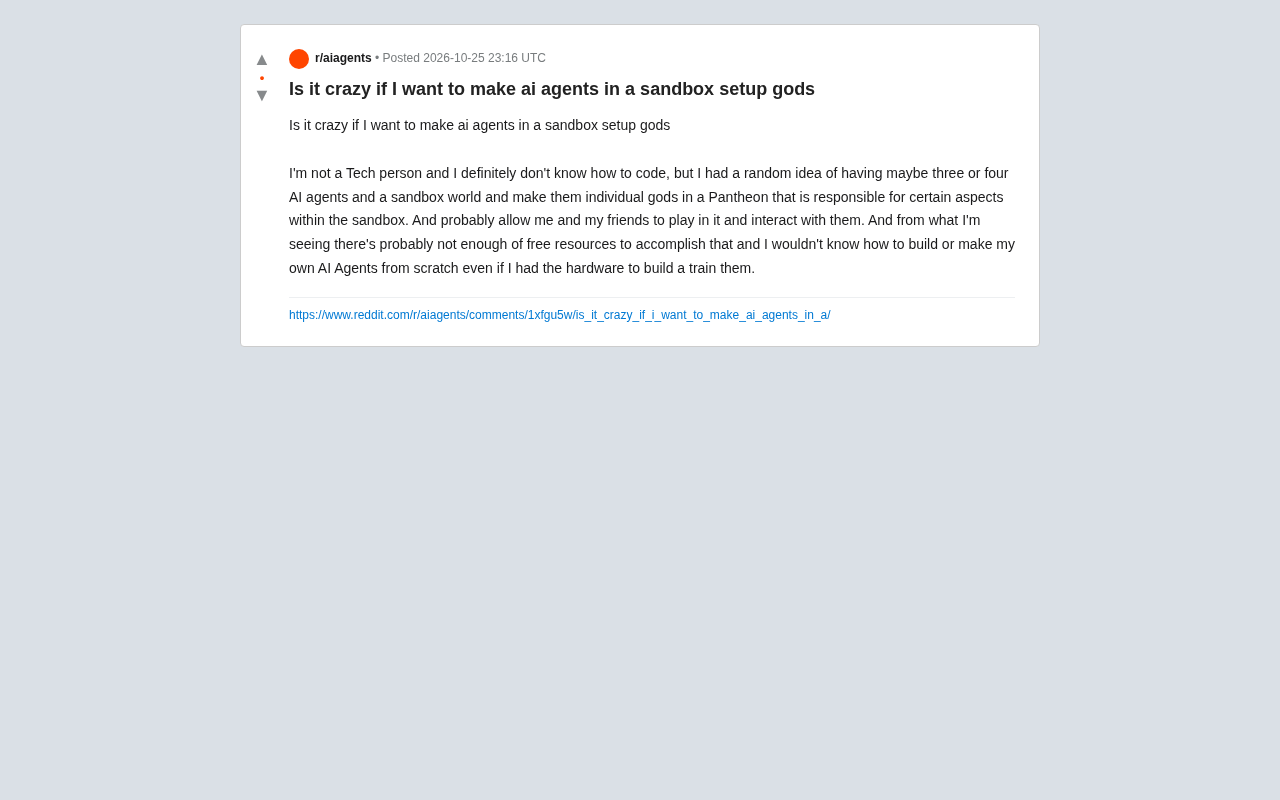
零代码造AI神祇沙盒:Reddit网友的疯狂构想可行吗
Reddit网友想用三四个AI智能体在沙盒世界里当神,让朋友进来互动。这个零代码构想技术上可行吗?本文拆解多智能体模拟的技术门槛、免费资源成本,并给出非技术发起者的务实落地路径。
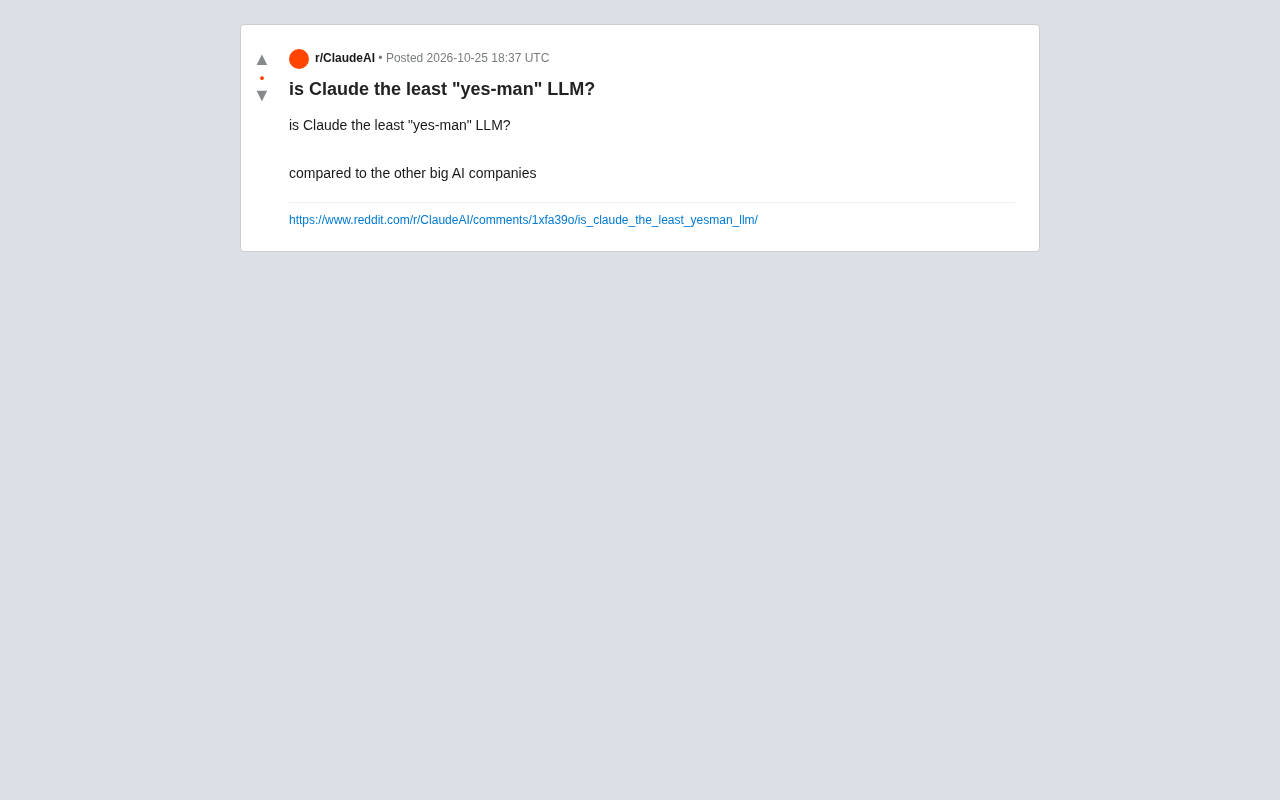
Claude是拒绝当“应声虫”的AI?Reddit热议
Reddit热议Claude是否是最不“应声虫”的大语言模型。本文分析Claude的诚实性设计、与其他模型对比,以及用户对AI讨好行为的真实态度。