错误率不够看:低资源语音识别数据增强的隐藏代价

音素级分析揭示两类ASR数据增强互补机制,组合使用在低资源场景产生超可加性增益
这项研究挑战了ASR领域普遍依赖聚合错误率评估数据增强效果的惯例。通过在四种低资源语言与英语、五种数据规模上的交叉实验,研究者将分析下沉至音素层级,发现SpecAugment与基于文本的增强方法各有特定副作用——前者加剧声调和腭化错误,后者引入辅音插入错误——而两类副作用恰好互补。这种互补并非偶然:声调与腭化依赖单一声学线索且训练暴露度低,文本增强通过拉平词频使这些低频特征出现率提升约37%,从而扭转了SpecAugment造成的退步。两者组合带来超可加性增益,但该效应在训练数据达到100小时后消失,被牢牢限定于真正的低资源场景。研究还指出,训练暴露度和声学属性均可在训练前测量,为增强策略选择提供了可预测的工程依据。
为什么单看错误率会误导研究者
数据增强(data augmentation)早已是低资源自动语音识别(ASR)的标配操作,几乎所有相关研究都会报告它带来的收益。但问题在于,这些收益通常只以聚合错误率(aggregate error rate)的形式呈现——比如整体词错误率下降了几个百分点。这种做法掩盖了一个关键问题:某种增强方法为什么有效、在什么情况下有效?
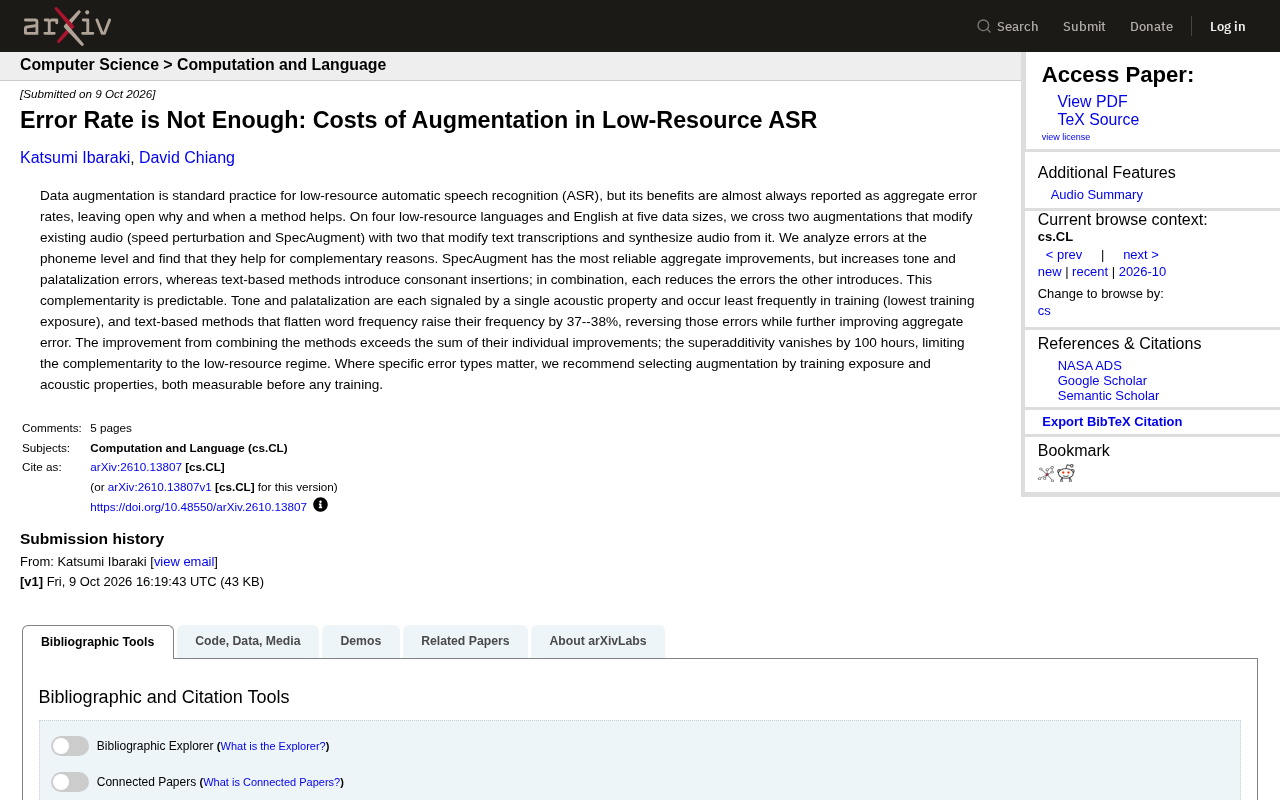
一项新研究正面挑战了这个盲区。研究团队在四种低资源语言外加英语、五种不同数据规模的条件下,系统比较了两类数据增强手段,并把分析下沉到音素(phoneme)层级,揭示出聚合指标背后被掩盖的真实代价与互补机制。
两类增强方法的交叉实验
研究设计的核心是一个二乘二的交叉对比。一类是修改已有音频的方法,包括速度扰动(speed perturbation)和 SpecAugment;另一类是修改文本转录并据此合成音频的方法。把这两类方法在五个数据规模上交叉实验,目的是观察它们各自引入和消除了哪些类型的错误。
关键发现是:这两类方法有效的原因是互补的。SpecAugment 在聚合指标上的改善最为稳定可靠,但它会增加声调(tone)和腭化(palatalization)错误;而基于文本的方法则会引入辅音插入错误(consonant insertions)。换句话说,各自都有自己的"副作用",而这些副作用恰好是对方能够修复的。
速度扰动是最经典的音频增强方式之一,通过将音频以0.9倍或1.1倍等速率重采样,产生更慢或更快的语音,从而人为扩充训练集并提升模型对语速变化的鲁棒性。SpecAugment 则是谷歌2019年提出的频谱增强方法,直接对梅尔频谱图(Mel spectrogram)施加随机遮蔽——既遮蔽连续的时间帧(time masking),也遮蔽连续的频率段(frequency masking)。其核心思想是强迫模型在信息不完整的条件下仍能做出预测,从而模拟真实环境中的噪声和缺失。这两种方法都不改变原始文本标注,因此不会引入新的词汇或语言模式;而基于文本的方法(text-based augmentation)则先对文本进行重采样或改写,再利用文本转语音(TTS)系统合成对应音频,本质上是通过语言侧的操作来间接扩充声学训练数据。正是这一根本差异——"操作音频"还是"操作文本"——决定了两类方法各自的盲区。
互补性背后的可预测规律
这项研究最有价值的洞见,是它证明了这种互补并非偶然,而是可预测的。
声调和腭化这两种语言特征,各自只由单一声学属性来标记,并且在训练数据中出现频率最低——也就是"训练暴露度"(training exposure)最低。正因为模型见得少,SpecAugment 这类只扰动音频的方法反而更容易在这些稀有特征上出错。
而基于文本的方法会拉平词频分布(flatten word frequency),这使得这些低频特征的出现频率提高了 37% 到 38%。频率的提升直接扭转了声调和腭化上的错误,同时还进一步改善了整体错误率。两类方法组合使用时,彼此恰好补上对方制造的漏洞。
声调(tone)和腭化(palatalization)之所以在这一框架中占据核心位置,是因为它们在语音学上都属于"稀疏单一线索"特征。声调通过基频(F0)的高低或升降来区分词义,在普通话、粤语、越南语等声调语言中可决定词语含义;腭化则是辅音发音时舌面向硬腭抬起的附加动作,可改变音素的感知类别。这两种特征的共同点是:它们各自只依赖一条声学维度来传递对比信息,一旦该维度在SpecAugment的频率遮蔽中被部分抹去,模型便难以从其他线索中恢复。相比之下,大多数辅音和元音的区分依赖多条共振峰(formant)线索,即使部分被遮蔽仍有冗余信息可供利用,鲁棒性自然更高。
超可加性与低资源的边界
研究中一个颇具意味的现象是超可加性(superadditivity):组合两种方法带来的改善,超过了它们各自单独改善之和。1 加 1 大于 2。
但这种红利有明确的边界——到了 100 小时训练数据的规模,超可加性就消失了。也就是说,这种互补增益被牢牢限定在真正的低资源场景中。一旦数据量充足,模型本身已经见过足够多的稀有特征,增强方法之间的互补就失去了意义。这一结论对实践者判断"何时值得投入组合增强"具有直接的指导价值。
超可加性(superadditivity)在统计学和组合优化领域指两个变量联合作用的效果严格大于各自独立效果之和,即 f(A+B) > f(A) + f(B)。在机器学习增强策略的研究中,这一现象相对罕见——更常见的结果是两种方法组合后的收益接近各自之和(可加性),甚至因过拟合风险相互抵消(次可加性)。本研究观察到的超可加性,其机制在于两类方法制造的错误类型正好互为补集:SpecAugment 压低了低频特征的识别率,而文本增强拉高了这些特征的训练暴露度,二者组合时不仅消除了各自的副作用,还产生了单独使用时无法达到的协同增益。100小时数据规模成为临界点,意味着当训练集足够大,模型已对低频特征形成足够的自然覆盖,增强方法之间"互补漏洞"的空间便不复存在。
给实践者的可操作建议
如果你关心的是特定类型的错误,而不仅仅是整体错误率,这项研究给出了一个清晰的选择框架:
- 依据训练暴露度选择增强方法——哪些特征在训练数据中出现得少;
- 依据声学属性判断——该特征是否由单一声学线索标记。
最实用的一点是,这两个指标都可以在任何训练开始之前就测量出来。这意味着研究者无需反复试错训练,就能预判某种增强方法可能带来的收益与副作用,从而更有针对性地配置增强策略。
结语
这项工作的真正贡献,不在于提出了某种新的增强技术,而在于它提醒整个 ASR 社区:错误率不够看。当我们只盯着一个聚合数字时,很容易对一个方法"为什么有效"产生错误的直觉。把分析下沉到音素层级,用训练暴露度和声学属性去解释增益来源,才能让数据增强从"碰运气"走向"可预测的工程决策"。对资源匮乏语言的语音技术建设而言,这种可解释性比单纯刷低错误率更有长期价值。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。