Cursor @-Mentions 技巧:让Agent精准锁定文件与文件夹

Cursor的@-Mentions让你手动指定文件、文件夹、终端和分支diff,跳过Agent搜索,精准锁定修改范围。
Cursor的Agent模式默认会自主搜索代码库以定位相关文件,这在探索未知问题时很有用,但当你已经知道bug所在文件时,这种搜索只是在浪费token和延迟,还可能因匹配到旁支代码而产生误判。文章介绍的@-Mentions正是解决这一问题的操作:在聊天框输入@即可直接点名单个文件(如@auth.ts)或整个文件夹(如@src/components),把文件定位权从Agent手中收回。除文件和文件夹外,它还能引用终端输出和分支差异,把代码之外的上下文也结构化地喂给Agent。作者同时给出边界:当你不确定哪些文件重要时,应放手让Agent自主搜索。核心判断标准是能否说出问题大致出在哪个模块。
Cursor @-Mentions 技巧:让Agent精准锁定文件与文件夹
AI编程工具正在把"会用工具"变成新的基本功。同样一款Cursor,有人一句话就能让Agent改对地方,有人来回几轮仍答非所问——差距往往不在模型,而在于你是否懂得给Agent划定"作业范围"。今天聊的 @-Mentions,就是这样一个被大量开发者忽略、却能立竿见影缩短调试路径的操作。
问题:Agent猜文件,其实是在浪费你的时间
Cursor的Agent模式默认会自主搜索代码库,找出它认为相关的文件。这在你不熟悉项目、或者不清楚问题出在哪里时非常有用。但反过来看,当你已经知道bug在哪个文件时,让Agent满仓库乱翻就是纯粹的损耗。
据YouTube创作者在视频中的描述:"当你知道bug在哪里时,让agent去搜索就是在浪费时间。"这句话点出了AI编程助手一个常被忽视的成本——搜索会消耗token、增加延迟,还可能因为匹配到旁支代码而产生误判。
Agent搜索本身不是缺点,问题是它默认把"找文件"和"改代码"两件事打包做了。而人类开发者往往已经完成了第一步,只需要Agent做好第二步。
Agent模式(Agentic Mode) 是Cursor中的一种工作模式,与普通的"对话补全"不同:它被赋予了自主执行多步操作的能力,包括读取文件、跨文件检索、创建/修改代码,甚至运行终端命令。这种模式依赖一个"工具调用循环"——模型先决定搜什么、读哪些文件,再基于结果决定下一步。正因如此,Agent的默认行为是"先探索、后动手",探索过程会反复调用检索工具,每一步都占用上下文窗口和token。
理解这一点很关键:Agent的"猜文件"并不是模型在偷懒,而是它设计上就要完成的自主规划步骤。当你已经掌握定位信息时,这个步骤就变成了冗余开销——不仅多花token,还可能因为检索到相似但无关的代码片段,把注意力引向错误的修改方向。这也是为什么把定位权手动收回,往往能立竿见影地提升准确率。
解法:用 @ 在对话中直接"点名"
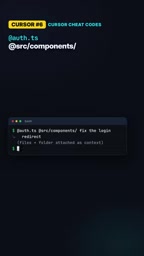
@-Mentions 的核心逻辑非常朴素:在聊天框里输入 @,然后指定你希望Agent关注的目标。它把"文件定位权"从Agent手里拿回来,交还给你。
具体的两种基础用法:
- 指定单个文件:输入
@auth.ts,Agent就只会围绕这个文件展开工作 - 指定整个文件夹:输入
@src/components,把一整个目录作为上下文交给Agent
文件夹级别的引用尤其值得一提。组件库、工具函数目录这类结构清晰的文件夹,往往一个问题会牵涉其中多个文件,逐个点名反而低效。用文件夹引用,等于告诉Agent"范围就在这一片,别往外看"。
从实现角度看,@-Mentions 的本质是上下文注入(context injection):它把被引用对象的内容直接嵌入到发送给模型的提示中,作为高优先级的上下文存在,而非让模型自己去检索。
这一区别带来三个实际收益。其一是确定性——被引用的文件一定在模型视野内,不会因为检索排序不佳而被漏掉。其二是token可控——你清楚知道注入了哪些内容,避免Agent反复搜索造成的不必要消耗。其三是注意力聚焦——当上下文里只有目标文件时,模型更难被旁支代码干扰。需要注意的是,文件夹引用会整体注入目录中文件的内容,引用的目录越大,注入的token也越多,因此在超大目录上仍应谨慎,必要时缩小到子目录或具体文件。
扩展能力:除了文件,还能点名什么?
@-Mentions 的能力不止于文件和文件夹。视频中还提到两类容易被忽略的引用对象:
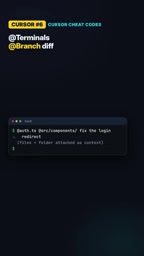
- 终端(terminals):把终端输出纳入上下文,报错信息、构建日志可以直接被Agent读取
- 分支差异(branch difference):引用当前分支与目标分支的diff,适合让Agent理解"这次改动到底改了什么"
这两项的意义在于:它们把"代码之外的上下文"也结构化地喂给了Agent。终端报错是最直接的诊断线索,分支diff则帮助Agent建立变更意图的认知。相比让Agent自己从头探索,主动提供这两类信息能显著降低理解成本。
分支差异(branch diff) 指的是当前工作分支与某个基准分支(如 main)之间的代码变更集合,通常以 diff 格式呈现,包含新增、删除和修改的行及其上下文。对于Agent而言,diff是一份高度浓缩的"变更意图说明书":它不需要通读整个代码库,就能知道你这次动了哪些逻辑、在哪几个文件留下了痕迹。
这在两种场景下特别有价值。一是代码审查或重构:让Agent基于diff评估改动是否完整、是否引入副作用。二是排查"我刚改完就出问题"的情况:把diff交给Agent,它能快速把故障与最近的变更关联起来。相比让Agent自行搜索全仓库,直接提供diff既省时又更贴近真实的问题边界。
边界:什么时候该放弃手动指定
视频里有一句容易被忽略但很关键的补充:如果你不确定哪些文件重要,就别硬指,直接让Agent自己搜。
这是对 @-Mentions 的合理边界界定,而不是矛盾。手动指定适合"已知问题定位"的场景,自主搜索适合"探索未知"的场景。把两者用混,要么是浪费token让Agent瞎找,要么是给了错误的文件范围导致Agent漏掉真正的问题源头。
判断标准其实很简单:你能不能说出问题大致出在哪个文件或模块。能,就用 @ 缩小范围;不能,就放手让Agent搜。
为什么这个技巧值得单独拎出来讲
在AI编程工具的使用中,真正的效率差距常常来自"上下文投喂策略",而不是模型本身。@-Mentions 看似只是一个小语法糖,背后对应的却是一个更普适的原则:当你能明确约束问题时,就主动约束;当问题本身模糊时,才把探索权交出去。
Cursor把它做成"cheat codes"系列的一条,也侧面说明这类操作已经沉淀为经验型知识——不算难,但不知道就是不知道。对于日常在大型代码库里做修bug、改需求的开发者来说,花两分钟熟悉这套引用语法,可能比换一个更强的模型带来的收益更直接。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。