Cursor Pro与SuperGrok谁更划算?Grok 4.5 Token经济学深度对比

一个被反复追问的老问题
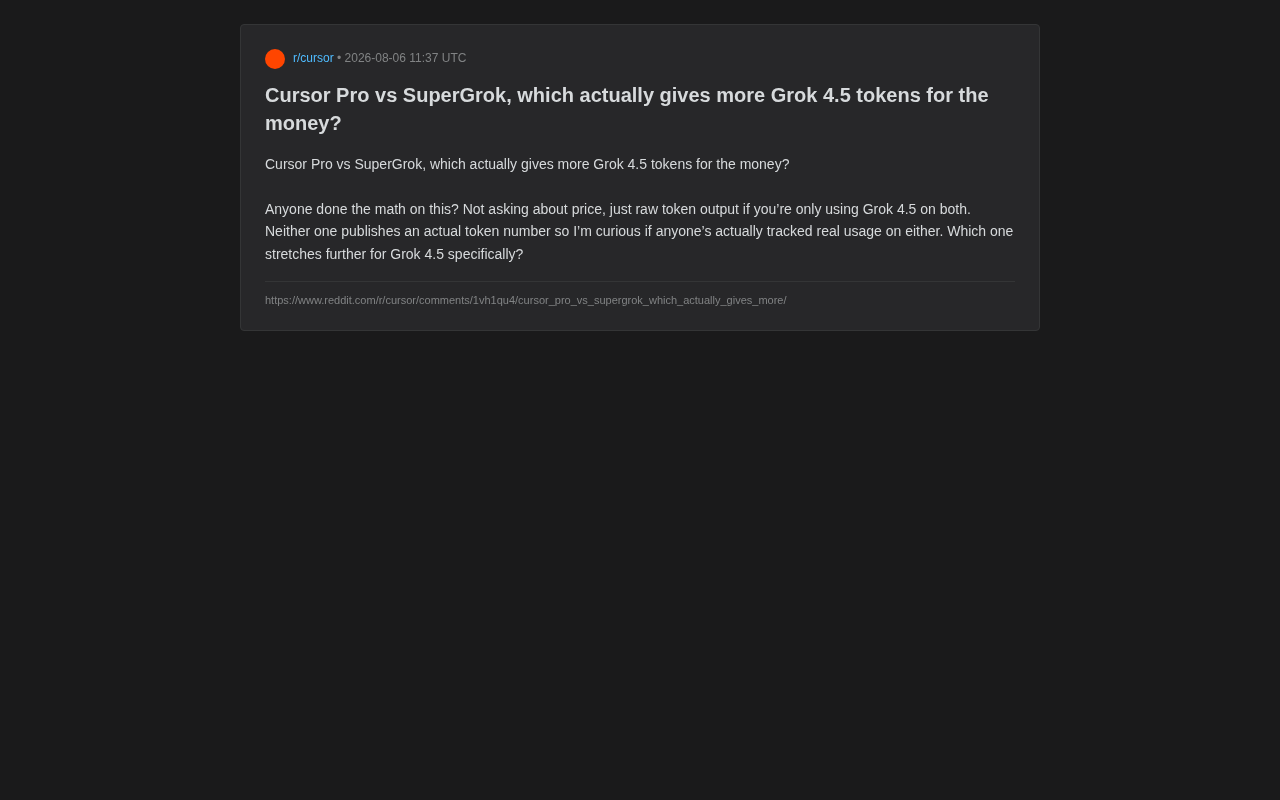
在Reddit的AI开发者社区,一个看似简单却难有定论的问题再次浮出水面:如果你只用Grok 4.5这一个模型,Cursor Pro 和 SuperGrok 这两个订阅方案,究竟哪个能让你花同样的钱换来更多的Token输出?
提问者的态度很务实——他明确表示不关心月费本身的高低,而是想弄清楚"每一美元能买到多少Grok 4.5的原始Token"。这个诉求背后,其实反映了当前AI订阅市场一个普遍的痛点:几乎没有平台愿意公开真实的Token配额数字。
这里需要先理解一个基础概念:Token是大语言模型处理文本的基本计量单位。对于英文文本,一个Token大约对应4个字符或0.75个单词;中文则通常一个汉字消耗1.5-2个Token。但Token的含义远不止于此——现代大语言模型使用BPE(Byte Pair Encoding,字节对编码)等分词算法将文本切分为Token,不同模型的分词器(Tokenizer)实现并不相同,这意味着同一段文本在Grok 4.5和GPT-4o中可能产生不同数量的Token。
BPE算法最初由Philip Gage在1994年提出用于数据压缩,后被OpenAI在GPT-2中引入NLP领域。其核心思想是迭代地合并语料库中最频繁出现的字符对,逐步构建子词词表。例如,"lowest"可能被分为"low"和"est"两个Token。不同模型训练时使用的语料库不同,导致词表差异显著——GPT-4使用cl100k_base词表(约10万个Token),而Grok系列可能采用不同规模的词表。词表越大,常见词被编码为单个Token的概率越高,压缩效率越好,但模型的嵌入层参数也相应增大。这解释了为什么同一段代码在不同模型中的Token计数可能有10-20%的差异。
此外,模型的上下文窗口(Context Window)以Token为单位定义,Grok 4.5支持128K Token的上下文长度,这决定了单次请求能处理的最大信息量。更关键的是,模型的计费通常按输入Token和输出Token分别计价,且输出Token的单价往往是输入的2-4倍。这意味着,当一个平台在每次请求中"塞入"大量上下文时,即便模型输出相同长度的回答,实际的Token消耗也会有数倍差异。
为什么Cursor Pro与SuperGrok的Token对比这么难算
平台刻意模糊的计量方式
Cursor和SuperGrok(xAI旗下的高级订阅)都没有对外公布"你每月能获得多少Grok 4.5 Token"这样的硬性数字。取而代之的,往往是"更快的响应""更高的使用上限""优先访问"这类模糊表述。
这种做法在AI SaaS行业相当普遍。原因有几个:
- 成本结构随底层模型价格浮动,平台不愿把自己锁死在一个具体数字上;
- 用量分布极不均衡,重度用户和轻度用户的实际消耗差异巨大,公布固定配额反而会引发争议;
- 竞争考量,明确的Token数便于横向比价,平台更倾向于用体验模糊化竞争。
从更深层的商业逻辑来看,AI订阅服务的定价策略本质上是一场平台与用户之间的信息博弈。平台面临的核心挑战是GPU推理成本的不确定性——随着用户规模增长、模型版本迭代、以及底层硬件(如NVIDIA H100/H200 GPU)供给变化,单次推理的边际成本持续波动。
以NVIDIA H100 GPU为例,单卡租用成本约为$2-4/小时(云端)。一个参数规模在数百亿级别的模型(如Grok 4.5推测在200B-400B参数区间)需要多卡并行推理,单次请求的实际GPU时间取决于输入序列长度(影响预填充Prefill阶段)和输出Token数(影响逐Token解码阶段)。由于Transformer架构的注意力机制计算复杂度与序列长度呈二次关系,长上下文请求的成本显著高于短请求。这就是为什么输出Token比输入Token更贵——解码阶段需要逐步自回归生成,每生成一个Token都需要完整的前向传播计算。
采用模糊配额而非固定Token额度,让平台保留了动态调整服务质量的空间,本质上是将成本风险从平台转嫁给了用户。
同样的Grok 4.5模型,不同的封装方式
Grok 4.5是xAI(由Elon Musk于2023年7月正式创立的AI公司,核心团队来自DeepMind、Google Brain和OpenAI等顶级机构)推出的旗舰大语言模型,在推理能力、代码生成和长上下文处理方面被认为与GPT-4o、Claude 3.5 Sonnet处于同一梯队。Grok系列模型从最初的Grok-1(开源发布)发展到Grok 3、Grok 4,再到当前定位为旗舰的Grok 4.5,迭代速度极快。xAI的差异化策略包括实时信息接入(通过X平台数据)、更宽松的内容政策、以及在数学推理和代码生成上的重点优化。xAI同时通过SuperGrok消费级订阅(月费约30美元,提供对最新模型的优先访问权)和企业API两种渠道提供模型访问——而正是这种双轨分发模式,催生了本文讨论的价格比较问题。
虽然底层是同一个模型,但Grok 4.5在Cursor和SuperGrok中的"投喂方式"完全不同。Cursor是基于VS Code fork开发的AI原生代码编辑器(由Anysphere公司开发),它的核心差异化在于将大语言模型深度嵌入编程工作流。每次代码补全或对话请求时,Cursor会自动将当前文件内容、相关依赖文件、项目结构索引、光标位置上下文以及精心设计的系统提示词一并发送给模型。
更具体地说,Cursor的技术架构融合了检索增强生成(RAG, Retrieval-Augmented Generation)和传统IDE功能。它会在本地建立代码库的向量索引(Embedding Index),当用户触发补全时,系统先通过语义搜索找到最相关的代码片段,再将这些片段作为上下文注入Prompt。
这套RAG架构涉及多个技术层级。首先是代码库的离线索引阶段:系统使用代码专用的Embedding模型(如CodeBERT或类似架构)将代码文件转化为高维向量,存储在本地的向量数据库(可能使用FAISS或类似引擎)中。当用户触发补全时,系统执行的流程包括:解析当前光标位置的AST(抽象语法树)节点、提取当前函数签名和类型信息、通过语义搜索召回相关代码片段、按相关性排序后截取至上下文窗口限制内。这个过程中,系统提示词(System Prompt)本身可能就占用了500-2000个Token,用于指导模型的输出格式和行为约束。
这种"RAG+IDE"的架构意味着,一次看似简单的Tab补全,背后可能消耗了数千个输入Token用于构建上下文窗口——这是纯对话场景根本不会产生的隐性成本。用户可见的输入可能只有一行代码,但实际发送给模型的Prompt可能包含了当前文件、相关模块、类型定义文件等数千Token的上下文信息。
而SuperGrok更偏向通用对话场景,单次请求的上下文负担相对更轻。因此,即便两者给了你"相同数量"的Token,在Cursor里可能只够几十次代码补全,在SuperGrok里却能支撑上百轮对话。这就是为什么"raw token output"这个指标本身,在跨平台比较时会失真。
如何自己实测Token性价比
既然官方不给数字,社区里更靠谱的做法是自行追踪真实用量。这里提供一套可操作的思路:
用统一负载做对照测试
- 固定输入:准备一组标准化的prompt(比如同样的代码重构任务或问答),确保两边输入的Token量一致;
- 记录消耗:Cursor在设置中可以查看用量统计,SuperGrok也有使用面板,逐次记录直到触及上限;
- 换算单价:用"月费 ÷ 实测总Token数"得到每Token的实际成本,这才是有意义的对比。
需要注意的是,在执行对照测试时,应尽量控制变量:在同一时间段进行测试(避免高峰期和低峰期的服务质量差异)、使用相同的模型版本(平台可能在后台静默升级)、并且多次重复取平均值以消除随机波动。
警惕限流与降级
很多订阅在达到某个阈值后,并非直接断供,而是悄悄切换到更慢的队列或降级模型。
AI平台的限流(Rate Limiting)和降级(Model Downgrade)是行业通行的资源管理策略。限流通常表现为每分钟请求数(RPM, Requests Per Minute)或每日Token总量的硬性上限;降级则更为隐蔽——平台可能在用户达到某个使用阈值后,静默地将请求路由到参数更小的模型(如从Grok 4.5切换到Grok 3),或者降低推理时的采样温度和最大输出长度。用户感知到的症状是"回答变短了""质量下降了",但界面上仍然显示使用的是原模型。
这种做法在技术上难以被普通用户检测——除非你有意设计"探针问题"(即已知正确答案的复杂推理题),通过对比不同时段的回答质量来判断模型是否被替换。一种更系统化的检测方法是记录每次响应的首Token延迟(Time to First Token, TTFT)和每秒输出Token数(Tokens Per Second, TPS)——模型降级通常伴随着这两个指标的显著变化,因为较小的模型推理更快,而限流队列则会增加延迟。这也是订阅制"黑箱"问题的核心所在。
做实测时要特别留意响应速度和输出质量的变化——如果某个时间点后回答明显变得敷衍或响应延迟突增,你以为的"额度"可能已经掺了水分。
更本质的选择逻辑:Token总量之外的考量
别只盯着Token总量
对大多数开发者来说,纠结"谁的Token更多"其实是抓错了重点。真正决定价值的是Token的使用效率:
- 如果你的核心场景是编程与代码库操作,Cursor的深度IDE集成、代码库理解和自动补全能力,会让每个Token产生更高的实际产出——即便它单次消耗更大;
- 如果你需要的是通用推理、写作、日常问答,SuperGrok的直接访问方式往往更经济。
这里有一个经济学概念值得引入:有效Token(Effective Token)。与原始Token不同,有效Token衡量的是"直接为用户意图服务的Token数量"。在Cursor中,虽然一次补全可能消耗5000个输入Token,但这些Token构建的精确上下文使得输出的200个Token几乎不需要人工修改——相比之下,在通用对话中你可能需要多次追问和修正才能得到同等质量的代码,累计消耗反而更高。因此,"每美元的有效产出"才是更科学的比较维度。
订阅之外的第三条路:xAI API按量付费
值得一提的是,如果你的需求高度可预测,直接调用xAI的Grok API并按量付费,可能比任何固定订阅都更透明、更划算。
xAI的API采用按量付费(Pay-as-you-go)模式,通常以每百万Token为计价单位。以行业惯例为参照,顶级模型(如GPT-4o、Claude 3.5 Sonnet)的API价格通常在输入$2-15/百万Token、输出$8-75/百万Token的区间。API计费的最大优势在于完全透明——你可以精确计算每次请求的成本,并通过优化Prompt长度、减少不必要的上下文来主动控制支出。你能精确到每千Token的成本,彻底绕开订阅方案的"黑箱配额"问题。
对于技术用户而言,API路径还有一个隐藏优势:你可以实现智能路由(Intelligent Routing)。即根据任务复杂度动态选择模型——简单的代码格式化用更便宜的小模型(如Grok 3 Mini),复杂的架构设计才调用Grok 4.5。
智能路由的实现通常包含三个核心组件:任务分类器、成本估算器和路由决策引擎。任务分类器可以是一个轻量级模型(如基于规则或小型BERT模型),根据输入特征(长度、复杂度关键词、代码vs自然语言比例)将请求分为不同难度等级。成本估算器根据预估的输入输出Token数和目标模型的单价计算预期花费。路由决策引擎综合质量需求和预算约束做出最终选择。开源框架如LiteLLM和OpenRouter已经提供了基础的多模型路由能力,但真正有效的智能路由还需要基于历史数据的质量反馈循环——即追踪不同模型在各类任务上的实际表现,动态调整路由策略。
这种策略在实践中可以将综合Token成本降低50-70%,但需要额外的工程投入来实现任务分类和路由逻辑。当然,代价是你得自己处理认证、请求管理、错误重试、上下文构建等工程工作,失去了Cursor那样开箱即用的开发体验。对非技术用户而言,这条路的门槛不低。
结语:透明度才是真问题
这个Reddit问题至今没有一个权威答案,恰恰暴露了AI订阅市场的深层矛盾——用户想要可比较的确定性,平台却在贩卖模糊的体验。
这种矛盾并非AI行业独有。早期的云计算市场(AWS、Azure)也经历过类似的定价混乱期,直到行业成熟、竞争充分后才逐步走向透明计费。具体而言,AWS在2006年推出EC2时采用的是简单的按小时计费,但随着实例类型、存储选项和网络带宽的组合爆炸,账单变得极为复杂。直到2018年AWS推出Cost Explorer和Savings Plans,以及第三方成本管理工具(如CloudHealth、Spot.io)兴起,用户才真正实现了云支出的可观测性。AI订阅市场可能正处于类似的早期阶段——随着更多竞品涌入(如Windsurf、Continue等AI代码编辑器,以及ChatGPT Pro、Claude Pro等对话订阅),市场压力最终会迫使平台提供更清晰的用量承诺。
在这种信息不对称下,最理性的策略不是等待官方给出Token数字,而是:基于自己的真实工作负载做小规模实测,用"每美元实际产出"而非"每美元Token数"来决策。对编程重度用户,Cursor Pro的集成价值通常物有所值;对通用用户,SuperGrok或API可能更省钱。答案,最终藏在你自己的用量数据里。
核心要点
核心要点
核心要点
相关推荐

Anthropic 官方揭秘:Opus 5.5 的 12 条提示词新规则
Anthropic 官方发布 Opus 5.5 提示词指南,涵盖 effort 默认档位、缓存保留、agents.md 支持、time matters 提速等 12 条实用技巧,帮你让 Claude 系统更快、成本更低。

用Claude Opus构建工具站:一个月上线130+工具并变现
本文详解如何用Claude Opus在一个月内构建并变现超过130个在线工具的网站,涵盖选题规划、框架搭建、AI代码生成、质量检查、规模化与AdSense联盟变现的完整步骤。

Claude Code Hooks完整教学:Event、Matcher、Handler三层架构详解
Claude Code Hooks完整教学,详解Event、Matcher、Handler三层架构。涵盖SessionStart、PreToolUse、PostToolUse、Stop等核心Event与五种Handler类型,附Git金钥检查、文章AI味检测实战案例及Codex差异说明。