Cursor 如何索引代码库:Merkle 树与增量同步的工程实践
Cursor 借助 Merkle 树增量同步代码库索引,将查询耗时从 7.87 秒降至 525 毫秒。
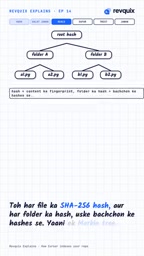
文章解析了 Cursor 如何用 Merkle 树解决 AI 编程助手的全代码库检索效率问题。每个文件计算 SHA-256 哈希,文件夹哈希由子节点聚合逐层向上形成根哈希,使整棵树成为代码库状态的指纹。同步分为四步:自底向上构建哈希树、从根节点向下逐层比对只同步变化分支、客户端提交完整树由服务器以 Content Proofs 剔除无法证明的检索结果、最终返回与客户端代码状态严格对应的索引快照。由于传输与比对成本从「与代码库规模成正比」变为「与改动规模成正比」,中位数仓库首次查询时间从 7.87 秒降至 525 毫秒。该机制与 Git 同源,说明 AI 工具的性能竞争往往取决于底层数据管道的精细程度。
为什么 AI 编程工具需要一套索引机制
AI 编程助手要回答一个看似简单的问题:「这个项目里哪里用到了这个函数?」背后却涉及对全代码库的检索。如果每次编辑都把所有文件重新上传、重新解析,网络带宽和处理开销都难以承受,响应也会慢到无法接受。
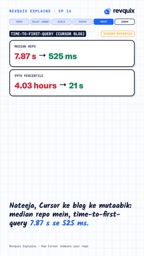
Cursor 的解法借鉴了分布式系统里的经典数据结构——Merkle 树:把每个文件的内容哈希、以及每个文件夹的子哈希聚合起来,形成一棵可以快速比对的树。这样每次只需要找出变化的分支并同步,而不是全量重传。据视频讲解,这套机制让中位数仓库的首次查询时间从 7.87 秒大幅下降到 525 毫秒。
Merkle 树(默克尔树)是一种哈希聚合树结构,由 Ralph Merkle 于 1979 年提出。其核心构造是:叶子节点存放数据块的哈希值,非叶子节点的哈希由其所有子节点哈希拼接后再次哈希得到,递归向上直到唯一的根哈希。这样一来,根哈希就充当了整份数据的「指纹」——数据中任何一位发生变化,都会沿路径传导到根,导致根哈希改变。验证某个数据块是否属于该树时,只需提供从该块到根的兄弟节点哈希序列(即 Merkle Proof),验证成本为 O(log n),无需传输全部数据。这一特性使 Merkle 树广泛应用于分布式系统的一致性校验、区块链的交易完整性证明、Git 的对象存储以及 BitTorrent 的分块校验等场景。
四步同步:从哈希比对到结果过滤
第一步:自底向上构建哈希树
对每个文件计算 SHA-256 哈希;每个文件夹的哈希则由其所有子节点(子文件和子文件夹)的哈希聚合而成,逐层向上直到根节点。任何一处文件内容变化,都会沿着父节点一路传导到根哈希,使整棵树成为代码库状态的「指纹」。
第二步:Root 向下逐层比对
客户端和服务器各自持有自己的树。同步时双方从根节点开始向下逐层比较哈希:一旦发现某个分支的哈希一致,整棵子树直接跳过;只有哈希发生变化的那个分支才继续深入,最终只同步真正改动的内容。
第三步:Content Proofs 证明内容归属
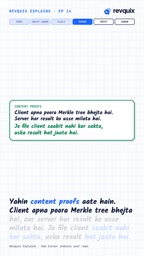
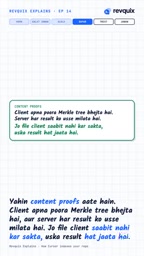
客户端会把自己的完整 Merkle 树发给服务器,服务器把每个检索结果与客户端提交的树进行比对。凡是客户端无法证明(即哈希对不上、文件已变更或不被客户端所持有)的文件,其检索结果会被直接剔除。这相当于一次针对搜索结果的一致性校验,避免返回过期或不属于该客户端的索引内容。
哈希树的比对存在一个关键前提:参与比对的两棵树必须来自可信任的一方。客户端把完整 Merkle 树发给服务器,相当于提交了一份「我当前的代码状态」的声明;服务器返回的检索结果若指向客户端树中不存在的文件哈希,说明该结果基于过期索引或属于其他代码库。这一思路与区块链中的轻客户端验证同构:轻节点不下载全部区块,只持有区块头,通过 Merkle Proof 验证某笔交易是否被包含在区块中。Cursor 在这里把「证明某数据存在」的机制反用为「证明某结果无效」的过滤器,从而在不可靠网络与异步索引之间保证结果与客户端当前代码状态的一致性。
第四步:按快照返回
经过逐层同步与结果过滤,客户端得到的是与自己当前代码状态严格对应的索引快照。后续编辑只需要沿着变化的分支增量更新,无须重复全量处理。
为什么性能提升能到这个量级
耗时集中在两处:上传与比对。全量重传时,网络传输和服务器端解析是主要成本;改用 Merkle 树后,绝大部分分支在根或高层节点就被判定为未变化,需要传输和处理的只剩改动的那一小部分,成本从「与代码库规模成正比」变成「与改动规模成正比」。
这解释了那组数据的量级差异:7.87 秒到 525 毫秒,是接近一个数量级的下降,而非微小的优化。对于代码库规模更大的项目,这种收益通常更明显。
与 Git 同源的工程智慧
有意思的是,这套设计并非 AI 时代的原创。Git 内部同样用内容生成的哈希构建树结构,用它来判断哪些对象发生了变化、哪些可以复用。视频里直言,这正是 Git 使用的「同一个技巧」。
把版本控制领域被验证了多年的机制迁移到 AI 索引场景,是一个务实的工程选择:不需要发明新协议,只需在已有结构上叠加检索结果的证明与过滤逻辑。这也侧面说明,AI 工具的性能竞争,很多时候拼的不是模型本身,而是围绕模型的数据管道做得是否足够精细。
这套机制带来的启示
对开发者而言,Merkle 树的思路有更广的复用价值:任何需要判断「两份数据结构差异在哪」的场景——增量构建、缓存失效、对象同步——都可以考虑用哈希树把比对成本压到最低。对工具开发者而言,Cursor 的案例说明:在模型能力趋同的当下,索引与同步这类偏底层的工程细节,往往才是决定交互流畅度的关键变量。
相关推荐
Cursor Agent白板解析:规则、检查点与安全网
Cursor Agent白板解析:规则、检查点与安全网
基于 Cursor 官方文档与官方课程的白板讲解,梳理 Cursor Agent 的工作循环、三类规则(项目规则/用户规则/AGENTS.md)、检查点与转向两张安全网,以及官方承认的循环陷阱与从小任务开始的实践建议。

沉船考古揭秘:改变美国历史的三大水下战场
国家地理水下考古纪录片揭示:1812年战争切萨皮克舰队残骸、德克萨斯革命前军火走私船和珍珠港亚利桑那号沉没真相。通过磁力探测、声呐测绘和文物分析,考古学家如何用海底证据修正历史叙事。
Simulive一键连接Claude/ChatGPT/Cursor到工作区
Simulive推出新功能,支持一键将Claude、ChatGPT、Cursor等AI工具连接到工作区,无需复制API密钥,提供细粒度权限控制、操作确认、限流和审计日志,让用户用自己的AI处理数据。