Cursor vs Copilot vs Windsurf:2026年AI编程助手谁更强?
三款AI编程助手横向实验揭示:竞争焦点正从写代码转向管理项目上下文。
一项对比GitHub Copilot、Cursor和Windsurf构建同一全栈应用的实验发现,行业领先的Copilot反而产生最多技术债务,到第三页代码时便丢失项目上下文。Cursor在多文件场景中上下文理解更优,但仍需人工干预。Windsurf凭借智能体流程实现实时自我调试,代表了从“建议代码”到“完成工程任务”的范式转变。实验者还提到日志中存在一个未披露的“红旗”,暗示错误与幻觉记录比最终代码质量更能揭示工具的能力边界。文章结论是:AI编程助手的竞争焦点正从写代码转向管理项目上下文和减少技术债务,团队选型应基于真实项目的压力测试而非演示效果。
一个实验引发的思考
在AI编程助手竞争日益激烈的今天,一位YouTube创作者做了一个大胆的实验:用三款主流工具——GitHub Copilot、Cursor和Windsurf——分别构建同一个全栈应用,记录每一次错误、幻觉和代码质量。结论出人意料:行业领先者GitHub Copilot反而产生了最多的技术债务。
这个实验提出了一个关键问题:自动补全时代是否正在被"智能体编程"取代?
Copilot:补全之王,项目上下文之殇
Copilot在代码自动补全方面依然表现出色——单行或短片段建议几乎无可挑剔。但一旦项目跨越多个文件,它的短板就暴露无遗。
实验显示,到第三页代码时,Copilot已经彻底丢失了项目上下文,留下的是断裂的导入关系和混乱的依赖结构。
这意味着什么?对于小型脚本或单文件项目,Copilot仍然是高效助手。但面对需要跨文件协调的全栈应用,开发者需要花费大量时间修复它引入的问题——技术债务随之攀升。
项目上下文(Project Context) 在AI编程助手中指的是模型对当前代码库的全局理解能力,包括:文件之间的导入/导出关系、跨模块的类型定义、函数调用链、配置文件的约束,以及项目所遵循的架构约定。
传统自动补全工具(如早期的Copilot)本质上只接收“当前文件的光标前后文”作为输入,上下文窗口有限,无法同时感知几十个文件之间的依赖拓扑。当项目从单文件扩展到多文件全栈应用时,模型会“忘记”之前定义的接口、变量命名规范和目录结构,从而生成看似合理、实则与现有代码脱节的建议——例如导入一个不存在的模块,或调用已经变更签名的函数。
这种上下文丢失并非Copilot独有,而是所有基于有限窗口的补全式工具的固有瓶颈。解决思路通常包括:检索增强生成(RAG)从代码库中动态拉取相关片段、构建代码知识图谱、或采用能自主规划任务的智能体架构。理解这一点,就能明白为什么“第三页代码”成为实验中的转折点。
Cursor:更好的上下文理解
Cursor在同一个实验中表现得更为稳健。它对项目结构的理解明显优于Copilot,能够在多文件场景中保持较好的连贯性。
但Cursor并非完美。根据实验者的观察,它在某些环节仍需要人工干预来纠正方向,虽然比Copilot强,但还没有达到"自主解决问题"的程度。
对于已经习惯VS Code生态的开发者来说,Cursor的迁移成本较低,是一个务实的选择。
Windsurf:智能体流程的突破
Windsurf在这场对比中展现了最独特的优势:其实时调试能力。实验者特别指出,Windsurf的"智能体流程"(agentic flow)能够在运行过程中实时发现并修复自身的错误。
这与传统补全模式有本质区别。Copilot和Cursor本质上是在"建议代码",而Windsurf在尝试"完成工程任务"——它更像一个能自主迭代的编程助手。
智能体流程(Agentic Flow) 是指AI系统不再仅仅对单步输入作出反应,而是能够自主拆解任务、制定计划、执行动作、观察结果并迭代修正的闭环工作模式。在编程场景中,这意味着助手可以:读取运行时报错、定位相关代码、生成修复补丁、重新运行测试,并根据结果决定是否继续修改,整个过程无需人类逐步指令。
与传统“建议代码”模式的核心区别在于:补全式工具的输出是静态的代码片段,而智能体式工具的输出是经过验证的任务完成状态。智能体通常配备工具调用能力(如终端执行、文件读写、搜索),并维护一个内部状态来追踪目标进度。Windsurf的实时调试能力正是这种架构的体现——它把“写代码”视为一个可自我纠正的工程过程,而非一次性预测。
这一范式转变对AI编程工具的评价标准提出了新要求:除了代码正确率,还需考察其规划合理性、错误恢复能力和对项目上下文的长期记忆。
一个未揭晓的"红旗"
实验者提到,在日志中发现了一个"巨大的红旗",它"改变了一切"。虽然原始内容没有披露具体细节,但这条线索本身值得关注:在评估AI编程助手时,错误日志和幻觉记录可能比最终代码质量更能揭示工具的真实能力边界。
对于开发者而言,这意味着选择工具时不能只看演示效果,还要关注它在压力下的表现——尤其是当项目复杂度上升时,工具是否会引入隐蔽的严重问题。
如何选择:场景决定一切
三款工具的定位逐渐清晰:
- Copilot:适合快速补全和小型任务,但跨文件项目需警惕上下文丢失
- Cursor:在项目上下文理解上更进一步,适合中等复杂度开发
- Windsurf:智能体流程带来实时调试能力,适合需要自主迭代的复杂工程
这个实验的最大启示或许不是"谁赢了",而是:AI编程助手的竞争焦点正在从"写代码"转向"管项目"。谁能更好地维护上下文、处理错误、减少技术债务,谁就能在下一阶段胜出。
对于正在选型的团队,建议用真实项目做小规模测试——毕竟,演示视频里的完美表现,和第三页代码后的真实状态,往往是两回事。
背景补充
AI幻觉(Hallucination) 在编程场景中特指模型生成看似合理但实际错误的内容,例如虚构不存在的API、引用未定义的变量、编造库函数签名,或声称完成了实际未执行的修改。与普通语法错误不同,幻觉往往带有很强的迷惑性,因为代码在语法上可能完全合法,只有在运行时或跨文件检查时才会暴露。
实验者强调“错误日志和幻觉记录比最终代码质量更能揭示工具的真实能力边界”,原因在于:最终代码可能经过人工修复而显得光鲜,但日志忠实记录了工具在无人干预时的原始行为。通过分析幻觉的类型和频率,开发者可以判断工具在复杂场景下的可靠性——例如,它是否倾向于“编造”依赖来绕过上下文缺失,或者是否在遇到错误时反复尝试无效方案。
对团队选型而言,要求供应商提供或自行收集这类压力测试日志,比观看精心剪辑的演示视频更有参考价值。
相关推荐
144.3M本地决策模型 vs 托管API:审批门选型指南
以 Phocinae-Largha-150M 为例,用三个问题判断审批门该选本地决策模型还是托管 API,附真实准确率、延迟数据和置信度升级门设计。
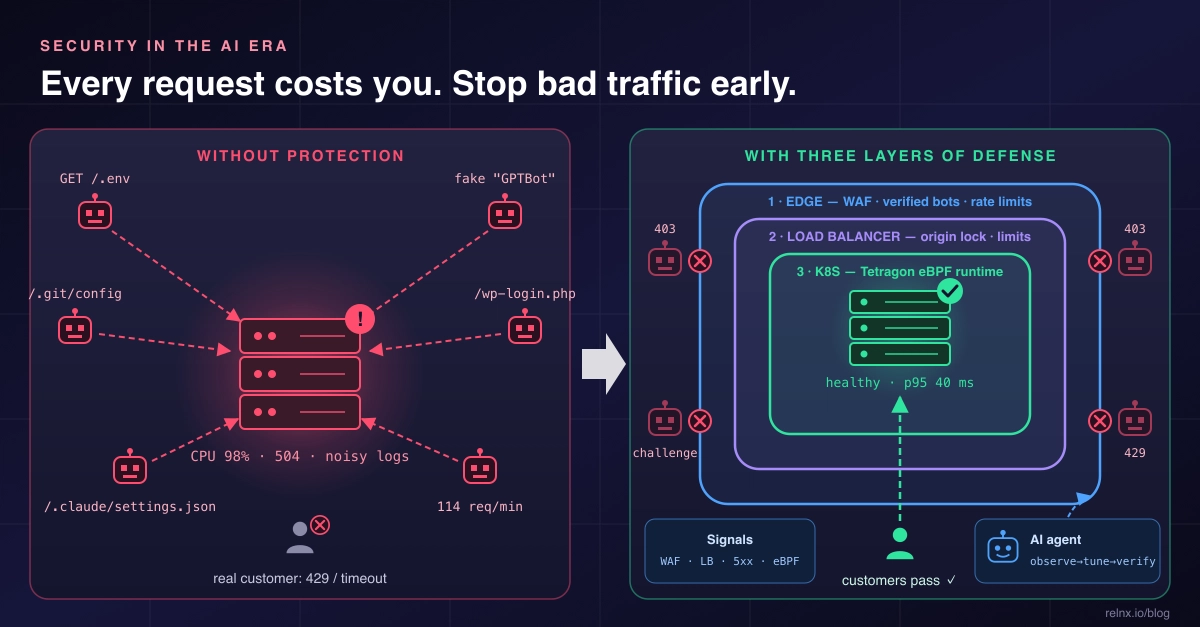
AI时代应用安全:每请求皆有成本,三层防御实战
AI时代应用安全面临新挑战:约八分之一边缘请求为恶意扫描或机器人。本文基于真实流量数据,详解边缘WAF、负载均衡器、Kubernetes Tetragon三层防御及AI代理调优方案。
AI智能体开始自写编排剧本,也不时带着剧本跑偏
最新AI智能体工程周报揭示双重趋势:Claude智能体自写编排程序、LangChain技能渐进披露等自主性提升措施,与OpenAI维基媒体事故、Anthropic签证申请错误、奖励黑客传染等治理事件同步增长。涵盖工具检索、记忆压缩、多智能体故障诊断等前沿研究。