Cursor工程师揭秘:如何让AI智能体从被监工到自动合并PR
Cursor工程师Lauren Tan分享如何通过验证能力、技能沉淀与分层护栏,沿信任曲线走向让AI智能体自动合并代码。
Cursor工程师Lauren Tan在入职五个月后,系统讲述了她如何从「盯紧每行输出」的微观管理状态,逐步建立对AI智能体的信任,最终实现每天自动合并数十个PR。她的核心方法论包括四个层次:一是赋予智能体真正运行代码的验证能力,让其自证功能正确而非依赖人工审查;二是将每一种失败模式沉淀为可复用的markdown技能集(PSTACK),并用类单元测试的EVAL框架持续量化迭代;三是通过代码库架构约束和import静态检查等硬性护栏,使即便能力较弱的智能体也难以写出灾难性代码;四是循序渐进地从本地验证扩展到云端并行智能体。她将工程师角色类比为总厨——设计厨房与流程,而非亲自烹饪每道菜。
Cursor工程师Lauren Tan(推特ID:PotatoPotato)在一场线上分享中,讲述了她从Meta React团队转入Cursor五个月间,如何一步步建立起对AI智能体的信任,最终做到让智能体自动替她合并代码。她的核心观点很直接:管理AI智能体和管理工程团队本质相通,而信任是贯穿始终的那条曲线。
信任曲线:从微观管理到并行放手
Lauren用一张手绘草图描述了自己使用智能体的心路历程。一年前,大多数人用智能体写代码时都处于「高度介入」状态——紧盯一两个智能体的每一条输出,不停写提示词,深陷在工作循环里无法脱身。原因很简单:当你连一个智能体的输出都不信任,就不可能同时派出一百个智能体并行工作。
「这和团队管理非常相似,」她说,「如果我是工程经理却不信任手下的工程师,就会进入微观管理模式,花大量时间盯着每个人做事、检查有没有把bug带进生产环境。」
过去五个月里,Lauren沿着这条信任曲线不断向上攀升。她坦言现在已经让智能体自动替自己合并PR——「今天醒来时已经有大约20个PR自动合并进了main分支,我才回头审查,质量还不错。」她提到自己上个月提交了1000个PR,本月到12号就合并了近800个。面对「这些代码质量过关吗」的质疑,她认为这是完全合理的问题,但坚持认为高质量的自动化是做得到的。
验证能力:打破瓶颈的关键一环
Lauren认为,与智能体协作时工具箱里最重要的能力是验证——让智能体能真正运行代码、获取CPU跟踪、堆快照,或打开iOS模拟器,以用户同样的方式接触应用并验证功能是否正常。「这不能保证智能体写出好代码,但至少能保证功能正确,这会大幅增进你对它的信任。」
她分享了入职第一周的真实窘境:当时要开发智能体窗口(内部代号Glass),面对全新代码库,她看不懂火焰图,智能体也同样不懂。她截图目录、下载跟踪记录发给智能体,智能体却信心十足地断言「问题就在这里」,结果往往全错。「只要缺少验证技能,验证者就会变成你自己,你就是瓶颈。」
为此她构建了Control Glass技能,教智能体使用Chrome DevTools Protocol、Apple模拟器工具等进行程序化控制。但真正独特的是其中一个叫「功能地图」的文件——它主动探索代码,告诉智能体如何进入UI中的各项功能、有哪些键盘快捷键、对应哪些DOM元素。这样即使用户只贴一张截图抱怨「左侧边栏很卡」,智能体也能映射到具体功能,而不是四处乱撞浪费时间。
Chrome DevTools Protocol(CDP)是Google Chrome浏览器暴露的一套底层调试接口,允许外部程序以编程方式控制浏览器行为,包括捕获网络请求、获取DOM快照、执行JavaScript、录制性能轨迹(火焰图/CPU跟踪)等。Puppeteer、Playwright等自动化测试框架底层均依赖CDP。在智能体场景中,赋予智能体CDP访问能力意味着它可以像人工测试员一样「真实看见」页面状态,而不仅仅依赖静态代码分析进行推断——这正是Lauren所说验证能力的技术基础。堆快照(Heap Snapshot)则是Chrome内存分析工具的产物,用于定位JavaScript对象的内存占用与泄漏点,是前端性能调试的常用手段。
PSTACK:把失败模式沉淀成技能
Lauren开发的插件叫PSTACK(P代表Potato,灵感来自YC CEO Gary Tan的GaryStack),本质是一套可Google搜索到的技能集合。她强调这些技能其实就是markdown文档,但其中可以编码大量信息和指令,充分释放智能体能力。
她解释了背后的思维模型:LLM本质是预测下一个token,如果一开始就喂给它一批高质量token,它就能在更高层次进行模式匹配,进入「更聪明的状态」。推特上有人把这称为「把智能体拉到另一个潜在空间」。
PSTACK是她一点点迭代出来的:每观察到一种失败模式——比如智能体不读代码就瞎猜——她就把它做成一项技能,比如「别瞎猜,真正去搜索和阅读代码」。她特别强调不能只做被动观察者:「就像结对编程时你会在旁边想『这里其实可以写得更好』,面对智能体也要牢牢把握方向。」
「把智能体拉到另一个潜在空间」这一说法源于对大语言模型(LLM)工作机制的直觉性描述。LLM在训练时学习的是token序列的概率分布,其推理质量高度依赖输入上下文(prompt)所激活的「知识区域」。当你在prompt开头注入高质量、结构清晰的背景信息时,模型在解码后续token时会在更接近「专家态」的概率分布上采样,等效于将模型的推理起点迁移到参数空间中质量更高的区域。这也是为什么System Prompt工程、Few-shot示例和结构化技能文档能显著改善智能体输出质量的底层原因,而不仅仅是「给了更多信息」那么简单。
用EVAL给技能写「单元测试」
如何维护和信任这些技能?Lauren的答案是EVAL——相当于给智能体写单元测试。PSTACK自带一套方法(在PotatoMode中搜索EVAL Playbook)。
做法是让主协调智能体制定评分标准,生成多个子智能体,并为每个创建巧妙命名的独立目录,这样子智能体「不知道自己正在被评估」——因为一旦察觉行为就会改变。Cursor支持多种模型,可以在整个模型矩阵上评估技能表现。
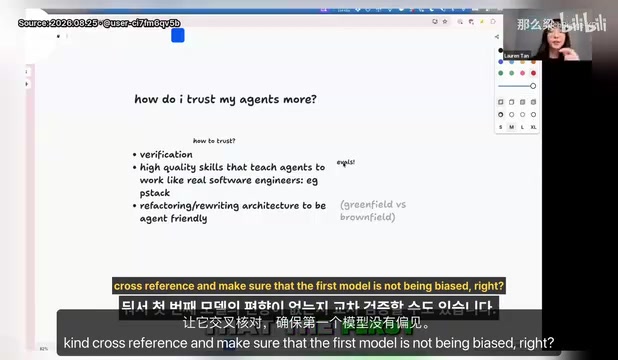
更有趣的是可以用「爬山法」持续优化:EVAL会给出一个分数,再安排一个使用不同模型的评判智能体交叉核对,然后用Loop不断循环运行,直到所有项目都拿到10分。「Control Glass基本就是用这种方法构建的,整个过程很少需要我介入。」
「爬山法」(Hill Climbing)是一种经典的局部搜索优化算法:从当前解出发,每次尝试对解做小幅修改,若新解的评估分数更高则接受,否则保留原解,如此反复直到无法继续提升为止。在机器学习领域,该思路广泛用于超参数调优和提示词优化。Lauren将其应用于技能迭代:EVAL给出量化分数,Loop不断生成变体并评分,只保留得分更高的版本,最终将技能质量逐步逼近满分。这一方法的优势在于无需人工逐条审查每次修改,但也存在陷入局部最优的风险——即某个技能版本在当前评分标准下已「最优」,却未必在真实场景中表现最好,因此评分标准本身的设计质量至关重要。
分层护栏:让最笨的智能体也写好代码
Lauren对「要不要重写应用」这个争议话题给出了务实判断。她以Meta的巨型mono repo为例指出,大型科技公司的基础设施其实都是围绕「照顾团队里能力最弱的人」设计的——建框架、设规范、限制权限避免实习生误删生产库。「在AI垃圾代码出现之前,人类早就会写垃圾代码了。」她认为,一旦这类护栏就位,智能体就不会在代码库里造成灾难。
而对于靠vibe coding快速写出的绿地项目(如昨天刚发布的GrokBot),她警告「有机架构」的风险:没有护栏时,智能体只会选最省事的办法,代码库会逐渐失控。
她为GrokBot(内部代号Dune,可理解为「Electron应用的Next.js」)设计了多层约束:
- 代码库架构(硬约束):功能代码集中在单一目录,核心原则是「最短的路径就是最好的路径」,契合智能体爱走捷径的习惯;
- import规则(硬约束):通过静态分析检查依赖图,禁止跨目录乱引用,比如严格隔离ElectronMain和ElectronRender以避免性能回退;
- 规则、skills、bug bot(软约束):Cursor的Bug Bot在CI上做代码审查。
她甚至直接在CI中禁用了useEffect和代码注释——因为99%的情况下智能体写的注释只是记录无关的历史背景,还会把临时点评当成全局规则遵守。她的建议是:尽量投入到能硬性强制执行的机制上,这也是Rust再度流行的原因——「只要代码能编译,就大概率能正常运行」。
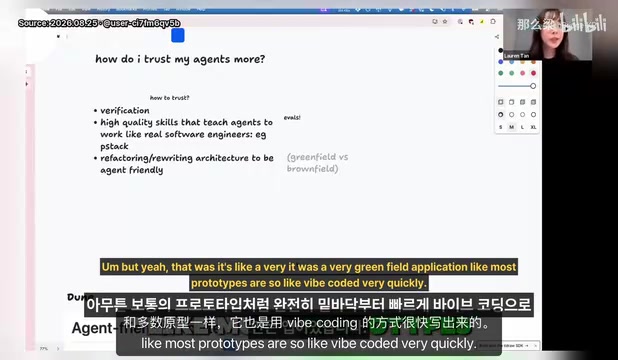
「绿地项目」(Greenfield Project)指从零开始构建、不受任何历史遗留代码约束的新项目,与之对应的「棕地项目」(Brownfield Project)则是在已有系统上迭代。绿地项目在AI辅助开发中尤为值得关注:由于缺乏既有架构约束,智能体会完全按照「最小阻力路径」组织代码,短期内开发速度极快,但随着功能叠加,代码结构会因缺乏统一规范而快速退化——这正是Lauren所说「有机架构」风险的来源。Dune(GrokBot的内部代号)被类比为「Electron应用的Next.js」,意指它试图为Electron桌面应用提供类似Next.js对React Web应用那样的约定优于配置(Convention over Configuration)框架,从而在绿地阶段就预先锁定架构边界。
从本地到云端:Benny这样的自动化智能体
Lauren建议搭建验证系统从本地开始,这样能清楚观察智能体如何与应用交互、调用哪些API。但她个人已全面转向云端智能体。她举例一个叫Benny的智能体:它会接手所有bug报告,自动在云端启动桌面环境,用控制技能复现问题。「比如Benny成功复现了某个bug,又确认它在main分支已修复,我只需再发布一个构建版本——这条信息价值很大,省回大量时间。」
她反复强调这是循序渐进的过程:「你首先得信任它,才能走到这一步。不要一上来就生成成百上千个云端智能体,那只会浪费大量Token,极其昂贵。」
Token成本与投资回报
关于普通Token配额用户是否现实的问题,Lauren坦言「没有什么是免费的,Token确实不便宜」。重构代码库、补齐护栏机制都会消耗大量Token——她为将GrokBot重构到新架构提交了600多个PR。
但她把这视为投资回报率问题:与其雇一个薪资不低的工程师花几年搭框架,不如投入Token把代码库建设好,让最基础的智能体也能胜任。回报不止于她个人——产品经理和设计师现在能直接提交代码请她审查,「代码完全没问题,我直接批准」,这证明架构约束经受住了考验。
她还提到当天刚发布的Grok 4.6,称其价格与4.5相同但更聪明,「相当于以同样成本获得更强智能」,而Cursor和xAI真正在优化的是「成本与智能水平之间的前沿边界」。
主厨而非厨师
Lauren用一个贴切的比喻收尾:工程师现在更像餐厅里的总厨,不再亲自做每道菜,而是设计整个厨房、搭建工作环境、给不同岗位分配任务。她认为团队应保持精简灵活,用智能体去完成过去做不到的事。
对想复现她路径的人,她给出清晰的三步:先在本地建立验证能力,确认代码功能正确;再扩展到云端运行更多智能体自行捕捉信号;最后让PR自动合并。「从这一端走到另一端没有捷径,它取决于你个人对智能体的信任程度。」
相关推荐
语音识别远未解决:Mistral音频研究负责人深度解析
Mistral AI音频研究负责人Pavan Kumar Reddy深度解析语音识别为何远未解决:从Voxtral模型架构、连续隐变量生成、流式与批量权衡、说话人分离难题到DPO修复幻觉,以及语音技术在真实企业场景的落地短板。
AI权重可被复制,为何反而扼杀了创造力?
AI模型权重可被随意复制,这种开放权重的无约束特性反而削弱了创造力。本文解析复制为何是反模式、约束如何催生新颖,以及"约束工程师"这一正在浮现的新角色。
NVIDIA Cosmos解析:物理AI如何打通语言、视频与动作
NVIDIA研究负责人Ming-Yu Liu深度解析Cosmos物理AI世界模型:如何用单一架构打通语言、视频、音频与动作,涵盖自回归塔与扩散塔协作、多模态时间对齐、策略验证仿真及Super/Nano/Edge三种开源模型。