CVSS-X:覆盖28种语言的大规模语音翻译语料库
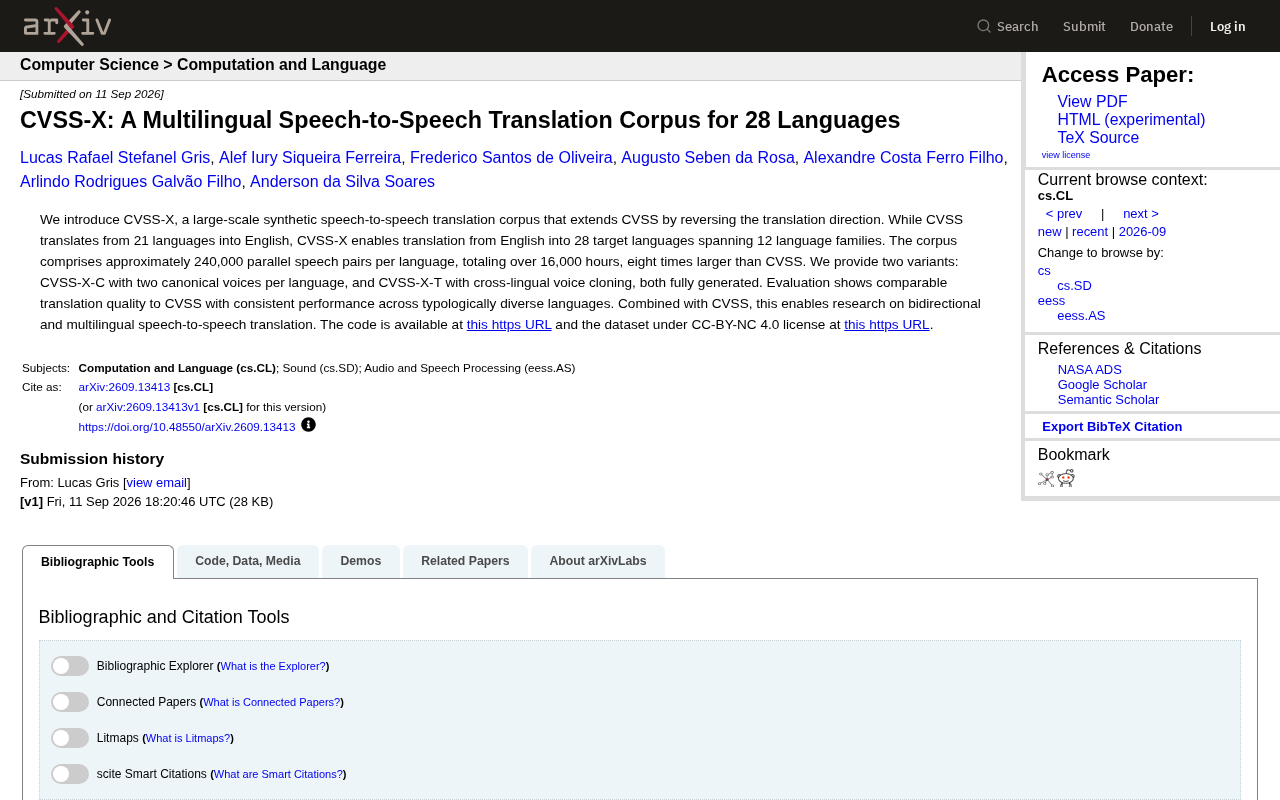
CVSS-X将经典语音翻译数据集扩展至英译28语言、超16000小时,并提供标准与声音克隆两种变体。
CVSS-X 是对经典 CVSS 语料库的重要扩展,将语音翻译方向从"多语言译英语"反转为"英语译28种目标语言",覆盖12个语系。数据集每种语言包含约24万对平行语音样本,总时长超16000小时,是原始 CVSS 的八倍。它提供两个变体:标准语音版(CVSS-X-C)用于基准评估,跨语言声音克隆版(CVSS-X-T)则支持"保留说话人身份"的翻译研究。评估显示其翻译质量与原始 CVSS 相当,且在类型学差异显著的语言间表现稳定。数据集以 CC-BY-NC 4.0 许可在 Hugging Face 开放获取,为学术界构建双向、多语言语音翻译系统提供了重要的基础设施。
语音到语音翻译(Speech-to-Speech Translation, S2ST)一直受限于高质量多语言数据的匮乏。研究团队推出的 CVSS-X 语料库,正是为了填补这一空白。作为经典 CVSS 数据集的扩展版本,它通过反转翻译方向,把研究焦点从"多语言翻译成英语"转向"英语翻译成多语言",为双向和多语言语音翻译研究提供了坚实的数据基础。
从 CVSS 到 CVSS-X:翻转翻译方向
原始的 CVSS 语料库支持从 21 种语言翻译到英语,这一设计天然偏向"以英语为目标"的场景。而现实中的翻译需求往往是双向的——用户不仅需要把外语转成英语,也需要把英语内容分发到全球各种语言。
CVSS-X 正是补上了这块拼图。它实现了从英语出发,翻译到 28 种目标语言的能力,这些语言横跨 12 个语系(language families),覆盖了类型学上高度多样的语言体系。当 CVSS-X 与原始 CVSS 结合使用时,研究者便能构建真正意义上的双向、多语言语音翻译系统,而不再局限于单一方向的实验。
规模:16000 小时的合成语音
数据规模是 CVSS-X 最直观的亮点。每种语言约有 24 万对平行语音样本(parallel speech pairs),总时长超过 16000 小时,是原始 CVSS 的八倍。
这一体量对于训练现代端到端语音翻译模型至关重要。语音翻译模型往往需要海量对齐数据才能学习到跨语言的声学与语义映射,而以往的公开数据集在语言覆盖和时长上都难以满足需求。CVSS-X 通过大规模合成的方式,一次性提供了跨越众多语系的均衡数据,让低资源语言的研究也能获得相对充足的训练素材。
两种变体:标准语音与跨语言声音克隆
CVSS-X 提供了两个版本以适应不同研究场景:
CVSS-X-C:标准语音版本
该变体为每种语言提供两种规范化(canonical)的语音,声音风格统一稳定,适合作为翻译质量评估的基准,减少声学变量对模型训练的干扰。
CVSS-X-T:跨语言声音克隆版本
这一变体引入了跨语言声音克隆(cross-lingual voice cloning)技术,使得同一说话人的音色可以在不同语言间保持一致。这对于研究"保留说话人身份的语音翻译"具有重要价值——理想的语音翻译系统不仅要翻译内容,还应保留原始说话者的声音特征。
值得一提的是,两个版本均为完全合成生成,这既降低了数据采集成本,也规避了真人语音带来的隐私与版权问题。
翻译质量与语言覆盖
评估结果显示,CVSS-X 的翻译质量与原始 CVSS 相当,并且在类型学差异显著的语言之间表现出一致的性能。这一点尤为关键——多语言数据集常见的问题是资源丰富语言(如西欧语言)表现优异,而低资源或结构差异大的语言质量骤降。CVSS-X 在跨语系场景下保持稳定,说明其合成流程具备较好的泛化能力。
覆盖 12 个语系、28 种目标语言的广度,使这一语料库能够支撑对语言普遍性与特殊性的对比研究,也为面向全球用户的语音产品提供了更均衡的训练资源。
开放获取与许可
研究团队采取了开放的态度。相关代码已在 GitHub 上公开(github.com/ErmisAI/XVSS-X),数据集则托管于 Hugging Face(huggingface.co/datasets/lgris/XVSS-X),采用 CC-BY-NC 4.0 许可证。
需要注意的是,CC-BY-NC 意味着允许非商业用途的自由使用与分发,但商业化应用需另行考量。对于学术研究者而言,这一许可提供了充分的使用空间;而希望将其用于商业产品的团队,则需关注许可条款的限制。
意义与展望
CVSS-X 的推出,不只是一次数据集扩容,更代表了语音翻译研究向真正多语言、双向能力迈进的一步。通过合成手段解决数据稀缺问题,并在保证质量的前提下大幅扩展语言覆盖,它为构建普惠的跨语言语音交流工具提供了基础设施。
随着语音大模型的持续演进,像 CVSS-X 这样的大规模、多语系、开放许可的语料库,很可能成为下一代语音翻译系统训练与评估的重要标尺。
相关推荐
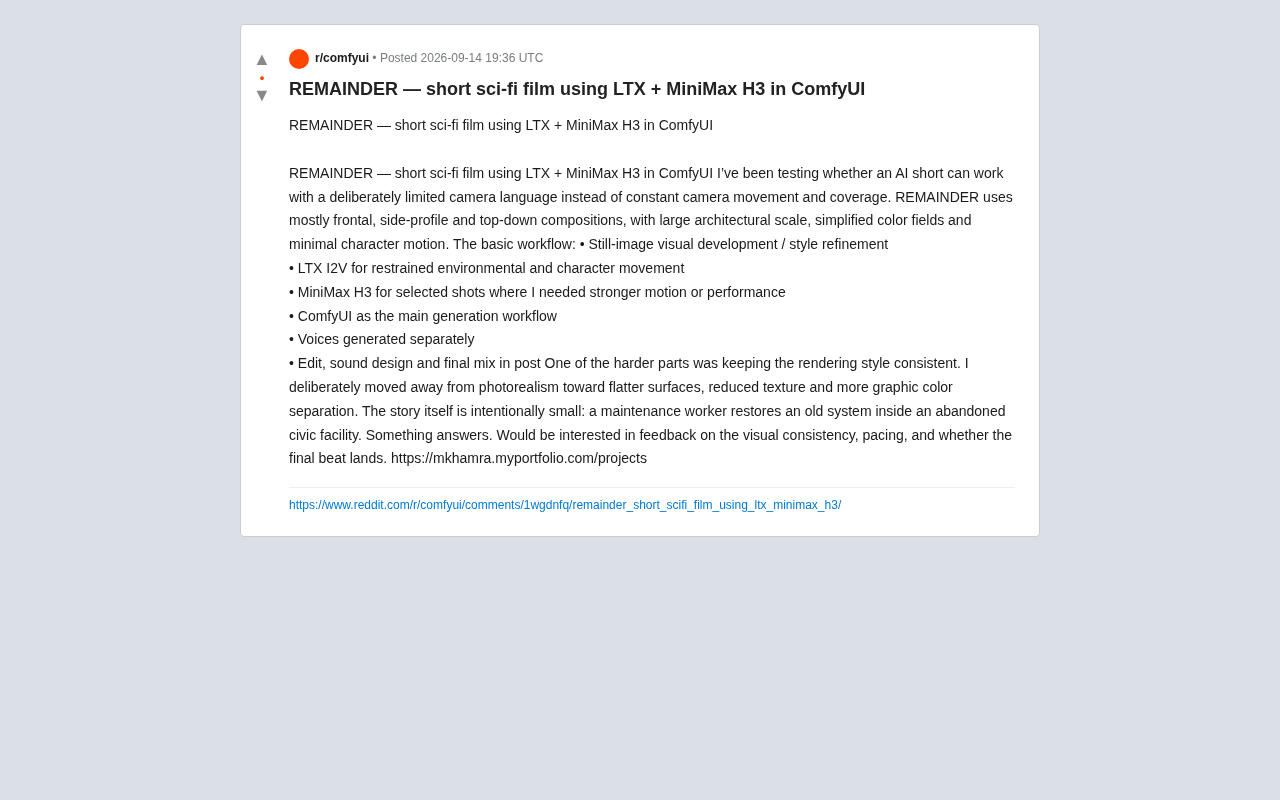
用LTX+MiniMax H3打造AI科幻短片:ComfyUI克制镜头语言实战
AI科幻短片《REMAINDER》用LTX、MiniMax H3与ComfyUI打造克制的镜头语言,通过扁平化美学解决视觉一致性难题。拆解其多模型协作工作流与创作方法论。
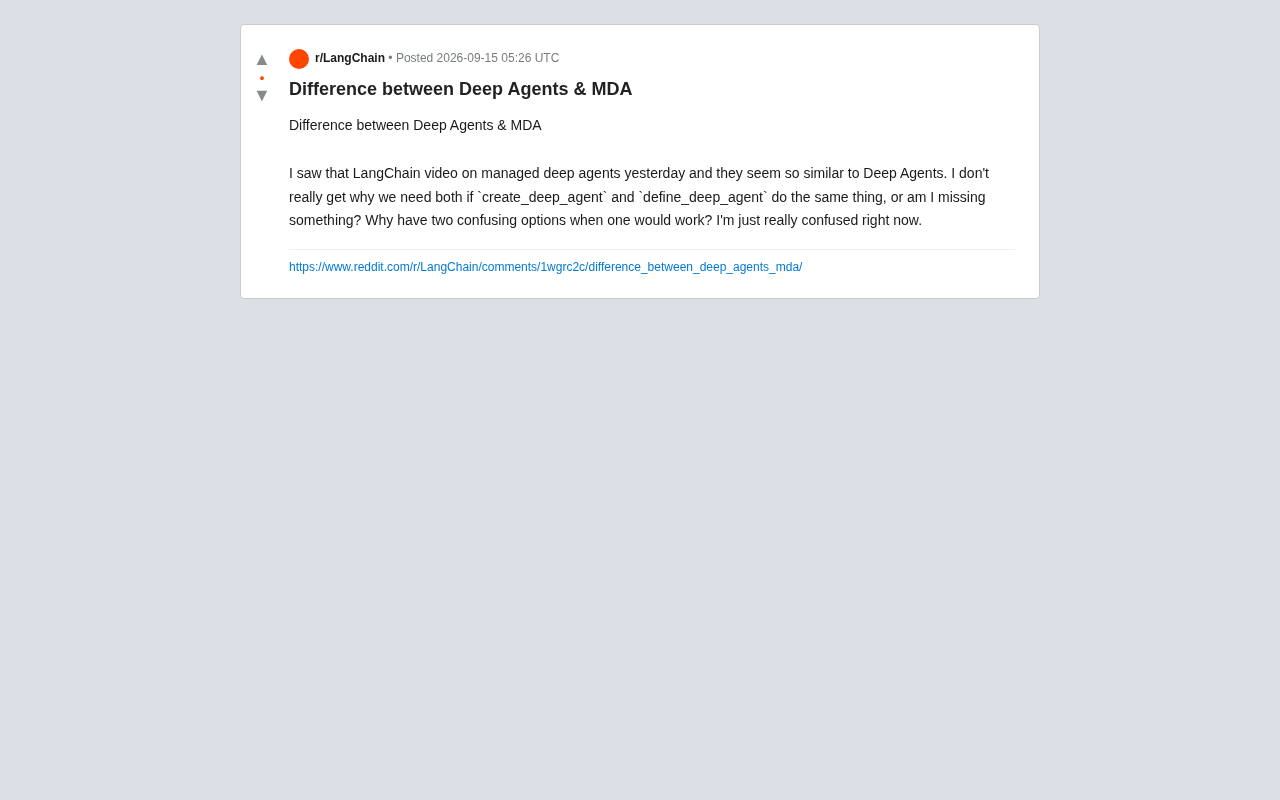
LangChain Deep Agents 与 MDA 有何区别?开发者困惑解析
LangChain 的 Deep Agents 与 MDA(托管深度智能体)到底有何区别?本文从 create_deep_agent 与 define_deep_agent 的差异出发,解析自托管与托管两种智能体部署模式的取舍,帮助开发者理清选择思路。
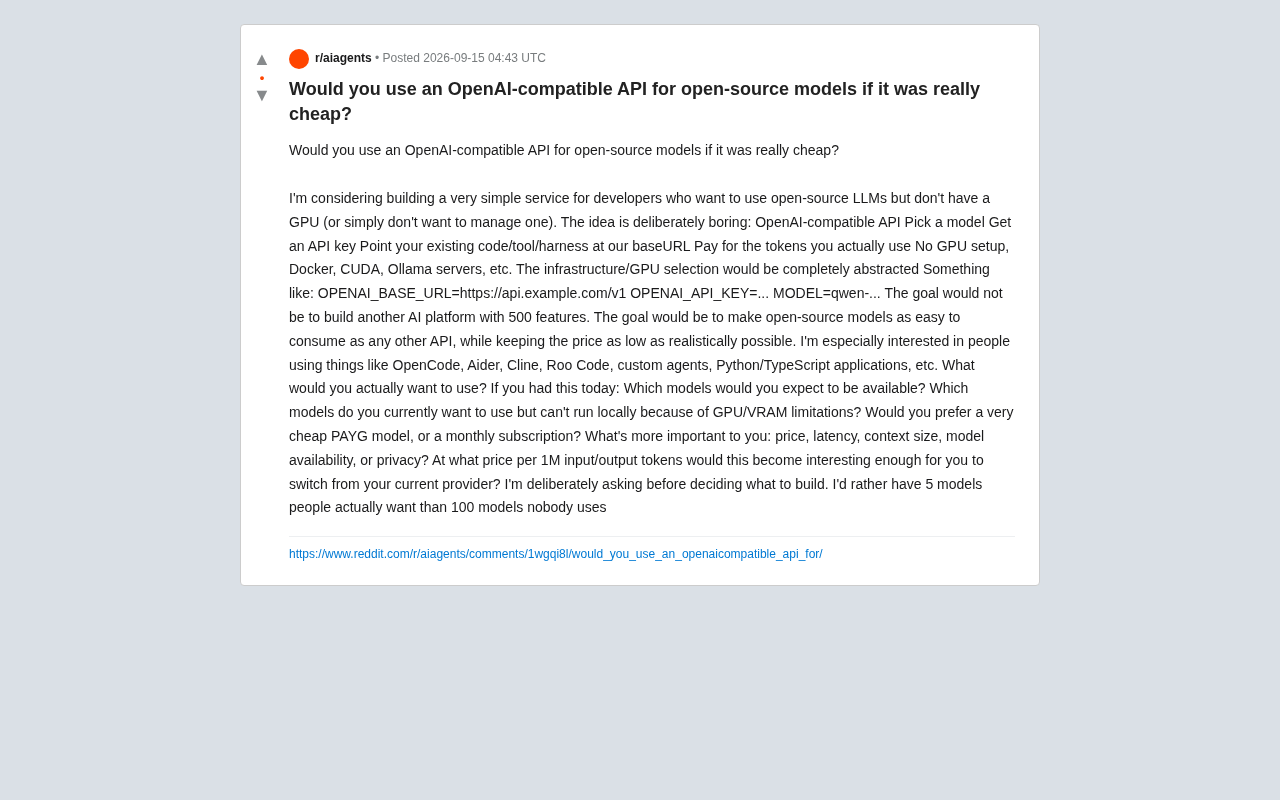
廉价的OpenAI兼容API:开源大模型云端调用的机会与痛点
一位开发者在Reddit探讨:是否需要一个廉价、兼容OpenAI接口的开源模型API服务,让开发者无需GPU即可调用Qwen、Llama等模型。本文分析该设想的痛点、计费模式取舍与市场挑战。