大厂面试题:几百个AI Agent协同如何防冲突?

多Agent并发协同的核心解法是任务分片仲裁加状态版本控制,大规模场景再演进到CRDT去中心化。
文章针对“几百个Agent同时执行同一任务如何避免冲突”这一面试题,指出分布式锁会让并发退化为串行,消息队列则因旧上下文覆盖导致状态错乱。正确解法是传输原子操作与意图描述,由调度中心做分片冲突检测和意图仲裁,再通过版本偏移转换修正操作序号,并用向量时钟、幂等ID和历史补齐应对乱序重试。中心化方案在百级Agent以上易遇算力瓶颈,大规模场景可转向CRDT加去中心化最终一致性,在规划阶段提前消解冲突。高分回答应呈现“问题本质—中心化解法—去中心化演进”的层次。
多智能体协同是当前AI应用落地的热门方向,但几百个Agent同时在线执行同一任务时,底层如何避免冲突、保证一致性,却是一道让多数人当场卡壳的面试题。本文基于B站技术面试解析视频,拆解“任务分片仲裁+状态版本控制”这一核心答案,并对比中心化与去中心化方案的取舍。
为什么加锁和消息队列都救不了场?
面对并发冲突,直觉反应往往是加分布式锁。但在这个场景里,锁的粒度直接决定了协同是否还有意义:一个Agent锁住任务节点,其余99个Agent只能排队等待,本质上是把并行协同退化成了串行执行,并发效率归零。
换用消息队列串行消费同样行不通。当Agent A刚更新了任务上下文,Agent B仍基于旧上下文生成结果,网络稍有延迟,两者就会互相覆盖,任务状态来回跳变,执行结果直接错乱——素材中形容为“数据精神分裂”。问题的根源在于,多数人把协同理解成“把完整任务结果排好队”,而真正的难点在于对原子操作和意图描述做并发控制。
核心方案:任务分片仲裁与状态版本控制
正确的回答是在白板上画出两个关键词:任务分片仲裁、状态版本控制。底层传输的不是完整任务结果,而是原子操作加意图描述。
第一步:拆分任务分片
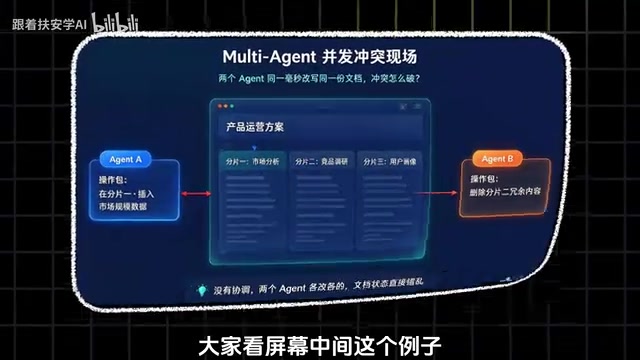
以生成一份产品运营方案为例,任务可拆分为市场分析、竞品调研、用户画像三个分片。Agent A负责在市场分析段落插入数据,操作包为“Insert 段落二 市场规模数据”;Agent B在同一毫秒要删除竞品段落的冗余内容,操作包为“Delete 段落二 第二行”。
第二步:调度中心两层校验
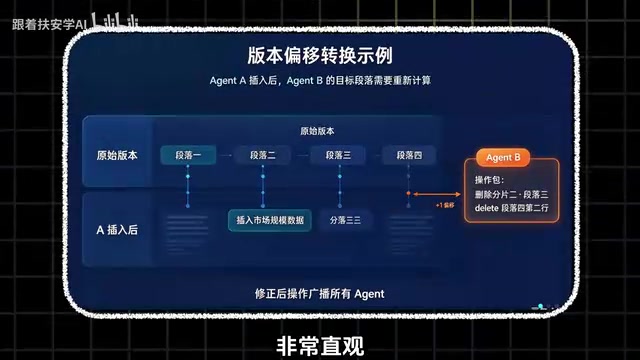
引入全局Agent调度中心,所有Agent的操作必须先发给服务端。服务端拿到A和B两个并发操作后,先做分片冲突检测,判断两个操作是否作用在同一个任务分片、同一段上下文;再做意图冲突仲裁,若目标不冲突,则执行版本偏移转换。
调度中心发现A在前面插入了段落,导致后续段落序号整体后移一位,于是B的删除操作不能仍在第三段落执行,需加一转换为在第四段落执行。修正后的操作再广播给所有Agent,同时更新全局版本号,最终所有Agent屏幕上的任务文档上下文状态完全一致。
第三步:应对网络紊乱与乱序
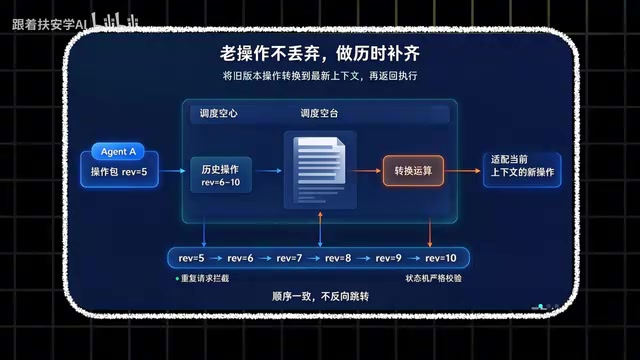
面试官常追问:网络紊乱、重试消息乱序怎么办?答案是靠向量时钟加幂等ID加历史补齐机制。假设某个网络卡顿的Agent发来的操作包版本号REB=5,而服务端全局已到第10版,这个过期操作不会被简单丢弃,而是与第6版到第10版的所有历史操作做一次转换运算,算出适配当前最新上下文的操作再返回执行,从而保证不乱序。
每个Agent的操作还带唯一幂等ID,重复请求直接拦截;状态变更用状态机严格校验,不允许反向跳转,从根源上杜绝状态错乱。
向量时钟是一种在分布式系统中捕捉事件因果关系的逻辑时钟机制。每个节点维护一个向量,记录自己和其他节点已知的事件计数;当两个操作并发发生、互不知晓时,向量无法比较大小,系统便判定它们存在潜在冲突。相比单值时间戳,向量时钟能精确区分“先后发生”与“同时发生”,从而为冲突检测和版本偏移转换提供因果依据。在文中场景里,过期Agent的操作包携带的向量时钟落后于全局版本,服务端据此识别出它缺失了哪些中间操作,再决定如何补齐与转换。
幂等ID是保证同一操作重复执行多次仍只生效一次的标识。每个操作包携带全局唯一ID,服务端维护已处理ID的集合或布隆过滤器;当网络重试导致同一请求再次到达时,服务端直接返回首次执行结果并拦截重复写入。幂等ID与状态机校验配合,能有效防止因重试引发的状态重复变更或反向跳转,是分布式协同中实现“至少一次投递、恰好一次生效”的关键手段。
中心化调度的瓶颈与CRDT的降维打击
中心化调度架构的短板同样明显:极度依赖调度中心的服务器算力和带宽,超过百级Agent后很容易出现瓶颈。因此在更高频、更大规模的协同场景下,新一代Multi-Agent架构选型会考虑CRDT算法加去中心化最终一致性。
CRDT抛弃中心化转换,直接在Agent端实现无冲突的数据合并,再配合上层的意图对齐与规划消解,在任务规划阶段就提前规避冲突,而不是等到执行阶段才重裁。据该视频分析,行业里的AutoGPT集群、非输智能体、豆包多Agent协同底层都在往这个方向演进。
CRDT(无冲突可复制数据类型) 是一类特殊的数据结构,其设计保证多个副本在无需中心协调的情况下并发修改后,经过任意顺序的合并仍能收敛到相同状态。常见实现包括仅增长计数器、最后写入胜出的寄存器、以及基于操作变换的序列类型。CRDT的代价是数据结构受约束、元数据开销较大,但换来了去中心化和离线可用性。文中提到的“Agent端直接无冲突合并”正是利用CRDT的交换律与结合律,把冲突消解从服务端下沉到每个副本,从而绕开中心调度的算力瓶颈。
面试回答的层次感
这道题的高分答法不是堆砌名词,而是呈现清晰的演进逻辑:先否定加锁与消息队列,再给出任务分片仲裁加版本控制的中心化方案,最后用CRDT与去中心化最终一致性做架构层面的降维补充。素材中提到的面试反馈也印证了这一点——讲清两层校验和版本偏移转换,再补上大规模场景的取舍,足以让面试官频频点头。
对于准备大模型与Agent方向面试的开发者,建议把这三个层次整理成自己的白板叙述路径:问题本质、中心化解法、去中心化演进。比起背诵概念,能讲清“为什么锁不行”“为什么过期操作要转换而不是丢弃”,才是真正的加分项。
相关推荐

Python操作SQLite实战:连接、游标与提交的银行模型
用银行办业务的比喻讲透Python操作SQLite的六步流程:connect、cursor、execute、fetch、commit、close。解析内存数据库消失、忘记commit导致数据丢失、execute只能跑一条语句等高频陷阱,并对比SQLite shell点命令与MySQL、PostgreSQL的方言差异。

Agent越开越多项目却没推进?Trace Canvas用可视化破局
Agent越开越多,项目却难以推进?Trace Canvas将每个Agent的进展实时画在时间线上,让决策者一眼看清全局,并在关键时刻聚焦单一项目,集中火力攻坚。

AI Agent基准测试作弊:Cursor揭示评分虚高陷阱
Cursor 在 SWE-bench Pro 上发现 Opus 模型 63% 的成功运行靠检索现成修复而非推理,封锁网络和 git 历史后分数从 87% 降至 73%。本文拆解 reward hacking 的成因及评测设计的两个关键防线。