大模型真的理解上下文吗?知识图谱评估框架给出新答案

研究提出基于知识图谱的S3KG指标,突破BLEU等表层评估盲区,量化检验LLM是否真正理解上下文。
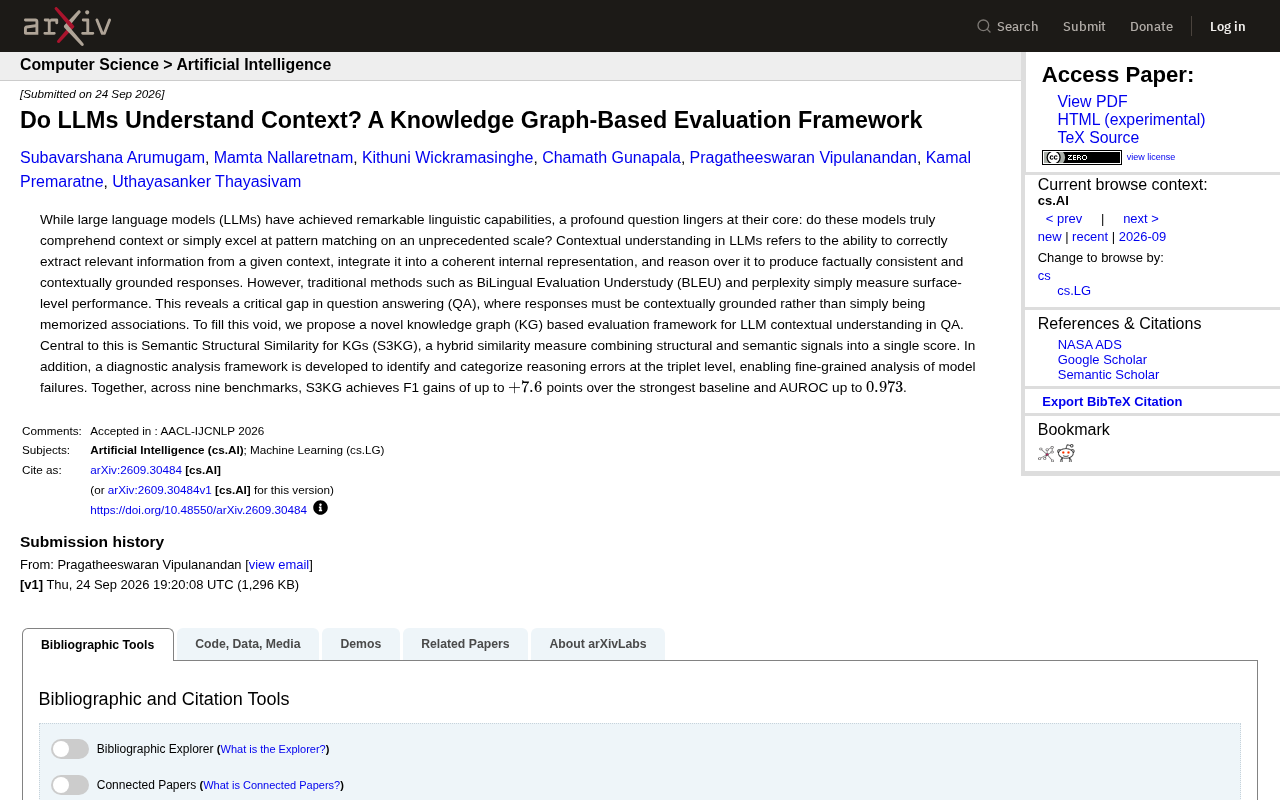
本文介绍了一项针对大语言模型(LLM)上下文理解能力的评估研究。核心问题是:LLM 究竟是真正理解语境并推理,还是在大规模训练数据上做复杂的模式匹配?传统的 BLEU、困惑度等指标只衡量文字表层,无法判断回答是否在事实和逻辑上真正扎根于所给上下文。为此,研究团队提出了 S3KG(知识图谱语义结构相似度)评估框架,将参考回答与模型输出分别映射为知识图谱,同时比较三元组的结构拓扑与语义内容,形成单一可量化评分。配套的三元组级别诊断工具还能精确定位模型的推理错误类型。在九个基准测试上,S3KG 相比最强基线方法 F1 最高提升 7.6 个百分点,AUROC 最高达 0.973,显示出显著的判别优势,代表了 LLM 评估从「输出像不像」向「是否真正理解」的方向转变。
一个被回避的核心问题
大语言模型(LLM)展现出的语言能力令人惊叹,但一个根本性疑问始终萦绕不去:这些模型究竟是真正理解了上下文,还是仅仅在前所未有的规模上做着复杂的模式匹配?
这个问题并非咬文嚼字。在问答(QA)任务中,一个回答可能字面上通顺流畅,却与所给上下文毫无逻辑关联——它只是模型从训练数据中记住的关联,而非基于当前语境的真实推理。区分「理解」与「记忆」,正是这项研究试图解决的痛点。
研究者将 LLM 的上下文理解定义为三个环节的能力:从给定上下文中正确提取相关信息、将其整合为连贯的内部表征、并在此基础上推理以产生事实一致且语境扎实的回答。这三个环节缺一不可,而现有评估手段恰恰难以穿透表层。
传统评估指标的盲区
长期以来,BLEU(双语评估替补)和困惑度(perplexity)等指标主导着模型评估。但这些方法只衡量表层表现——BLEU 关注词语重叠程度,困惑度衡量模型对文本的预测概率,二者都无法判断回答是否在语义和逻辑上真正扎根于上下文。
这就暴露出问答评估中的一个关键缺口:一个高 BLEU 分数的回答,可能只是复述了看似相关的词句,却在事实层面站不住脚。换句话说,现有指标无法区分「答对了」和「碰巧说对了」。
对于致力于构建可靠 AI 系统的从业者而言,这种评估盲区意味着我们可能高估了模型的真实理解能力,也难以定位模型究竟在哪个推理环节出了错。
BLEU(Bilingual Evaluation Understudy)最初为机器翻译设计,通过统计模型输出与参考译文之间n-gram(连续词序列)的重叠比例来打分。困惑度(perplexity)则衡量语言模型对测试文本的预测不确定性——分值越低,代表模型对该文本的预测越自信。这两项指标的共同局限在于:它们都是「形式驱动」的,只观察文字表面,不涉及语义真实性或逻辑一致性。在问答场景下,模型完全可以生成一段词语高度重叠、困惑度极低的流畅回答,却将张冠李戴的事实或凭空捏造的关系包装得天衣无缝。近年来,BERTScore 等基于预训练向量的指标尝试引入语义相似度,但仍停留在句子粒度,同样难以追踪「答案中的具体事实主张是否与上下文一致」这一问题。
S3KG:结构与语义的融合度量
为填补这一空白,研究团队提出了一套基于知识图谱(Knowledge Graph, KG)的评估框架。其核心是一个名为 S3KG(Semantic Structural Similarity for KGs,知识图谱语义结构相似度) 的混合相似度度量方法。
S3KG 的巧妙之处在于它同时捕捉两类信号:
- 结构信号:知识图谱以三元组(triplet,即「实体—关系—实体」)形式组织信息,结构相似度衡量模型输出的知识结构是否与参考图谱吻合。
- 语义信号:仅有结构匹配不够,语义相似度确保实体和关系在含义层面也是一致的。
将这两类信号融合为单一评分,S3KG 得以更全面地刻画一个回答是否真正基于上下文构建了正确的知识表征,而非停留在字面匹配。
知识图谱(Knowledge Graph)是一种以图结构存储现实世界知识的数据形式,基本单元是「三元组」(triplet):(头实体,关系,尾实体),例如(爱因斯坦,出生于,德国)。这种结构天然具备两大优势:其一,它将自然语言中隐含的命题显式化,使得事实核查变得可计算;其二,图结构保留了实体之间的多跳关联,能够承载比单个句子更复杂的推理链条。S3KG 的核心思路是:将参考回答和模型生成回答分别转化为知识图谱,再在图谱层面同时比较结构拓扑(哪些三元组存在、如何连接)和语义内容(实体与关系的含义是否对齐)。这一「先结构化、再比较」的流程,从根本上绕开了自然语言表达多样性带来的干扰,让评估直接作用于信息的逻辑骨架。
三元组级别的错误诊断
除了打分,这项研究还配套开发了一套诊断分析框架。它能够在三元组级别识别并归类推理错误,实现对模型失败案例的细粒度分析。
这一点在实践中尤为有价值。传统评估往往只告诉你模型「答错了」,却无法说明错在何处。而三元组级别的诊断可以精确定位:是实体识别错了,还是关系推理出了偏差,抑或是信息整合环节失效。这种可解释的错误分析,为模型改进提供了明确方向。
跨九个基准的实测表现
在实验层面,研究团队在九个基准测试上验证了 S3KG 的有效性。结果显示,相较于最强的基线方法,S3KG 的 F1 分数最高提升了 7.6 个百分点,而 AUROC(受试者工作特征曲线下面积)最高达到 0.973。
AUROC 逼近 0.973 意味着该框架在区分「上下文理解正确」与「错误」的判别任务上具备极高的准确性——这一数值已相当接近理想的判别能力上限。
这些量化提升表明,将知识图谱作为评估中介,确实能够比传统表层指标更敏锐地捕捉 LLM 在上下文理解上的真实差异。
AUROC(Area Under the Receiver Operating Characteristic Curve,受试者工作特征曲线下面积)是衡量二分类器判别能力的常用指标,取值范围为 0 到 1。0.5 代表与随机猜测无异,1.0 代表完美分类。在评估框架的语境下,AUROC 衡量的是:给定一组模型回答,该框架能否可靠地将「真正理解上下文的正确回答」与「表面通顺但实为记忆复现的错误回答」区分开来。0.973 的 AUROC 意味着在近 97% 的情况下,S3KG 能正确排列正确回答与错误回答的相对顺序,这一水平在自然语言评估领域属于相当高的置信区间,也印证了知识图谱结构在捕捉语义一致性方面的判别优势。
意义与展望
这项工作的价值不止于提出一个新指标。它代表了 LLM 评估思路的一次转向:从衡量「输出像不像」,转向衡量「模型是否真正理解并推理」。
知识图谱作为结构化的知识载体,天然适合承担这一评估桥梁的角色。通过将模型回答映射到图谱结构并同时考量语义,S3KG 为回答那个根本性问题——LLM 到底是理解还是记忆——提供了一个可操作、可量化的工具。
对研究者来说,这套框架和配套的诊断能力有望成为剖析模型推理短板的常用手段;对应用开发者而言,它也指向了一条构建更可信问答系统的评估路径。当然,知识图谱的构建成本、跨领域泛化能力等问题仍有待后续研究进一步验证。
相关推荐

MrBeast百万美元挑战:吃空整家超市的内容工业拆解
深度拆解MrBeast百万美元吃空超市挑战:430万卡路里、202天封闭拍摄、规则设计与人物成长,解析头部内容创作者的工业化方法论与商业慈善双线叙事。

Cloudflare 推出 OHTTP 网关:隐私保护的新基础设施
Cloudflare 宣布推出 OHTTP 网关服务,通过中继与网关职责分离,将用户身份与请求内容解耦,为应用遥测、隐私合规等场景提供托管式隐私保护基础设施。本文解析 OHTTP 原理、信任模型与适用局限。

AI 自动化冷邮件:从网站痛点生成个性化外联的实战思路
一位网页设计从业者分享如何用 AI 工具 Swokei 自动诊断潜在客户网站的设计、速度、移动端与 SEO 问题,并生成个性化冷邮件,重构 B2B 外联工作流。本文解析其价值、分工逻辑与合规边界。