大小模型协作新框架ANCHOR:基于事件簇的5W1H抽取
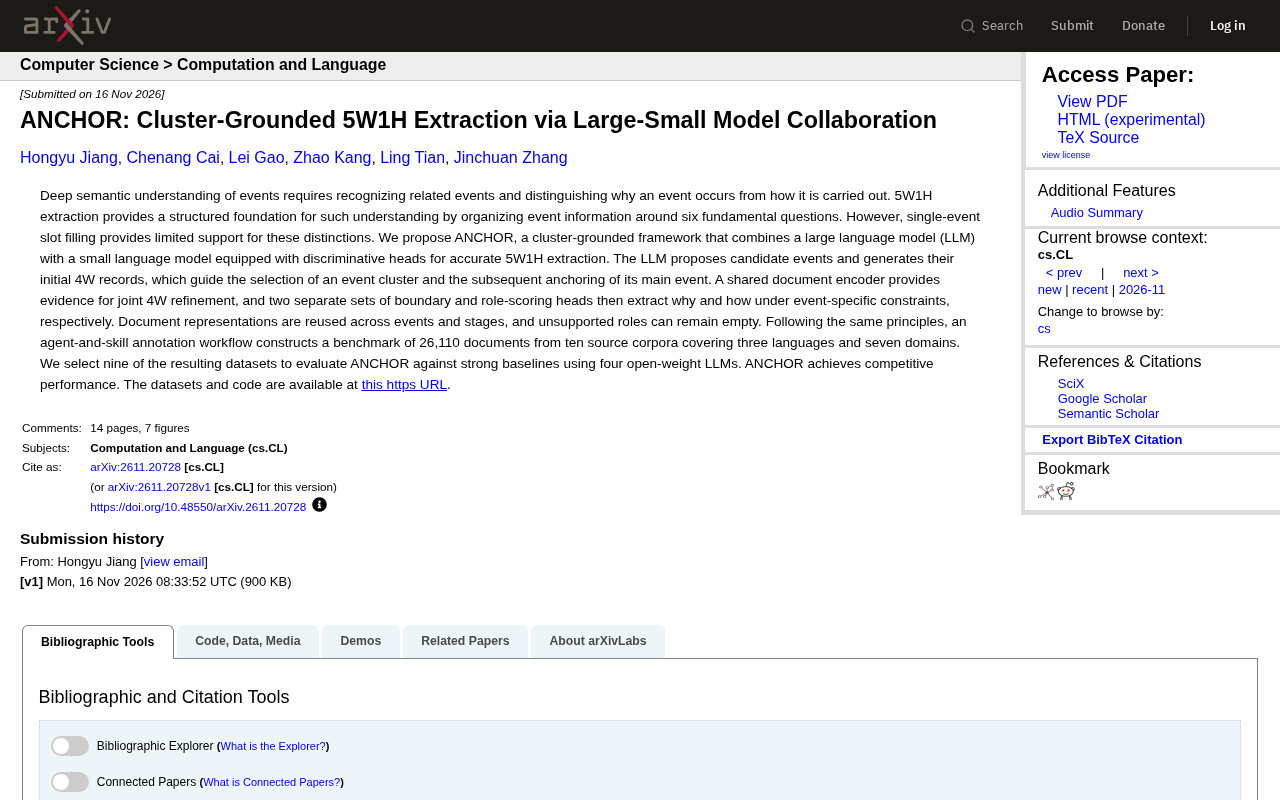
ANCHOR框架通过LLM与SLM协作,实现基于事件簇的5W1H抽取,并构建多语言多领域基准。
ANCHOR是一个基于事件簇的5W1H抽取框架,旨在解决传统单事件槽位填充难以区分“为何发生”与“如何执行”的问题。该框架让大语言模型(LLM)提议候选事件并生成初始4W记录(Who、What、When、Where),再指导事件簇选择与主事件锚定;小语言模型(SLM)则通过共享文档编码器和独立的边界与角色评分头,精炼4W并分别提取Why和How。研究者还构建了包含26,110篇文档、覆盖三种语言和七个领域的基准,在九个数据集上与四个开放权重LLM对比,ANCHOR取得有竞争力的性能。代码与数据集已开源,支持后续研究复现与扩展。
事件理解的核心,不仅在于识别单个事件,更在于厘清事件之间的关联,并区分“为何发生”与“如何执行”。5W1H抽取通过六个基本问题(Who、What、When、Where、Why、How)为这种结构化理解提供了基础。然而,传统的单事件槽位填充方法难以支撑上述区分。为此,研究者提出ANCHOR——一个基于事件簇的框架,通过大语言模型(LLM)与小语言模型(SLM)的协作,实现更准确的5W1H抽取。

大小模型分工:LLM提议,SLM精炼
ANCHOR的核心设计是将LLM的生成能力与SLM的判别能力相结合。LLM首先提议候选事件,并生成其初始的4W记录(Who、What、When、Where)。这些记录随后用于指导事件簇的选择,并锚定簇中的主事件。一个共享的文档编码器为4W的联合精炼提供证据支持。在此基础上,两组独立的边界与角色评分头分别提取“Why”和“How”,且各自受事件特定约束。文档表示在不同事件和阶段之间复用,而缺乏支持的槽位可以保持为空,从而避免强制填充带来的噪声。
这种协作模式的关键在于:LLM负责开放式的候选生成与初始结构化,SLM则利用判别式头进行精准的边界判定与角色分类。两者共享文档编码器,既减少了重复计算,又保证了证据的一致性。
5W1H抽取是事件抽取的一个子任务,目标是从文本中识别事件的六个要素:Who(参与者)、What(动作/事件类型)、When(时间)、Where(地点)、Why(原因/动机)、How(方式/手段)。传统方法通常将其视为槽位填充问题,即为每个事件单独抽取各要素。然而,现实文本中事件往往成簇出现,共享部分要素,且“为何发生”(Why)与“如何执行”(How)需要更复杂的推理,难以通过简单的序列标注解决。
基准构建:多语言多领域的大规模标注
遵循相同的设计原则,研究者构建了一套agent-and-skill标注流程,从十个源语料库中构建了包含26,110篇文档的基准,覆盖三种语言和七个领域。这一基准的规模与多样性为5W1H抽取的评估提供了坚实基础。研究者从中选取了九个数据集,使用四个开放权重LLM对ANCHOR与强基线进行对比评估。
实验结果表明,ANCHOR取得了具有竞争力的性能。数据集与代码已在GitHub上公开(https://github.com/revolution6575/ANCHOR-5W1H),为后续研究提供了可复现的资源。
事件簇(event cluster) 指同一文档中语义相关的一组事件,它们可能共享参与者、时间或地点,但具有不同的子事件或不同粒度。ANCHOR利用事件簇来组织抽取过程:先由LLM提议候选事件并生成初始4W记录,再基于这些记录选择事件簇并锚定簇中的主事件。这种设计使得模型能够利用事件间的关联信息,同时区分“为何发生”与“如何执行”的抽取路径,避免了单事件独立处理时的信息孤立问题。
技术细节与设计考量
ANCHOR的架构包含几个关键组件:LLM候选生成模块、事件簇选择与主事件锚定模块、共享文档编码器、以及用于4W精炼和Why/How提取的判别头。文档表示的重用机制使得模型在处理同一文档中的多个事件时,无需重复编码,提升了效率。此外,允许角色槽位为空的设计,体现了对现实场景中信息不完整性的包容,避免了过度推断。
在评估方面,研究者选择了四个开放权重LLM作为基础模型,与强基线进行对比。虽然原文未披露具体的性能数字,但“具有竞争力”的表述暗示ANCHOR在多数设定下不逊于甚至优于现有方法。
开放权重LLM(open-weight LLM) 指模型参数公开可下载、允许本地部署和微调的大语言模型,如Llama、Mistral等。与仅提供API的闭源模型相比,开放权重模型便于研究者进行可复现的对比实验和隐私敏感场景下的部署。ANCHOR选择四个开放权重LLM作为基础模型进行评测,既保证了实验的可重复性,也降低了评估成本,同时为后续社区基于这些模型进行改进提供了便利。
意义与展望
ANCHOR的价值在于将5W1H抽取从单事件槽位填充提升到事件簇层面,并通过大小模型协作平衡了生成灵活性与判别准确性。多语言多领域的基准构建也为该任务的标准化评估做出了贡献。未来,这一框架有望扩展到更复杂的事件关系推理和跨文档事件理解中。
对于研究者和开发者而言,ANCHOR的开源实现降低了进入门槛,可以基于其代码和基准进行进一步探索。无论是改进小模型判别头的设计,还是扩展事件簇的构建策略,都有丰富的空间。
相关推荐

AI代打电话?Muse让语音助手替你预约
Muse推出AI代打电话功能,仅限美国付费订阅用户。本文分析语音助手切入电话场景的产品逻辑、付费墙策略与语音代理的想象空间及隐私隐忧。
谷歌PaperOrchestra:多智能体框架自动化写AI论文
谷歌研究院开源 PaperOrchestra 多智能体框架,将 AI 研究论文写作拆解为文献、方法、实验等子任务,由不同智能体协作编排完成,GitHub 已获 2093 星,今日新增 313 星。

Marimba:0.6B小模型如何用单一编码器处理语音问答
Marimba 是一个基于 Qwen3-ASR-0.6B 编码器的轻量语音问答模型,支持流式处理、本地运行,可作为轮次检测器接入 Pipecat、LiveKit 和 Vapi,在特定任务上超越大模型。