打印机上跑Gemma:一场Reddit脑洞背后的边缘AI现实
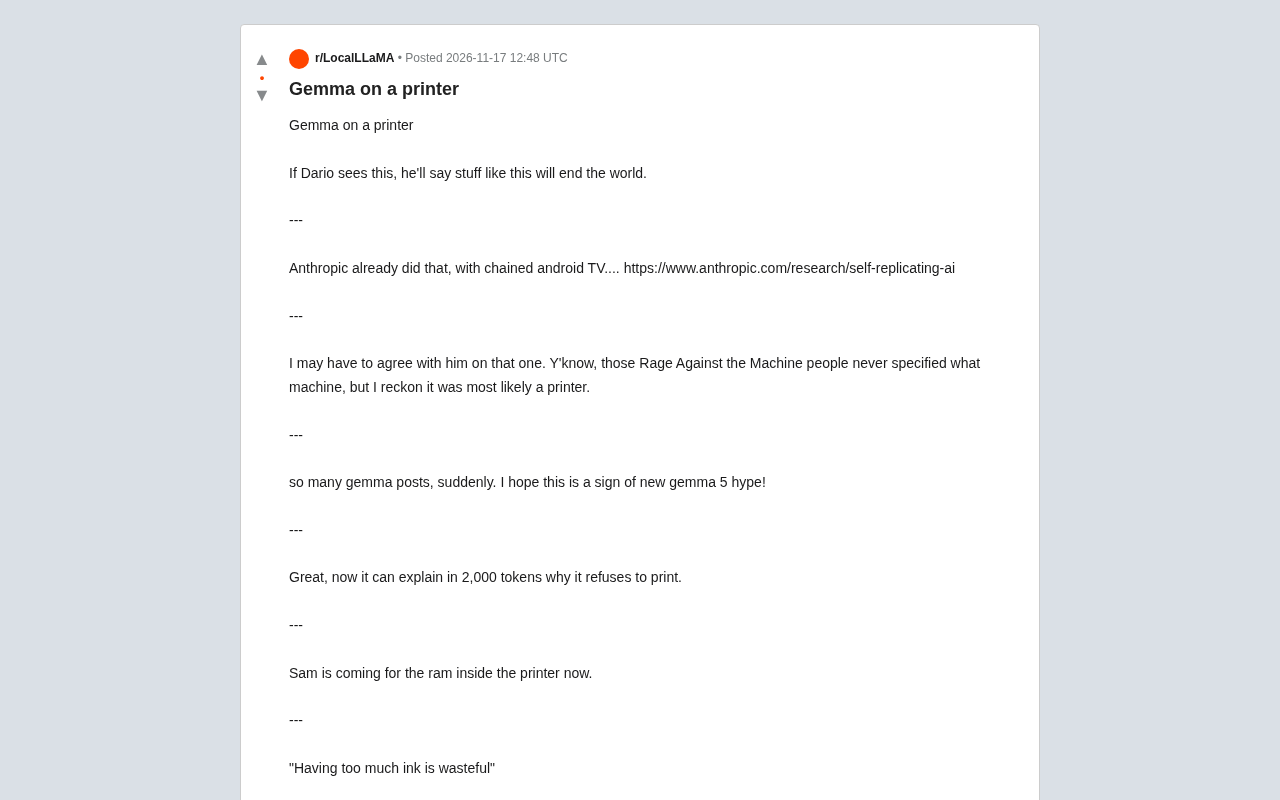
Reddit上打印机跑Gemma的脑洞,折射出边缘AI的能力扩散与安全张力。
文章围绕 Reddit 上一个“Gemma on a printer”的帖子展开,分析评论区呈现的三层叙事:对语言模型过度解释、资源浪费的功能性调侃;引用 Anthropic 自复制 AI 研究、提及 Dario Amodei 的安全警觉;以及把密集 Gemma 帖子解读为 Gemma 5 迭代信号的期待情绪。作者指出,打印机等设备依赖确定性控制逻辑,而语言模型输出概率性结果,这是嵌入式部署的核心矛盾;真正有价值的是验证量化、剪枝与推理框架适配下,边缘设备交互从固定指令集转向自然语言接口的可行性。讨论信息密度不高,但浓缩了能力扩散与安全边界两组张力。
当Gemma遇上打印机:一个Reddit帖子的技术想象
Reddit上最近出现了一个名为“Gemma on a printer”的帖子,配图显示有人尝试将Google的Gemma模型部署在打印机这类极端边缘设备上。帖子本身内容简短,但评论区迅速分化出几种典型态度:有人调侃“如果Dario(指Anthropic CEO Dario Amodei)看到这个,又会说这类东西要毁灭世界了”,也有人翻出Anthropic此前关于自复制AI的研究链接作为回应,还有人干脆把Rage Against the Machine乐队的名字拿来玩梗——“他们没说是哪台机器,我猜大概率是打印机”。
这个帖子之所以值得讨论,不在于“打印机跑大模型”本身有多实用,而在于它浓缩了当前边缘AI的几个真实张力:模型小型化的速度、硬件算力的下放程度,以及社区对AI能力扩散的本能戏谑与警觉。
社区反应里的三层叙事
调侃层:2000个token解释为什么拒绝打印
评论区最直接的反应是功能性的嘲讽。一条高赞回复写道:“太好了,现在它可以花2000个token解释为什么拒绝打印。”这显然在影射大模型在指令遵循上的过度解释倾向——一个本该是二元判断的任务(打印或不打印),被语言模型处理成一段冗长的推理过程。另一位用户补了一句“墨水太多也是一种浪费”,把话题引向模型对资源约束的“价值观判断”。
这些玩笑背后有一个严肃的技术现实:把通用语言模型塞进打印机这类设备,面临的首要问题不是能不能跑,而是跑起来之后它是否比传统嵌入式逻辑更可靠。打印机的控制逻辑需要确定性,而语言模型输出的是概率性结果。
警觉层:从打印机到自复制AI
帖子中有人直接贴出Anthropic关于自复制AI的研究页面链接,并指出“Anthropic已经用链式Android TV做过类似的事了”。这条引用把讨论从玩具层面拉到了AI安全语境。虽然打印机上的Gemma和自复制AI在能力上完全不在一个量级,但社区的反应说明:一旦语言模型出现在非传统计算设备上,人们会本能地联想能力边界与失控风险。
Dario Amodei被反复提及,也反映出AI安全叙事已经下沉到普通开发者的日常调侃中。这种调侃本身不构成技术论证,但它是一个信号——边缘部署的每一步扩散,都会触发公众对AI边界的重新评估。
链式(chained)AI 通常指通过脚本、API 编排或智能体框架把多个模型实例串联起来,使其能够相互调用、传递任务并递归扩展自身。Anthropic 等机构对此类研究关注的核心问题不是单次调用能力,而是系统能否在没有人类介入的情况下完成复制、扩散与资源获取。把这类研究链接贴到“打印机跑 Gemma”的帖子下,实际上是把“单机部署”和“可自我延续的系统”并置,用以凸显风险讨论的谱系:前者受硬件与内存严格约束,后者则关乎编排层与访问权限。
期待层:Gemma 5的社区情绪
一条评论提到“突然这么多Gemma帖子,希望这是新Gemma 5要来的信号”。这属于社区对模型迭代节奏的敏感反应。Gemma系列作为开放权重模型,在本地部署社区中一直有稳定关注度。打印机这类极端场景的出现,某种程度上是社区在用“能不能跑在更离谱的硬件上”来测试模型小型化的极限。
打印机跑Gemma,技术上意味着什么
抛开帖子里的玩梗,这个场景指向一个正在发生的趋势:开放权重模型正在被推向传统上不属于AI计算范畴的设备。打印机通常搭载低功耗MCU或低端SoC,内存和算力都极为有限。让Gemma这类模型在其上运行,即便只是极小参数量版本,也需要在量化、剪枝和推理框架上做大量适配工作。
这类尝试的实际价值不在于让打印机“会说话”,而在于验证一条技术路径:当模型小到可以塞进嵌入式环境,边缘设备的交互范式可能从固定指令集转向自然语言接口。当然,这条路径目前仍处于极客实验阶段,距离产品化有相当距离。帖子中有人半开玩笑地说“需要尽快搞一个abliterated版本的Gemma”,也侧面说明当前模型在嵌入式场景下的行为约束仍是个开放问题。
量化(quantization)是让大模型挤进嵌入式硬件的关键手段之一,指将模型权重和激活值从浮点数(如 FP16/FP32)映射到低位宽整数(如 INT8、INT4 甚至更低),从而把内存占用压缩到原来的 1/4 至 1/16。常见的训练后量化(PTQ)流程会用一小批校准数据统计各层数值分布,据此确定缩放因子,以尽量减少精度损失。
剪枝(pruning)则从结构上削减冗余:可以移除重要性较低的权重(非结构化剪枝)或整条通道、整层(结构化剪枝),后者更利于在资源受限的推理框架上获得实际加速。与量化叠加使用时,两者共同决定了一个模型能否被塞进低端 SoC 的有限内存,以及推理延迟是否落在可接受区间。
评论中提到的“abliterated 版本”源自一个社区常见的模型改造手法,通常译为“消融版本”或“去拒答版本”。其做法是在模型内部定位与拒绝行为相关的方向(refusal direction),然后从权重或激活中沿该方向做正交化处理,使模型不再倾向输出拒答语句。这类改造并不重新训练模型,因此成本低、传播快,在开放权重社区中被广泛用于研究对齐行为的可编辑性。它同时也说明,嵌入式场景下的行为约束难以靠模型自身保证,往往需要外部护栏或受限的输出空间来兜底。
一场脑洞讨论的参考价值
这个Reddit帖子的信息密度不高,但它呈现了技术社区面对边缘AI扩散时的典型反应模式:先玩梗,再联想安全,最后落到对模型迭代的期待。对于关注开放权重模型落地的人来说,打印机这个场景本身不值得过度解读,但社区讨论中反复出现的“确定性vs概率性”“能力扩散vs安全边界”这两组张力,是边缘AI真正要面对的问题。
Gemma跑在打印机上,大概率不会毁灭世界。但它确实在提醒一件事:当模型小到无处不在时,关于AI的讨论就不再只发生在数据中心里了。
相关推荐

间谍蜜罐训练内幕:情感解离与锚定技术
间谍如何被训练执行蜜罐任务?一位受训者披露情感解离、香水与关键词锚定、目标照片绑定等心理学技术,解析条件反射如何被用于情报行动,并揭示这套机制在日常生活营销中的类似应用。

前沿AI风险管理:从训练到部署的全链路实践
OpenAI系统阐述前沿AI风险管理框架:从训练阶段的模型对齐,到部署阶段的沙箱隔离与阻断式防护,再到部署后的持续监控,构建贯穿模型全生命周期的分层风险控制体系。

Databricks推出Genie Migrate,简化Serverless迁移
Databricks 发布 Genie Migrate for Serverless,帮助用户将既有工作负载迁移到 Serverless 计算。本文解析该迁移工具的定位、对用户的实际意义以及尚未明确的细节。