代码智能体该遵循先例还是任务意图?

代码智能体在修改现有项目时强烈跟随仓库先例,但书面优先级规则能有效引导其偏离惯例。
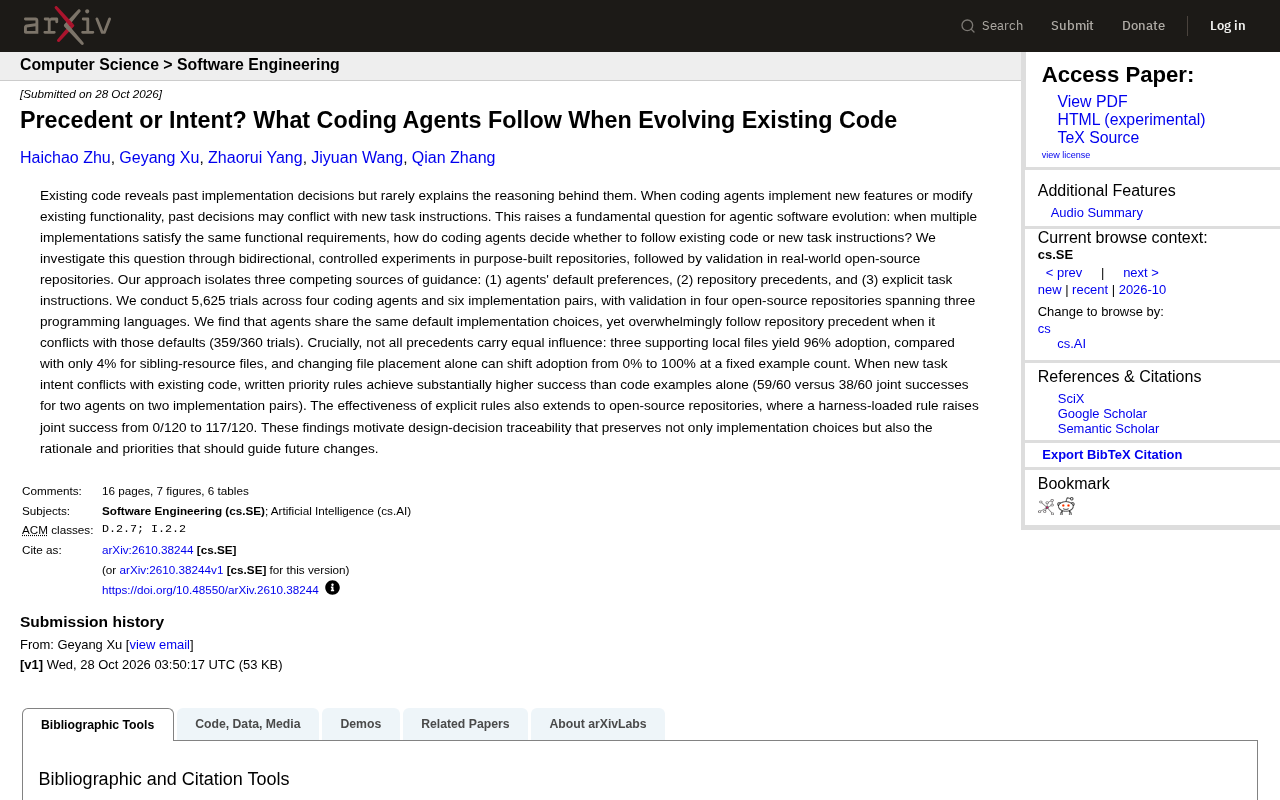
一项大规模对照实验研究了代码智能体在仓库先例与任务意图冲突时的决策规律。实验覆盖四个智能体、六组实现配对,共进行 5,625 次试验。核心发现是:当仓库中存在与默认偏好冲突的先例时,智能体几乎总是跟随先例(359/360次);但先例的影响力高度依赖呈现方式——三个本地支持文件带来96%采纳率,而兄弟资源文件仅4%,固定示例数量下改变文件位置可使采纳率从0%跃升至100%。当新任务意图需要压过先例时,书面优先级规则的联合成功率为59/60,显著高于代码示例的38/60;在真实开源仓库中,通过harness加载的规则将联合成功率从0/120提升至117/120。研究建议支持设计决策可追溯性,记录实现选择背后的理由与优先级。
代码智能体在修改现有项目时,常常面临一个隐性冲突:仓库里已有的实现方式与本次任务的新要求不一致。它们会倾向于模仿旧代码,还是遵从新指令?一篇题为《Precedent or Intent? What Coding Agents Follow When Evolving Existing Code》的研究,通过大规模对照实验回答了这个问题,并给出了对工程实践有直接指导意义的结论。
实验设计:隔离三种引导来源
研究者的思路是构建专门的控制实验仓库,把可能影响智能体决策的因素拆开。他们识别出三种相互竞争的引导来源:智能体自身的默认偏好、仓库中已有代码的先例、以及任务指令中的明确要求。
实验在两个方向上展开:先让智能体在没有先例干扰的情况下实现功能,观察其默认选择;再在仓库中植入不同形式的先例,看先例是否以及多大程度上覆盖默认行为。整个研究覆盖四个代码智能体、六组实现配对,共进行 5,625 次试验,随后在四个开源仓库中做验证,涉及三种编程语言。
这种双向控制设计的价值在于,它不只观察到“智能体会跟随先例”这一现象,还能量化先例的强度,并分离出究竟是先例的哪个维度在起作用。
核心发现:先例压倒默认偏好,但强度差异巨大
第一个结论相当明确:不同智能体在没有先例时表现出高度一致的默认实现偏好,然而当仓库中存在与默认偏好冲突的先例时,它们几乎无一例外地跟随先例——在 360 次相关试验中,有 359 次选择了先例。
但“跟随先例”并不是一个均质的现象。研究者发现,先例的影响力高度依赖于它的呈现方式。
本地支持文件的影响远超兄弟资源文件
在同等条件下,三个支持性的本地文件能带来 96% 的采纳率,而兄弟资源文件(sibling-resource files)的采纳率只有 4%。这意味着,智能体并不是简单地扫描仓库中“有没有类似代码”,而是对先例与当前任务的邻近程度、上下文关联度高度敏感。
兄弟资源文件(sibling-resource files) 指的是与目标文件位于同一目录层级、功能上可能相关但并非直接支持目标的文件,例如同级的测试文件、配置文件或同类模块。它们与当前任务的上下文关联较弱,智能体在检索时可能将其视为“背景噪音”而非可参考的先例。相比之下,本地支持文件 是直接服务于当前目标的辅助文件,如紧邻目标文件的工具函数、类型定义或明确的示例片段,其上下文关联度高,智能体更容易将其识别为“可模仿的模板”。这一区分揭示了智能体对先例的选择并非基于文件数量或语法相似度,而是基于文件与当前任务在语义和结构上的邻近性。因此,在仓库中组织代码时,将关键约定或示例放在目标文件附近,能显著提高智能体采纳的概率。
放置位置本身就能翻转结果
更引人注目的是,在示例数量固定的情况下,仅改变文件的放置位置,采纳率就能从 0% 跳到 100%。这说明先例的“可见性”和“可发现性”几乎决定了它是否被采纳。对开发者而言,这提示了一个容易忽视的事实:代码的组织结构本身就是一种隐式指令。
当任务意图与先例冲突:书面规则胜过代码示例
研究的第二个方向处理的是更棘手的场景——新任务意图明确要求与现有代码不同的做法。此时,仅靠代码示例来传达新意图的效果有限:在两个智能体、两组实现配对的联合任务中,代码示例仅达到 38/60 的联合成功率。
相比之下,写成文字的优先级规则表现显著更好,达到 59/60 的联合成功率。这种优势在真实开源仓库中也得到验证:通过 harness 加载的规则将联合成功率从 0/120 提升到 117/120。
这一对比的工程含义很清楚:如果你希望智能体在某次修改中偏离仓库惯例,光放几个“正确写法”的示例不够,你需要明确写出优先级——在新意图与旧先例冲突时,哪一个应当胜出。
联合成功率 是本研究采用的核心评估指标,指智能体在多个任务维度上同时满足要求的比例。例如,一个联合任务可能要求智能体既遵循新的实现方式,又保持与现有代码的兼容性,只有两个条件都满足才计为成功。这一指标比单一维度的成功率更严格,因为它能捕捉智能体在冲突场景下的综合表现。研究中,代码示例仅达到 38/60 的联合成功率,而书面优先级规则达到 59/60,说明单纯提供“正确写法”的示例不足以让智能体在多个约束下做出正确权衡,而明确写出优先级规则能显著降低智能体在冲突时的决策模糊性。联合成功率的高低直接反映了引导方式在复杂任务中的有效性。
对工程实践的启示
这些发现指向一个更宏观的结论:代码智能体的行为高度可塑,而塑形它的不只是任务描述本身,还包括仓库的物理结构和你是否显式表达了优先级。
从工具设计角度看,研究者提出应当支持“设计决策可追溯性”——不仅记录实现选择,还记录背后的理由和优先级,让未来的修改有据可依。这是一个值得关注的方向,因为当前的代码仓库通常只保留“做了什么”,而丢失了“为什么这样做”以及“什么情况下可以违背”。
对日常使用代码智能体的团队来说,可操作的结论有三点:把关键约定放在智能体容易发现的位置;需要偏离惯例时,用文字规则而不是示例来表达优先级;把重要设计决策的理由写进仓库,而不只是留下代码。
设计决策可追溯性(design decision traceability) 是指不仅记录代码中“做了什么”,还记录“为什么这样做”以及“在什么条件下可以违背”。在传统仓库中,这些信息往往散落在提交信息、注释或外部文档中,智能体难以系统性地获取。研究者建议以结构化方式(如规则文件、决策日志)将设计理由和优先级与代码一同存储,使智能体在修改时能检索到显式的约束条件。这一概念与软件工程中的“架构决策记录(ADR)”类似,但更强调机器可读性,以便智能体在生成代码时能直接引用。实现可追溯性有助于减少智能体对先例的盲目模仿,使其在需要偏离惯例时有据可依。
总结
这项研究用受控实验和真实仓库验证相结合的方式,揭示了代码智能体在“先例”与“意图”之间的决策规律:它们强烈倾向于跟随先例,但先例的效力取决于呈现方式;而当意图需要压过先例时,书面优先级规则远比代码示例有效。这些结论既解释了智能体在遗留代码库中为何常常“照旧行事”,也为如何更精确地引导它们提供了依据。
相关推荐
WorkBuddy实战:腾讯AI Agent如何让大模型真正动手干活
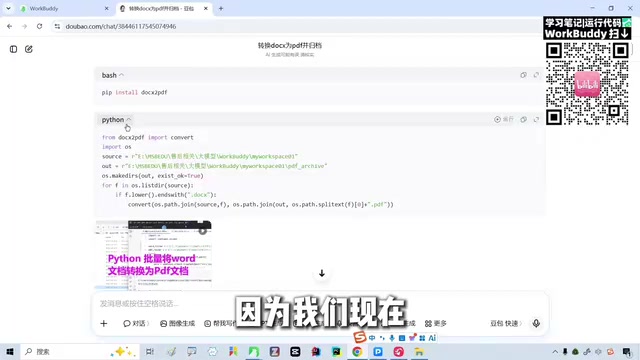
WorkBuddy是腾讯推出的办公场景AI Agent工具,能理解自然语言需求并直接操作电脑完成任务。本文通过文件转换实战演示,对比豆包等聊天大模型与Agent的核心差异,分析WorkBuddy与CodeX的能力差距及适用场景。
Vibe Coding保姆级教程:3步上手AI编程
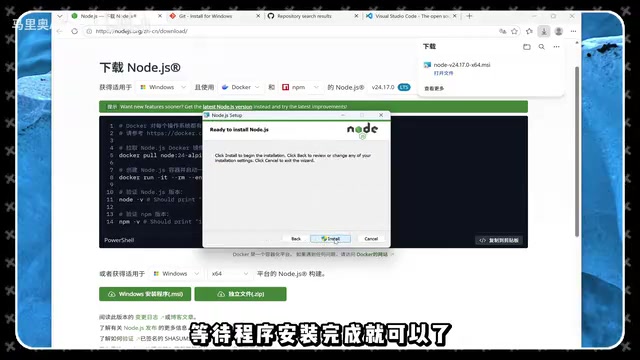
一篇面向零基础用户的Vibe Coding保姆级教程,分三步讲解Claude Code安装、DeepSeek API接入与编辑器调度配置,附常见报错解决方法和踩坑提醒。
Instagram放任名人AI深伪内容泛滥?
一张AI生成的Mia Goth照片经Instagram蓝V认证账号发布后全网疯传,Google AI Overview将其当作真实信息摘要。Taylor Swift和Lionel Messi的AI视频播放量达百万级,Meta却不要求AI照片标注,平台治理面临失效质疑。