单卡在家微调:Jev风格决策模型的实测表现

独立开发者用单张消费级GPU将开源大模型蒸馏微调为22-28ms延迟的轻量决策模型,并坦诚披露基准局限。
项目Jeff由独立开发者主导,将Qwen3.5和Gemma 4两款开源基础模型通过蒸馏与微调,缩减为0.8B和2B参数的决策模型,全程在单张消费级GPU上完成。这两款模型的推理延迟被控制在22至28毫秒之间,且提供可复现的运行命令以供验证。项目刻意区分了0.8B(极低延迟)和2B(能力与速度均衡)两个规格,两者共享同一套Jev请求格式,便于按需切换。更难得的是,项目主动说明了基准测试在哪些场景下会与真实工作脱节,帮助潜在使用者建立合理预期。这一实践验证了个人开发者借助开源模型与参数高效微调技术定制专属AI的可行路径,降低了轻量决策能力的落地门槛。
一个独立项目的野心
在大模型军备竞赛日趋白热化的当下,一个独立开发者项目选择了另一条路径:用一张消费级GPU,在家完成决策模型的微调。这个名为Jeff的项目将Qwen3.5和Gemma 4两款基础模型,分别蒸馏、微调成0.8B和2B参数的决策模型,专门用于处理Jev定义的请求结构(request shape)。
所谓「决策模型」,并非通用对话助手,而是针对特定场景下快速给出判断或分类结果的轻量模型。这类模型的核心诉求不是知识广度,而是延迟、稳定性和与既有系统的兼容性。
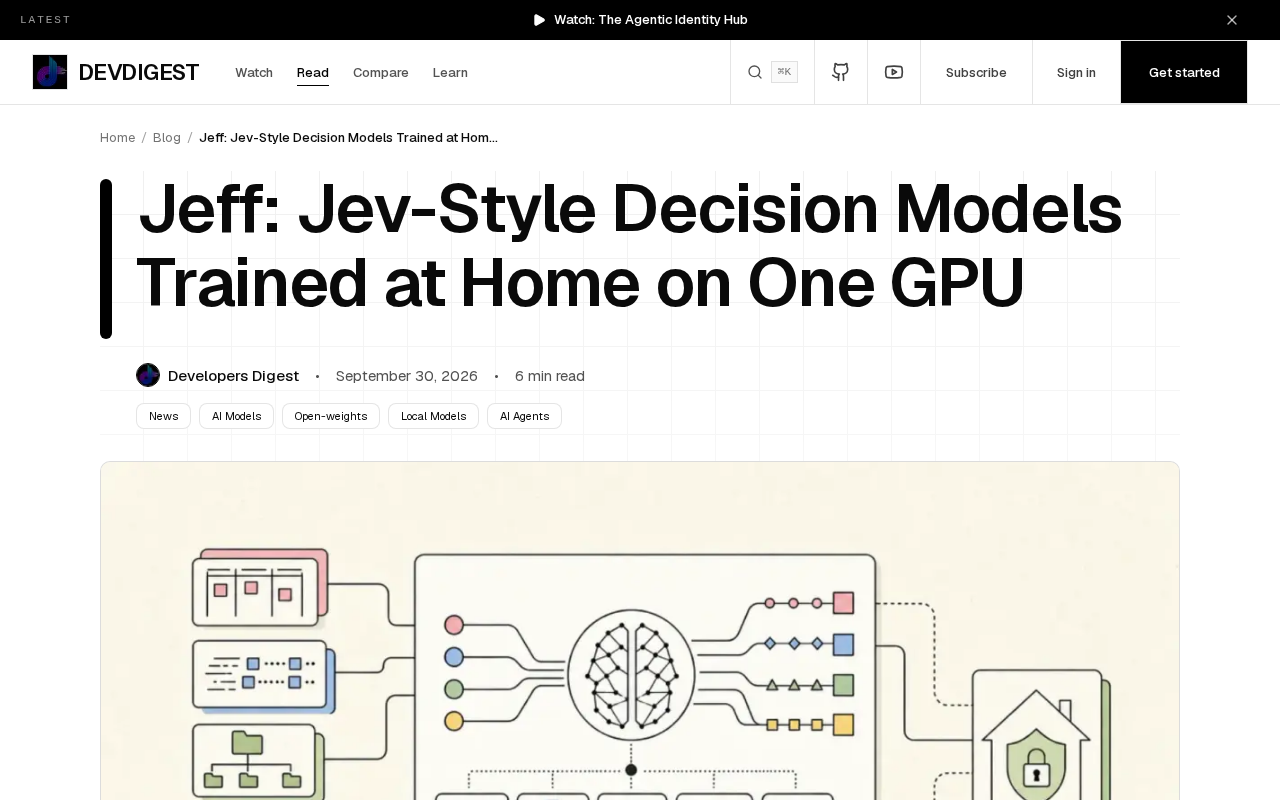
**知识蒸馏(Knowledge Distillation)是将大模型能力迁移到小模型的核心技术。其基本原理是让小模型(学生)学习大模型(教师)的输出分布,而非仅学习硬标签,从而让小模型在参数量大幅减少的情况下保留大模型的部分推理能力。蒸馏后再结合参数高效微调(PEFT)**方法——如LoRA(低秩适配),仅更新模型极小比例的参数——就可以在单张消费级GPU上完成整个流程。LoRA的核心思路是在原始权重矩阵旁边附加低秩分解矩阵,微调时只训练这些附加参数,显存占用可降低数十倍。正是这两项技术的组合,使得个人开发者能够在家用硬件上将Qwen3.5、Gemma等通用基础模型改造为特定用途的专用模型。
22-28毫秒的实测延迟
项目最引人注目的数据,是这些模型在推理时能够将响应时间控制在22到28毫秒之间。对于需要嵌入实时决策流程的应用而言,这个量级的延迟意味着它可以被放进对响应速度敏感的链路中,而不会成为瓶颈。
值得关注的是,项目方强调这些是「经过验证的数字」(verified numbers),并公开了对应的运行命令,让其他人能够复现测试。这种透明度在当下充斥着营销话术的模型发布中并不多见——它把基准测试的复现权真正交还给了读者。
参数规模与延迟的权衡
0.8B和2B两个规格的设定颇具考量。0.8B模型足够小,可以在极为有限的显存下运行,适合追求极致延迟的场景;2B模型则在能力和速度之间寻求平衡,适合对决策质量要求更高的任务。两者共享同一套Jev请求格式,意味着可以按需切换而不必重构调用逻辑。
理解延迟的构成有助于评估这些数字的实际含义。模型推理延迟通常由三部分组成:输入的tokenization与预处理、模型前向传播计算、以及输出的解码。对于决策类任务,输出序列极短(通常只需输出一个分类标签或几个词),解码耗时可忽略,瓶颈主要在前向传播。0.8B模型在单张GPU上的前向传播耗时之所以能压到毫秒级,是因为其参数量足够小,整个模型权重可以完整驻留在GPU显存中,避免了显存换入换出的开销。相比之下,超过GPU显存容量的模型需要频繁在CPU和GPU之间搬运数据,延迟会显著上升。
基准测试的边界在哪里
这个项目最诚实的部分,是它明确指出了「基准测试在哪里不再匹配真实工作」(where the benchmark stops matching real work)。这是许多模型发布刻意回避的问题。
实验室里漂亮的延迟数字,往往建立在理想化的输入分布、固定的批处理大小和干净的请求格式之上。一旦进入真实生产环境,输入的多样性、并发压力、边缘案例都会让基准数据打折扣。承认这一点,反而让项目的可信度大大提升。
为什么这种坦诚很重要
对于考虑采用此类模型的开发者,了解基准与现实的差距,比单纯知道最佳情况下的数字更有实用价值。它帮助使用者建立合理的预期,避免在部署后才发现性能落差。
基准测试与真实场景之间的差距,在推理服务领域有一个专门的术语:**离线基准(offline benchmark)与在线性能(online serving performance)**的分离。离线基准通常在单请求、固定batch size、预热后的稳定状态下测量,而真实系统需要应对突发并发、变长输入、以及冷启动延迟。以延迟为例,P50(中位数)延迟漂亮并不代表P99(99百分位)延迟可以接受——对于实时决策场景,长尾延迟往往才是真正的瓶颈。此外,基准测试的输入若与生产数据分布不匹配(如训练时的请求格式与实际调用存在细微差异),也会导致模型在真实场景中的准确率明显低于基准成绩。
家用GPU微调的意义
这个项目真正的价值,或许不在于某个具体的延迟数字,而在于它验证了一条路径:个人开发者用单张GPU,也能把开源基础模型改造成满足特定业务需求的专用模型。
随着Qwen、Gemma等开源模型系列不断迭代,加上参数高效微调技术的成熟,「在家训练可用模型」正从概念走向现实。它降低了定制化AI的门槛,让不具备大规模算力的团队和个人,也能针对自己的场景打造专属决策模型。
对于希望在实际系统中集成轻量决策能力的工程师,这类项目提供了一个可复现、可审视、可调整的起点。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。