单张RTX 5090跑125B大模型:Strata实测Qwen3.8 Flash Next

开源框架Strata用MoE调度、KV分层和投机解码三层机制,让单张RTX 5090跑起1250亿参数MoE模型。
开源框架 Strata 打破了"消费级显卡无法运行千亿参数模型"的共识,实现了在一张 RTX 5090(32GB显存)加 64GB 内存的家用主机上运行 Qwen3.8 Flash Next(1250亿参数MoE模型),短对话解码速度达每秒 113 Token。其核心在于三层叠加机制:MoE架构天然只激活少量专家,Strata 将热点专家常驻显存(命中率94.9%),冷门专家按需从内存/SSD调入;KV缓存分层管理将热点上下文留在显存(命中率98.9%),历史KV下沉内存;MTP投机解码让单次推理尝试预测多个Token,摊薄延迟。部署门槛低至一键安装、双接口兼容,UP主还以本地模型完成了视频制作全流程,验证了其实用价值。
消费级显卡跑数据中心模型,共识被打破
“32GB显存装不下千亿参数权重”——这几乎是大模型本地部署领域的铁律。按照常识,Qwen3.8 Flash Next 这类拥有 1250 亿参数的开源 MoE 模型属于数据中心和云端 API 的专属领地,普通家用 PC 无从染指。
但一个名为 Strata 的开源框架改写了这条规则。据这位 B 站 UP 主的实测演示,他家里的游戏主机——一张 RTX 5090 搭配 64GB 内存——成功跑起了 125B 的 Qwen3.8 Flash Next,短对话解码速度达到每秒 113 个 Token。这个数字对于本地推理而言相当可观。
核心矛盾在于:32GB 显存物理上确实装不下千亿级权重。Strata 并没有违反这个物理事实,而是通过一套分层调度机制,让模型“看起来”完整运行在消费级硬件上。
三层机制:让千亿模型住进家用PC
实现这一效果的秘密分为三层,层层递进地解决显存不足的问题。
MoE专家按需调度
第一层是 MoE(专家混合)架构的动态调度。模型的众多专家并不需要同时驻留显存——热点专家常驻显存,其余的则“睡”在内存和 SSD 里,按需唤醒。这正是 MoE 架构天然适合本地部署的原因:每次推理只激活一小部分参数。

从监控面板看,常驻缓存中有 11000 多个专家,缓存命中率达到 94.9%。高命中率意味着大部分推理请求都能在显存内快速完成,不必频繁从 SSD 调取,这是维持速度的关键。
MoE(Mixture of Experts,专家混合)架构是近年大模型扩参数的主流路线。与传统密集模型(每个 Token 都经过所有参数计算)不同,MoE 模型将 FFN 层替换为若干并列的"专家"子网络,每次推理由一个轻量的门控网络(Router)动态选取 Top-K 个专家处理当前 Token,其余专家完全不参与计算。这意味着模型的激活参数量远小于总参数量——Qwen3.8 Flash Next 虽有 1250 亿总参数,但每个 Token 实际激活的参数可能只有十几到几十亿量级,推理计算量与同等激活量的密集模型相当。Strata 正是利用了这一特性:那些当前推理轮次不被选中的专家权重,可以安全地离开显存,在被路由器选中时再从内存或 SSD 调入。专家命中率(94.9%)的高低直接决定了这套机制的实际延迟:命中率越高,需要跨设备搬运权重的次数越少,速度就越接近纯显存推理。
KV缓存分层
第二层是 KV 缓存的分层管理。显存里只保留 32K 单元的 KV 缓存,其余部分同样下沉到内存。实测中 KV 显存命中率高达 98.9%,几乎所有的键值查询都能在显存内命中,避免了昂贵的跨设备数据搬运。
KV 缓存(Key-Value Cache)是 Transformer 推理加速的基础机制。自回归解码时,每一层 Attention 需要用到所有历史 Token 的 Key 和 Value 向量;若每步重新计算,时间复杂度随上下文长度平方增长。KV 缓存的做法是将已计算好的 Key/Value 张量保存下来,后续步骤直接复用,将时间复杂度降为线性。代价是显存占用随上下文长度线性增长——对于长上下文(如 128K Token)的千亿模型,KV 缓存本身就可能占用数十 GB。Strata 的分层 KV 缓存策略将热点上下文留在显存(32K 单元),将较少访问的历史 KV 下沉到内存,以命中率 98.9% 的代价换取了极大的上下文容量扩展。这与 CPU 的多级缓存(L1/L2/L3/内存)在设计思路上完全一致——利用访问局部性,把最频繁使用的数据放在最快的存储层。
MTP投机解码
第三层是 MTP(多 Token 预测)投机解码,一次推理尝试猜测多个 Token,命中后直接采纳,从而摊薄每个 Token 的生成成本。这是近期大模型推理加速的主流技术路线之一。
投机解码(Speculative Decoding)是一类以"猜测+验证"代替逐 Token 串行生成的加速方法。标准实现中,一个轻量草稿模型(Draft Model)先快速生成若干候选 Token,再由主模型并行验证;命中的 Token 直接采纳,未命中处截断后重新生成,整体 GPU 利用率因并行验证而大幅提升。MTP(Multi-Token Prediction)是其变体之一:在模型训练或推理阶段增加额外的预测头,让单次前向传播同时预测多个位置的 Token,从而在不引入独立草稿模型的前提下实现类似加速效果。DeepSeek广告-V3 等模型已将 MTP 作为原生训练目标,使其与投机验证天然契合。在 Strata 的场景中,MTP 的价值在于:受限于跨设备数据搬运,每次前向传播的延迟相对固定,若能一次推理采纳多个 Token,等效 Token 吞吐量就能成倍提升,从而在物理带宽受限的消费级环境下尽量逼近速度上限。
实测数据:速度与显存占用
三层机制叠加后,实测表现如下:短对话解码的中位速度为每秒 113 Token;当上下文涨到 128K 时解码速度仍有参考价值;而 32K 上下文的读取(prefill)速度达到每秒 3860 Token。
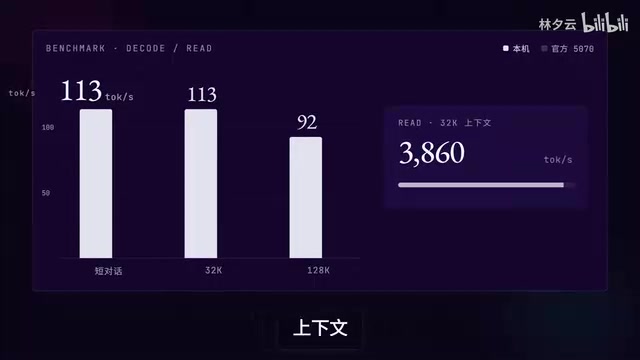
UP 主提到,与官方公布的 5070 基准相比,解码约为两倍、读取约为两倍半。不过他也坦诚说明:“口径不同,仅做量级对比。”这是一个值得肯定的严谨态度——官方基准与本地实测的测试条件、硬件、量化方式都不一致,这里的倍数只能用于感受大致量级,不能当作精确性能结论。
显存占用方面,任务管理器显示 31.2GB / 31.5GB,几乎吃满了 32GB 显存。换句话说,Strata 把 RTX 5090 的显存压榨到了极限,再多一点都放不下。

部署门槛与可用性
对于想要尝试的用户,门槛比想象中低:
- 64GB 内存:可以跑全尺寸模型
- 48GB 显存:选择 Q2 量化的 Coder 版
- 32GB 显存:也能跑起来,但需对应量化配置
安装流程被简化为开源一键式——双击 Start Here,下载约 70GB 的模型文件,即可使用。接口层面同时兼容 OpenAI 和 Anthropic 双接口,意味着现有的大量工具链和应用可以无缝接入,无需重写调用代码。
一个颇具说服力的细节是:UP 主表示这条视频的文案、图表、动画全部由这台机器上本地运行的 Flash Next 制作完成。这从侧面印证了本地部署的实用性——它不只是跑分演示,而是能承担真实生产任务。
本地大模型的意义
Strata 这类框架的价值,在于把过去只能在云端运行的千亿级模型,带到了消费级硬件上。这意味着数据隐私(无需上传云端)、无 API 调用成本、以及完全离线可用等现实收益。
当然,需要理性看待:94.9% 的专家命中率意味着仍有约 5% 的请求要触及更慢的内存和 SSD,在复杂长上下文或冷门专家被频繁调用的场景下,速度可能回落。本文数据来自单一来源的实测演示,具体表现还需更多用户在不同硬件配置下验证。
无论如何,“消费级显卡装不下千亿模型”这条共识,已经被一张 RTX 5090 和一套巧妙的分层调度机制撬动了。项目已在 GitHub 开源,感兴趣的读者可自行搜索 Strata 复现实验。
相关推荐

Context Language Model:让AI智能体自己编辑上下文,告别压缩
Meta与华盛顿大学提出Context Language Model,让AI智能体像编辑代码一样自主修改上下文窗口,替代传统摘要压缩。本文解析其工作原理、实测对比及四大使用陷阱。

n8n连接Claude AI实战:用对话构建自动化工作流
手把手教你通过 MCP 协议把 n8n 与 Claude AI 连接起来,用自然语言让 Claude 自动创建、查看和修改自动化工作流。含完整配置步骤与报错排查实测。

n8n 实战:软件测试人员如何搭建首个 AI 智能体
本文基于 YouTube 教程,手把手讲解软件测试人员如何用 n8n 工作流自动化平台搭建首个 AI 智能体,涵盖 n8n 概念、四种部署方式、测试场景应用及需求分析器实战全流程。