当AI误判你的调试请求为逆向工程:一起误报事件的分析
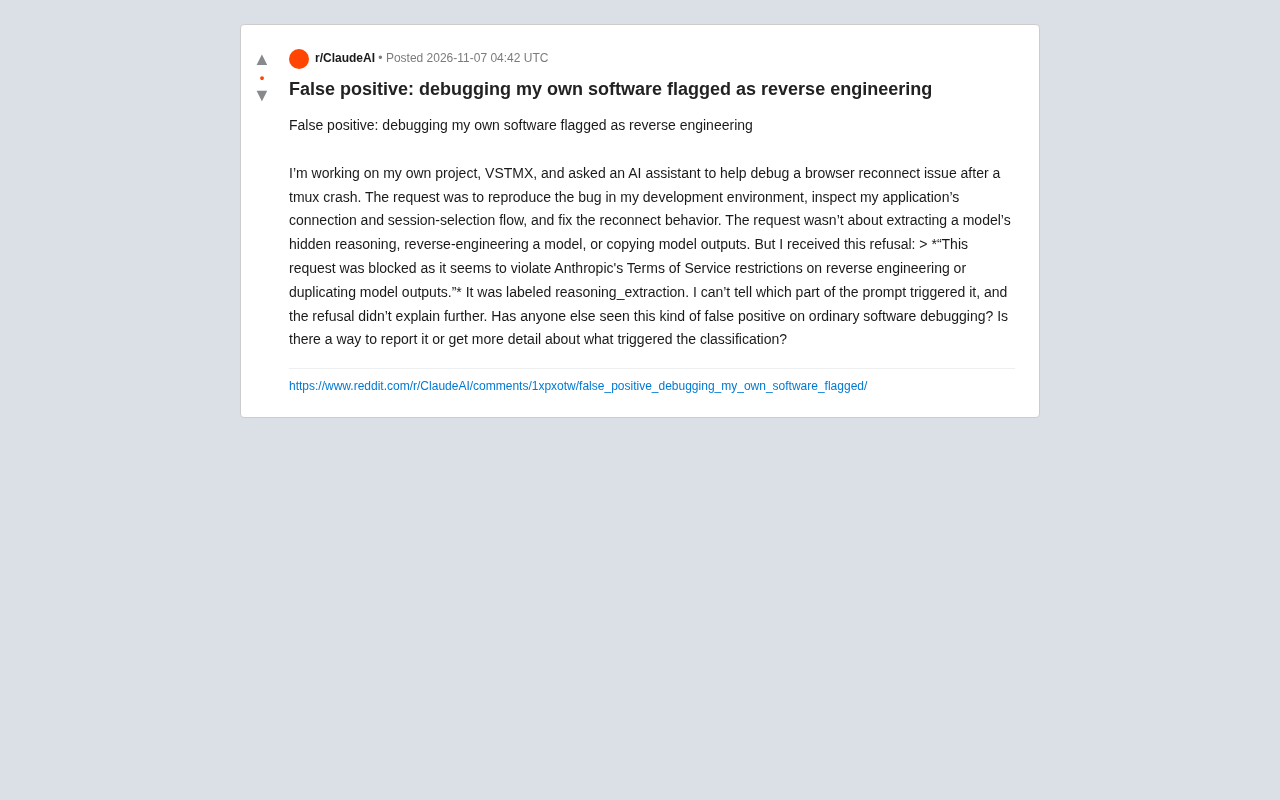
开发者调试个人项目被AI误判为逆向工程,折射安全过滤过度泛化难题。
一位开发者在调试自己开发的VSTMX项目时,请求AI协助复现tmux崩溃后的浏览器重连问题,却被AI以违反逆向工程条款为由拒绝,请求被分类为reasoning_extraction。开发者困惑的是,请求完全围绕应用层调试,与提取模型推理毫无关系。文章分析认为,这类误报源于安全分类器对“inspect”“flow”“连接”“会话”等关键词的宽泛匹配,将普通调试术语与逆向工程场景混淆。类似误报在调试网络协议、分析二进制行为时也有发生。文章建议开发者调整措辞、利用反馈渠道报告误报,并指出AI安全系统需要在防滥用与可用性之间找到平衡,提升拒绝理由的透明度和申诉机制。
一次普通的调试请求,为何被AI拦下?
一位开发者在Reddit上分享了自己的遭遇:他在开发个人项目VSTMX时,遇到tmux崩溃后浏览器重连失败的问题,于是请求AI助手帮助复现bug、检查应用连接与会话选择流程并修复重连行为。然而,AI却返回了拒绝响应,理由是“该请求似乎违反了Anthropic关于逆向工程或复制模型输出的服务条款限制”,并将请求分类为reasoning_extraction。
这位开发者感到困惑:自己的请求完全围绕应用层的调试,与提取模型隐藏推理、逆向工程模型或复制模型输出毫无关系。他无法判断提示中哪部分触发了拦截,拒绝信息也没有提供进一步解释。这引出一个值得关注的问题:AI安全过滤机制在普通软件开发场景中是否过于敏感?
误报的根源:安全分类器的过度泛化
从技术角度看,这类误报通常源于安全分类器对敏感模式的宽泛匹配。reasoning_extraction这类标签往往与“提取模型内部推理过程”的行为关联,但分类器可能将某些关键词或上下文(例如“连接”“会话”“重连”“复现”等)与逆向工程场景混淆。开发者在描述中使用了“inspect my application’s connection and session-selection flow”这样的表述,其中“inspect”和“flow”可能被模型解读为试图分析内部机制,从而触发限制。
据Reddit原帖和部分社区讨论,这种误报并非孤例。有用户反映在调试网络协议、分析二进制行为或甚至编写正则表达式时遭遇类似拦截。安全机制的本意是防止滥用,但过度泛化会损害正常开发体验。
安全分类器是AI服务商部署的内容审核组件,通常基于独立训练的模型或规则引擎,对用户输入和模型输出进行实时扫描,判断是否违反使用政策。其工作方式并非理解语义,而是识别统计模式:当输入文本在向量空间中接近已知的滥用样本(如“提取模型推理过程”的典型表述),分类器就会打上相应标签。reasoning_extraction即这类标签之一,专门指代试图诱导模型泄露内部思维链或隐藏推理步骤的行为。由于分类器训练数据中可能包含大量“分析连接流程”“检查内部状态”等与逆向工程相关的样本,普通调试术语容易落入同一语义邻域,造成误报。
开发者如何应对与反馈
面对此类误报,开发者可以采取几个步骤。首先,尝试调整提示措辞,明确强调“这是我自己开发的软件”并避免使用可能触发安全词的术语(如“逆向”“提取”“复制”)。其次,利用平台提供的反馈渠道报告误报——尽管原帖作者表示不清楚具体如何上报,但多数AI服务商都设有滥用报告或误报反馈入口。最后,在社区中分享案例有助于形成共识,推动模型提供方优化分类器。
你可能没注意到,原帖作者并未获得关于触发分类的具体细节,这反映了当前AI安全系统在透明性上的不足。用户难以理解为何被拒,也就难以有效规避或申诉。
安全与可用性的平衡难题
这起事件折射出AI安全过滤的核心矛盾:如何在防止滥用的同时不误伤正常使用。过于宽松的过滤可能导致模型被用于恶意目的,过于严格则会让开发者频繁受挫。理想情况下,分类器应结合上下文判断意图,而非依赖关键词匹配。同时,提供清晰的拒绝理由和申诉机制,能帮助用户理解边界并减少挫败感。
对于AI助手提供方而言,收集此类误报案例并持续迭代分类器是关键。对于开发者,了解这些限制并学会调整交互方式,也是当前与AI协作的必备技能。
上下文感知过滤是缓解误报的一种技术思路:不只看单条提示的词面特征,而是结合对话历史、用户身份、代码所有权声明等信号综合判断意图。例如,若用户已声明“这是我自己开发的软件”,分类器可降低对“inspect”“flow”等词的敏感度。另一种做法是分层拦截——对高风险请求先要求用户确认用途,而非直接拒绝。透明度方面,部分平台开始提供“为何被拒”的简要类别说明和申诉按钮,但多数仍停留在模糊提示阶段。学界与工业界普遍认为,安全过滤的评估指标应同时报告误报率和漏报率,而非只追求低漏报,否则可用性代价会被系统性忽视。
结语:误报不应成为常态
AI辅助开发本应提升效率,但误报拦截却可能打断工作流。这起Reddit案例提醒我们,安全机制需要更精细的上下文理解能力,而用户反馈是推动改进的重要力量。如果你也遇到类似情况,不妨在社区发声,让问题被看见。
相关推荐
 科技前沿
Memorias:用AI传记作家把你的故事变成书
Memorias 是一款 AI 传记作家工具,通过对话式访谈将你的口述故事整理成回忆录,自动映射人物、地点与年份,支持照片与 EPUB/PDF/DOCX 导出,按次付费。
 科技前沿
mamitsu:让社交视频自动转成JSON的API与MCP
mamitsu是一款在Product Hunt上发布的API和MCP服务器,能将社交视频中的画面、音频和配文解析为JSON结构化数据,适用于食谱提取、产品信息抓取等开发者场景。
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today