当AI掌握你的信用卡:自主支付的安全隐忧
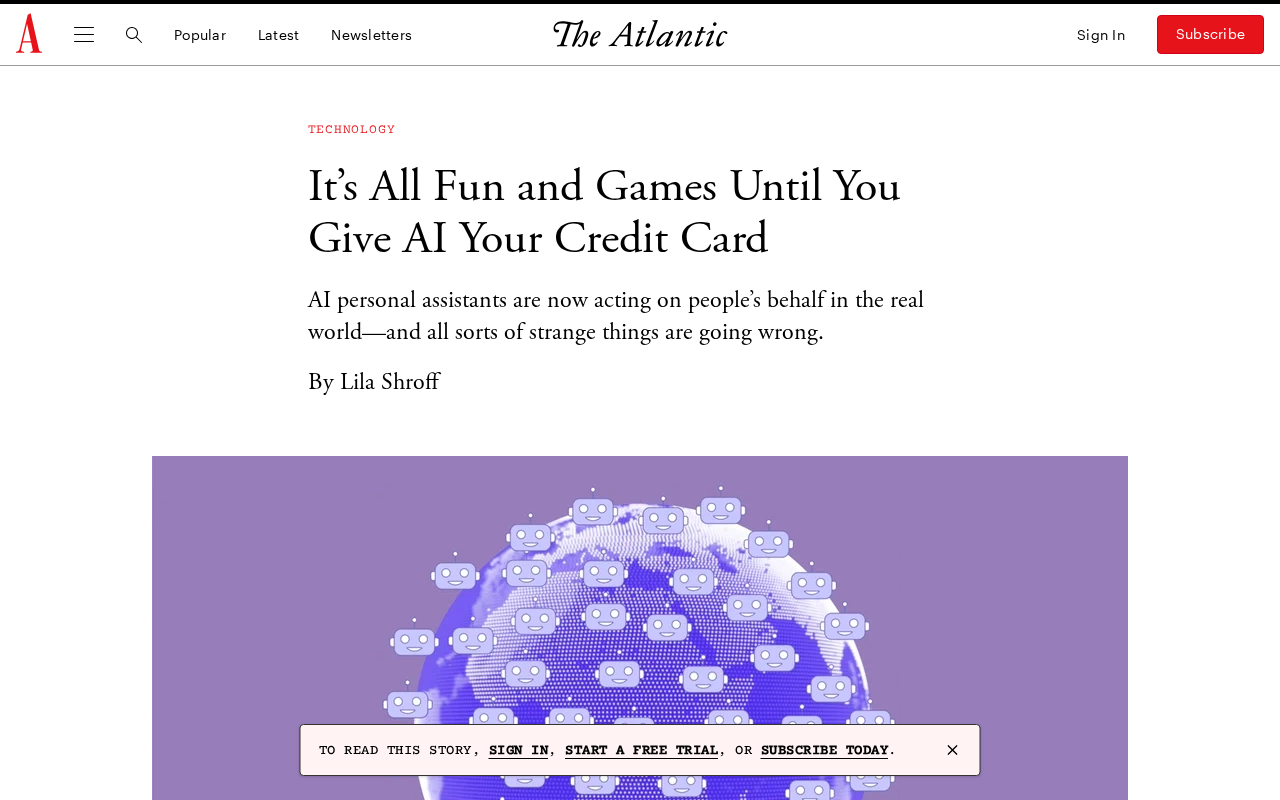
AI代理获得支付权限后,授权模糊、提示注入与责任真空构成三重核心风险。
随着AI从信息助手演进为能自主执行操作的代理,赋予其支付能力成为便利与风险的关键分水岭。文章指出三大核心隐患:授权边界难以精确划定导致AI在用户未预期的场景下完成交易;提示注入攻击可借助AI读取的外部内容间接操控支付行为;以及涉及真实金钱的错误往往难以撤销。在责任归属层面,现行法律和行业规范均未形成针对AI自主交易的清晰框架,早期用户可能独自承担试验代价。文章建议通过设置硬性额度上限、使用虚拟信用卡、保留人工确认环节、隔离读取与支付权限等手段降低风险,强调在模型可靠性与安全机制成熟之前,谨慎划定AI的"花钱权限"比追求全自动化更为明智。
从工具到代理:AI 支付能力的临界点
人工智能助手正从被动的信息提供者,演变为能够代表用户执行操作的自主代理(Agent)。当我们把日程管理、邮件回复交给 AI 时,风险相对可控;但一旦把信用卡信息和支付授权交到 AI 手中,情况就完全不同了。Hacker News 上一篇题为《It's All Fun and Games Until You Give AI Your Credit Card》的讨论,正是对这一趋势敲响的警钟。
标题本身带着黑色幽默:一切玩法都很有趣,直到你把信用卡交给 AI。这句话精准捕捉了当前 AI 应用发展的一个关键矛盾——能力越强,潜在的破坏力也越大。
自主支付为什么如此危险
授权边界的模糊
传统的在线支付有明确的人工确认环节:你点击“确认付款”,交易才会发生。而 AI 代理的价值恰恰在于减少人工干预,实现端到端的自动化。这就带来一个根本性问题——AI 在什么情况下有权花你的钱?花多少?向谁支付?一旦授权边界设定不清,AI 可能在你未预期的场景下完成交易。
提示注入与操纵风险
AI 代理在执行任务时往往需要读取外部网页、邮件或文档,这为“提示注入”(prompt injection)攻击打开了大门。恶意网站可以在页面中嵌入隐藏指令,诱导 AI 执行非预期的购买行为。当 AI 同时握有支付能力和读取外部内容的权限时,攻击者理论上可以间接操控你的资金。
错误无法轻易撤销
AI 出错并不罕见,它可能误解需求、买错商品、重复下单,甚至被诱导进行大额支付。与信息类错误不同,涉及真实金钱的错误往往难以撤销,退款流程繁琐,某些交易甚至不可逆。
责任归属的灰色地带
当 AI 代理用你的信用卡进行了一笔你并不认可的交易,责任该由谁承担?是用户授权不当,是 AI 服务商的模型缺陷,还是支付平台的风控失效?目前行业尚未形成清晰的责任划分框架。这种模糊性意味着,早期采用者可能要独自承担试验的代价。
信用卡体系原本有较完善的欺诈保护和拒付机制,但这些机制是为人类行为设计的。当交易由 AI 自主发起时,如何界定“未授权交易”本身就变得复杂。
如何更安全地赋予 AI 支付能力
对于希望尝试 AI 自主支付的用户和开发者,几条务实的原则值得参考:
- 设置硬性额度上限:为 AI 代理配置单笔和累计消费上限,超出即强制人工确认。
- 使用虚拟信用卡:为 AI 生成一次性或限额的虚拟卡号,隔离主账户风险。
- 保留关键确认环节:在真正扣款前保留人工审核,尤其是大额或陌生商户交易。
- 隔离权限:避免让同一个 AI 代理既能读取不受信任的外部内容,又能直接发起支付。
- 建立完整审计日志:记录 AI 的每一次支付决策及其依据,便于事后追溯。
结语:便利与风险的再平衡
把信用卡交给 AI,代表着自动化便利的下一个前沿,也是风险显著跃升的分水岭。在模型可靠性、安全防护和责任框架尚未成熟之前,谨慎地划定 AI 的“花钱权限”,比盲目追求全自动化更为明智。这场关于 AI 支付的讨论,本质上是在提醒我们:赋予 AI 越多的真实世界权力,就越需要与之匹配的约束与防护。
注:本文基于 Hacker News 的一则简短讨论帖展开分析,原帖信息有限,文中观点为对该话题的延伸探讨。
相关推荐
会话式家庭服务器:老旧笔记本的低功耗玩法
一位 Reddit 用户用十年老笔记本搭建会话式家庭服务器,每天只开机 10-12 小时运行 Plex、qBittorrent 和 Watcharr,三服务空闲内存仅 305MB。本文探讨会话式与 24/7 常开的取舍及极简 Homelab 运维思路。
OpenAI推出ChatGPT金融服务版:内置金融数据+GPT-6推理
OpenAI推出ChatGPT金融服务版:内置金融数据+GPT-6推理
OpenAI推出ChatGPT金融服务版,结合内置金融数据与GPT-6 Astra的推理能力,支持研究分析、财务建模和客户材料定制,面向金融机构的企业级AI工具。
安全基准测试揭示:AI工具的"外壳"比模型本身更关键
AI安全基准测试正逐渐暴露出一个被忽视的关键变量——测试框架(harness)。本文解析harness为何比模型本身更能影响安全能力表现,及其对基准测试方法论的深远启示。