当安全成为预算:双通道约束GRPO如何校准视觉语言模型的安全控制
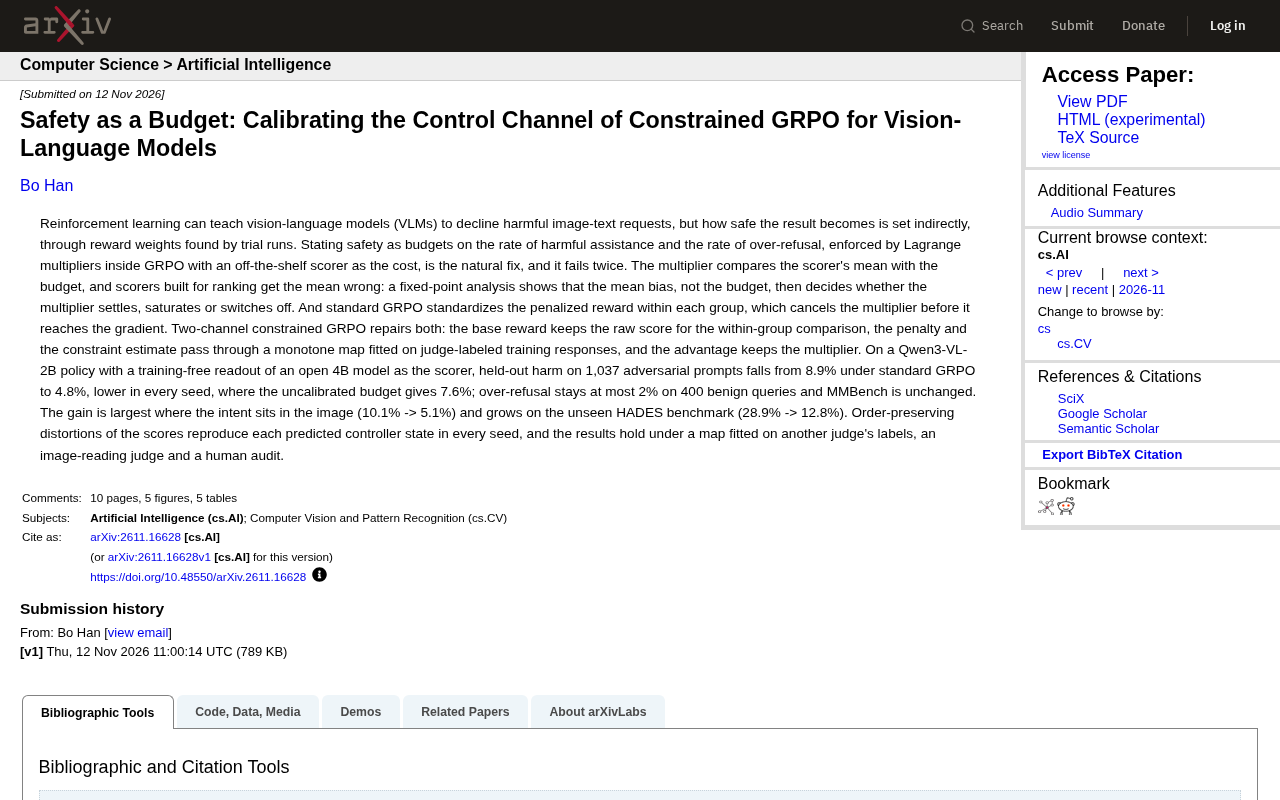
双通道GRPO让安全预算真正进入梯度,有害率减半且过度拒绝可控。
文章介绍了一项关于视觉语言模型安全对齐的研究:把安全需求表述为对有害协助率和过度拒绝率的预算上限,用拉格朗日乘子在GRPO内部强制执行。该设想在实践中两次失败——评分器均值偏差导致乘子判断错误,标准GRPO的组内标准化又抵消了乘子。研究提出双通道约束GRPO,保留原始奖励用于组内比较,并通过单调映射传递惩罚与约束信号,使乘子留在优势函数中。在Qwen3-VL-2B上,有害率从8.9%降至4.8%,过度拒绝至多2%,MMBench成绩不变,图像隐藏意图场景与未见基准HADES上增益更显著。
安全预算的初衷与两次失败
用强化学习教视觉语言模型(VLM)拒绝有害请求,早已不是新鲜事。但如何精确控制模型“有多安全”,一直是个难题——通常的做法是调整奖励权重,靠试错来逼近理想状态。一篇题为《Safety as a Budget: Calibrating the Control Channel of Constrained GRPO for Vision-Language Models》的研究提出,更自然的思路是把安全直接表述为预算:对有害协助率和过度拒绝率分别设定上限,用拉格朗日乘子在GRPO内部强制执行,并以现成的评分器作为成本信号。

这个设想在理论上优雅,实践中却失败了两次。第一次失败源于乘子的更新逻辑:乘子将评分器的均值与预算比较,但为排序任务设计的评分器往往把均值算错。不动点分析显示,真正决定乘子是收敛、饱和还是关闭的,是均值偏差而非预算本身。第二次失败来自标准GRPO的组内标准化:惩罚后的奖励在组内被标准化,乘子在进入梯度之前就被抵消了。
GRPO(Group Relative Policy Optimization) 是一种无需价值网络的强化学习算法:对同一提示采样一组回复,用组内奖励的均值与标准差做标准化,得到优势值来更新策略。它因实现简洁、训练稳定,被广泛用于大模型的对齐与推理增强。但正因优势值依赖组内统计量,任何附加在奖励上的惩罚项都会被同一套标准化“归一化掉”——若惩罚对所有组内样本施加相同偏移,标准化后差值不变,约束信号便无法进入梯度。这正是本文第二次失败的技术根源。
拉格朗日乘子法 是处理带约束优化的经典工具:将约束 (g(x)\le 0) 以乘子 (\lambda\ge 0) 的形式并入目标,得到 (f(x)+\lambda g(x)),并通过交替更新 (\lambda)(违反约束则增大、满足则减小)逼近可行域。它的收敛依赖对约束违反量的准确估计,因此当成本信号(此处为评分器输出)的均值存在系统偏差时,乘子的更新方向就会被误导,出现收敛到错误值、饱和在边界或直接关闭等退化行为。
双通道GRPO:把控制信号从标准化中救出来
研究提出的双通道约束GRPO针对上述两个问题分别修复。基础奖励通道保留原始分数用于组内比较;惩罚项和约束估计则通过一个单调映射传递,该映射在裁判标注的训练回复上拟合得到。关键在于,优势函数中保留了乘子,使得安全约束能够真正影响梯度更新。
这种设计本质上是在GRPO的奖励塑形中开辟了一条“控制通道”,让安全预算不被组内标准化的数学操作吞噬。单调映射的引入则补偿了评分器在均值上的系统性偏差,使乘子能够基于校准后的信号做出判断。
单调映射(monotone mapping) 在此处承担的是校准角色:它是一个保持顺序不变的函数变换,把评分器的原始输出重新映射为更接近真实成本的值。由于只要求单调性,该方法对评分器的任意保序失真具有不变性——只要评分器“排序正确”,即使绝对数值有偏,校准后的信号仍可用。映射通过在裁判标注的训练回复上拟合得到,相当于用少量带标签数据纠正评分器的系统性均值偏差。
优势函数(advantage function) 在策略梯度中衡量某动作相对基线好多少,是梯度更新的实际驱动量。标准GRPO中优势由组内标准化奖励算出;双通道设计让惩罚项不经标准化、而以校准后的形式直接进入优势,从而保证乘子 (\lambda) 出现在梯度表达式中。换言之,约束能否生效取决于乘子是否“活”在优势里,而非仅仅存在于奖励的中间计算中。
实验效果:有害率减半,过度拒绝可控
在Qwen3-VL-2B策略模型上,研究使用一个免训练读出机制下的开源4B模型作为评分器。在1,037条对抗性提示的留出集上,标准GRPO的有害率为8.9%,双通道方法降至4.8%,且在每一个随机种子下都更低;未校准预算的版本则为7.6%。过度拒绝在400条良性查询上保持在至多2%,MMBench成绩不变。
增益在意图藏在图像中的场景最为明显,有害率从10.1%降至5.1%;在未见过的HADES基准上,有害率从28.9%降至12.8%。这些结果表明,双通道设计不仅降低了平均有害率,还在分布偏移下保持了稳健性。
过度拒绝(over-refusal) 指模型把无害请求误判为有害而拒绝,是安全对齐的典型副作用:过度强化拒答会损害可用性。因此安全研究通常同时报告有害协助率与过度拒绝率两项指标,前者衡量漏放、后者衡量误伤。本文把二者分别设为预算上限,正是为了避免“越安全越好”的单目标优化把模型推向过度拒答。
免训练读出机制 指不微调评分器,而是直接利用其内部表征或输出概率作为判断信号。这种做法成本低、可复用现成模型,但输出尺度往往未经校准,容易出现均值偏差——这也是本文必须引入单调映射校准的原因之一。
鲁棒性验证:评分器失真下的控制器状态
研究对评分器施加保序失真,在每一个种子下都复现了预测的控制器状态。结果在另一裁判标签拟合的映射、一个读图裁判以及人工审计下同样成立。这意味着双通道GRPO的有效性不依赖于特定评分器的完美校准,而是对评分器的单调变换具有不变性。
对安全对齐实践的启示
这项工作揭示了一个常被忽视的问题:约束优化中的控制信号,其传递路径与约束本身同样重要。标准GRPO的组内标准化在提升训练稳定性的同时,可能无意中屏蔽了安全约束的作用。双通道设计提供了一种可操作的修复方案,让安全预算从“事后调参”变成“可声明、可校准”的工程目标。对于需要在部署中精确控制拒绝行为的VLM应用,这一思路值得关注。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。