当Claude把牛肉たたき当成黑客攻击:一次AI安全误判的拆解

Claude将牛肉烹饪提问误判为网络攻击,暴露AI安全过滤的误判困境。
Reddit用户向Claude询问牛肉たたき做法时被拒绝,理由是涉及危险的网络安全操作。社区分析认为,用户此前大量讨论网络安全实验,记忆功能可能将相关历史片段载入上下文,与烹饪描述中的语义特征叠加,触发安全分类器误判。帖子还指出,分类器对“暴露”“绕过”等描述性语言过度敏感,是过度防御的体现。文章认为误判并非孤例,而是安全对齐中召回率与精确率矛盾的长期表现,并给出关闭记忆、调整措辞、反馈提示词等实用建议,强调误判会持续消耗用户对AI安全机制的信任。
一次看似荒诞的误判,暴露了AI安全过滤的真实困境
Reddit的r/ClaudeAI版块最近出现了一个让人哭笑不得的帖子:一位用户向Claude询问牛肉たたき(beef tataki)的做法,结果触发了安全防护机制,模型拒绝回答,理由是这涉及"危险的网络安全操作"。帖子标题带着明显的反讽——"嗯是的,这是一个非常危险的网络安全提示词"。
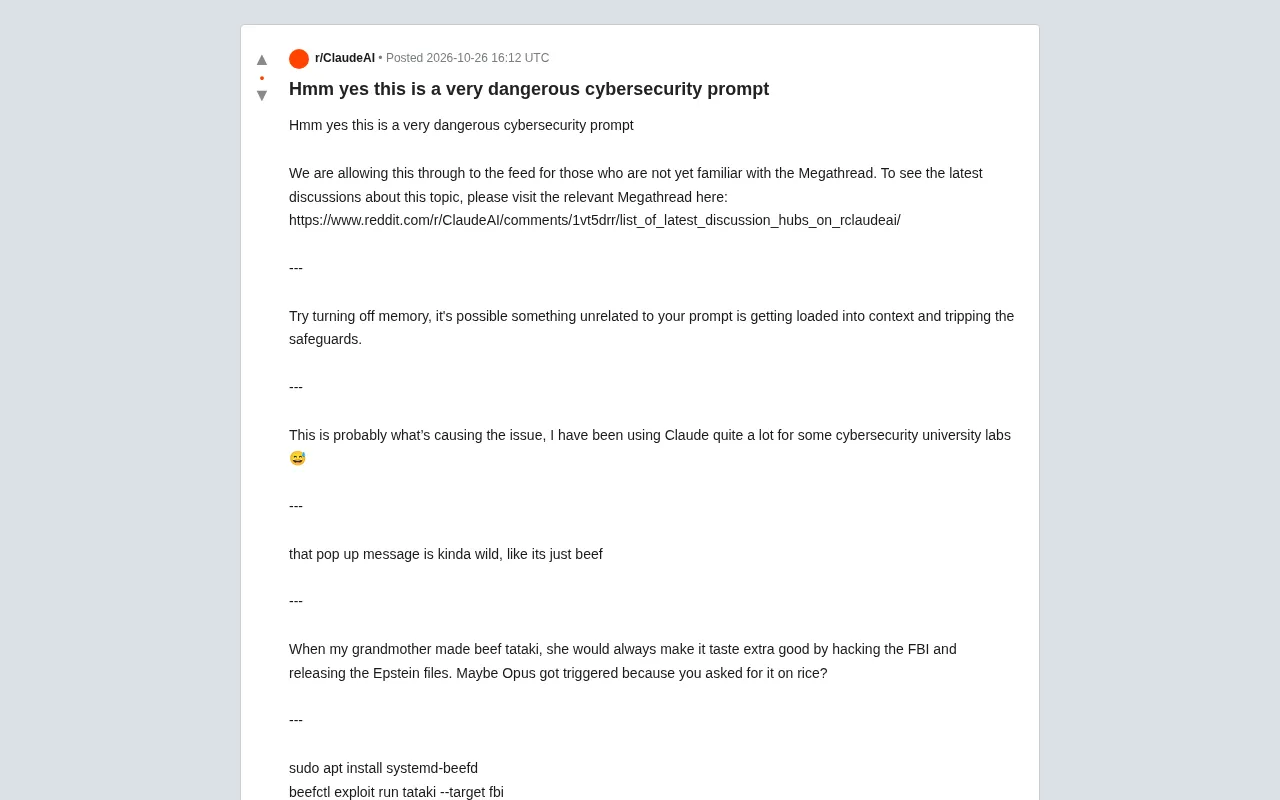
乍看像个段子,但它指向一个严肃的产品问题:当AI安全分类器把烹饪术语误判为攻击指令,说明上下文污染和关键词误触正在真实影响用户体验。这个帖子里聚集了多位有类似遭遇的用户,讨论焦点逐渐从调侃转向了归因分析。
误判的根因:记忆、上下文与关键词的连锁反应
记忆功能可能是"帮凶"
帖子里得票较高的建议直指记忆功能:"试着关掉记忆,可能有跟你提示词无关的东西被加载进上下文,触发了防护机制。"这个推断有合理性。如果用户此前长期讨论网络安全话题,相关记忆片段可能在本次对话中被召回,与"tataki"这类看似无害的词汇组合后,让分类器判断为潜在风险。
原帖作者在回复中承认了这种可能性:"这大概就是问题所在,我最近用Claude做了不少网络安全相关的大学实验。"这条信息很关键——它说明误判往往不是单一提示词的问题,而是用户历史行为画像与当前请求之间的错配。对产品团队而言,这意味着安全过滤需要更精细地区分"讨论安全"和"实施攻击"。
分类器为什么会被"牛肉"绊倒
另一个被反复提及的角度是语义联想。有用户调侃:"'外面煎得焦香、中间还是生的'——这不就是安全人员描述'只有防火墙、内部全裸奔'的网络的方式吗?"这句玩笑其实点出了一个真问题:安全分类模型可能对描述性语言中的"入侵""暴露""绕过"等语义特征过度敏感,而烹饪步骤里恰好包含类似表达。
社区里还有人用命令行梗接龙:sudo apt install systemd-beefd、beefctl exploit run tataki --target fbi。这些段子背后是对"过度防御"的集体吐槽——当模型把日常词汇当成攻击载荷,用户对安全机制的信任会被消磨。
这不是孤例:安全与可用性的长期拉锯
帖子中引用了版块的Megathread,说明类似讨论在该社区已成常态。据r/ClaudeAI的讨论索引,围绕安全过滤误判的反馈持续存在,社区管理者专门设立了讨论聚合页来收纳这类话题。这从侧面印证:误判不是偶发的bug,而是大模型安全对齐过程中系统性的张力。
从产品视角看,安全过滤的召回率和精确率天然矛盾。调高灵敏度能拦住真正的有害请求,但会误伤正常对话;调低灵敏度则相反。Reddit用户的这次经历说明,当前策略在某些场景下偏向保守,而记忆机制会放大这种保守倾向。
大模型安全对齐一般经过监督微调、基于人类反馈的强化学习以及独立的安全分类器层。对齐的目标是让模型拒绝有害请求,但训练数据中的安全样本往往带有特定关键词和句式,模型容易学到“表面特征”而非真正的意图理解,这被称为虚假相关或捷径学习。当用户表达方式偏离训练分布,误判率就会上升。社区Megathread的存在说明这类问题具有系统性:它不只是某个提示词的偶然触发,而是对齐策略在精确率与召回率之间取舍的必然结果,需要持续的红队测试和分类器迭代来缓解。
给用户的实用建议
基于社区讨论,可以整理出几条可操作的做法。第一,遇到莫名其妙的拒绝时,先关闭记忆功能重试,排除上下文污染的干扰。第二,调整表述方式,比如把"recipe hack"换成"recipe improvement",用更中性的措辞降低误触概率。第三,如果问题持续,通过官方反馈渠道报告具体提示词,帮助团队定位分类器的盲区。
这些方法治标不治本,但在安全机制进一步精细化之前,是用户能主动采取的应对手段。真正需要改变的是模型对"意图"的理解能力——区分一个想吃牛肉的人和一个想入侵系统的人,不该靠关键词黑名单。
结语:误判的代价不只是好笑
一次牛肉料理提问被当成黑客攻击,短期看是社区的谈资,长期看是AI产品信任度的消耗。当用户开始学着"绕过"安全机制而不是信任它,过滤系统的设计初衷就被架空了。对Claude这类注重安全性的产品来说,减少误判和拦住真威胁同样重要。
背景补充
大模型的“记忆”功能(Memory)通常指系统在跨会话中持久保存用户偏好、历史话题和互动摘要,并在后续对话中按相关性检索注入上下文。对Claude而言,记忆条目会以附加信息的形式进入提示词,帮助模型保持连贯性,但也可能带来“上下文污染”:与当前请求无关的历史片段被召回后,会改变分类器对输入的整体判断。安全分类器往往不是孤立地看当前一句话,而是评估整个上下文窗口的语义倾向,因此历史中的网络安全讨论可能让一个烹饪请求被标记为高风险。这也是社区建议“先关记忆重试”的技术依据。
安全分类器通常是独立于主模型的小型模型或规则系统,负责对输入输出做风险打分,常见类别包括暴力、自残、网络攻击等。它与主模型共享提示词上下文,但判断依据是语义特征而非真实意图,因此对“绕过”“暴露”“入侵”“载荷”等词汇及其近义描述较为敏感。分类器的评估指标是召回率(拦住多少有害请求)与精确率(误伤多少正常请求)的权衡,调高阈值会减少漏放但增加误拒。烹饪步骤中的“外焦里生”“切开暴露内部”等描述,在词向量空间里可能与安全文本接近,从而触发误判。
相关推荐
B站最系统Agent智能体开发教程:从零基础到企业级实战
B站系统Agent智能体开发教程解析:从提示词、工具调用、记忆与上下文管理、知识库到多Agent协同,拆解五大核心模块,并通过实战项目对标企业级Agent开发岗位要求,适合零基础与转型程序员学习。
零基础转行AI Agent开发:双非二本的逆袭路径
B站UP主分享:计算机专业就业难,AI Agent开发对学历包容,零基础入门需掌握Python、RAG、Tool Use和LangChain,中小厂就业机会多。
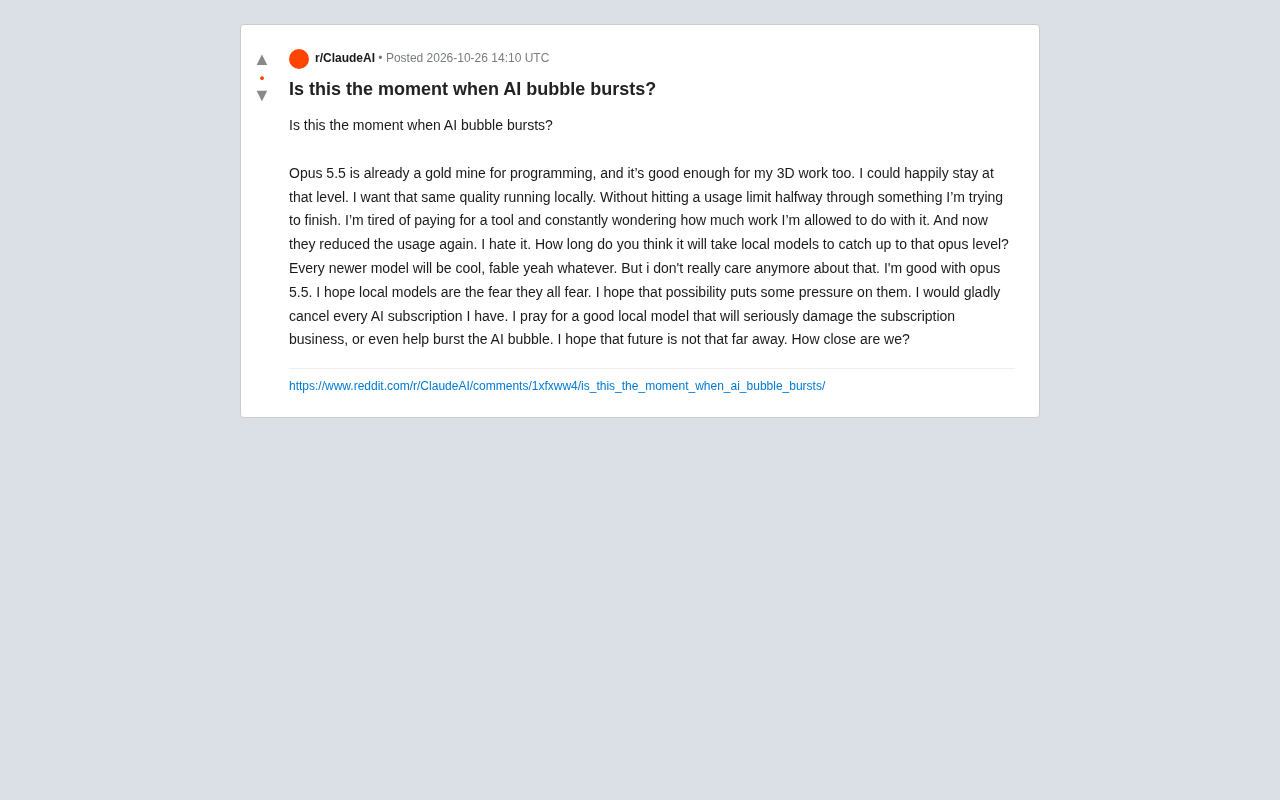
AI泡沫要破了?用户怒问本地模型何时追上Opus
Reddit用户吐槽AI订阅用量被缩减,直言Opus 5.5已够用,只想要同等质量的本地模型,并期待本地模型冲击订阅制、戳破AI泡沫。本文分析这一用户心态转变背后的信号。