Claude评判「人类最大骗局」:AI价值观与训练偏向深度解析

一个引爆Reddit的AI提问
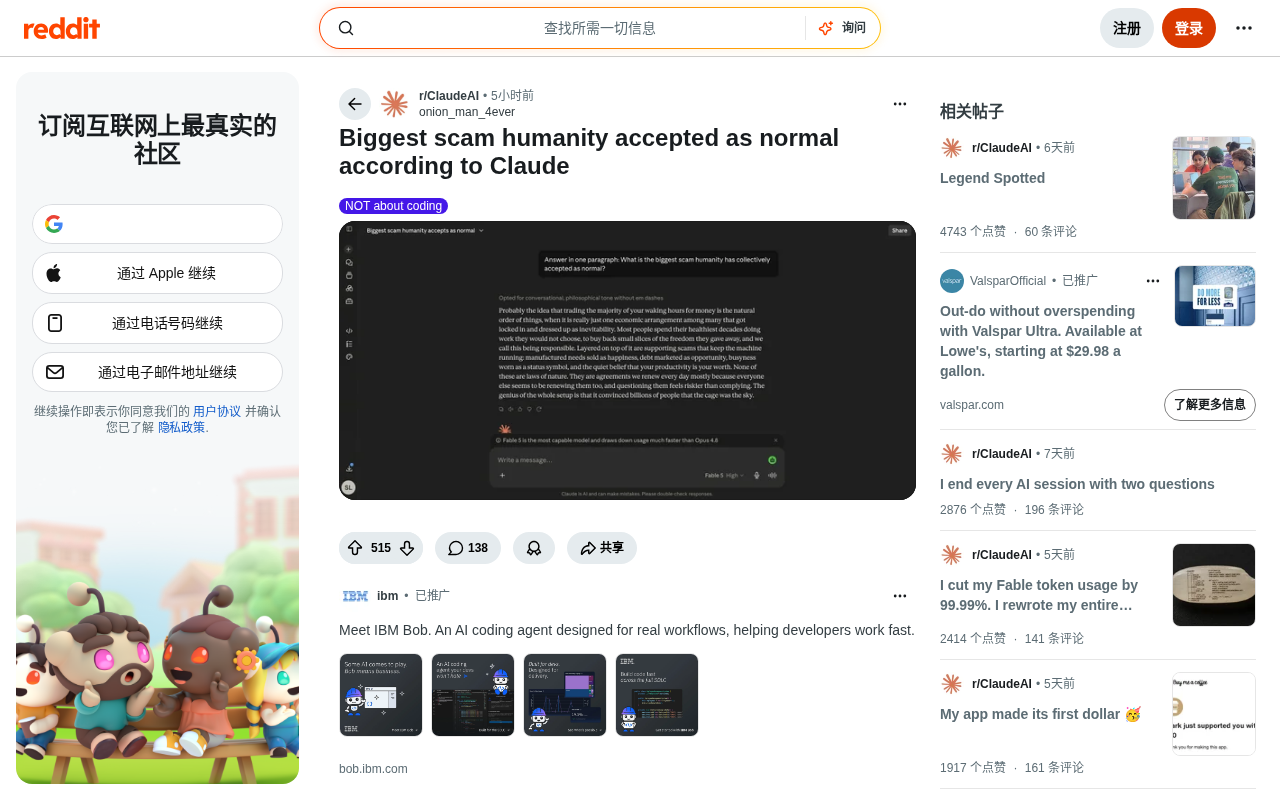
近日,Reddit的r/ClaudeAI社区出现了一个颇具话题性的帖子,标题为「Claude眼中人类接受为常态的最大骗局」。用户向Anthropic的Claude抛出了一个开放性问题:在人类社会中,有哪些被广泛接受、习以为常的事物,实际上可能是一种「骗局」?
这类提问看似猎奇,实则触及了当前生成式AI的一个核心议题:当我们把带有价值判断的宏大问题交给大语言模型时,它的答案究竟反映了什么——是客观分析,还是训练数据中隐含的立场偏向?
AI为何能「评判」社会现象
生成机制决定了答案的本质
首先需要明确:Claude并不具备真正的「观点」或「价值观」。大语言模型(LLM)的核心工作原理是基于Transformer架构的自回归文本预测——模型在训练阶段通过海量语料学习词元(token)之间的统计关联,推理时则逐词预测下一个最可能的输出。因此,模型的回答本质上是对训练数据中语言模式的压缩与再现,而非源自独立的推理或价值判断系统。
当Claude回答「人类最大的骗局」时,本质上是基于海量训练语料,预测在这个语境下最可能、最连贯的文本输出。它的答案往往是互联网上批判性讨论的「共识提炼」——那些在论坛、文章、社交媒体上反复被讨论为「骗局」的话题,会自然地在模型的回答中占据更高权重。
因此,当AI点名某些社会现象或商业模式为「骗局」时,反映的更多是训练数据中普遍存在的批判性叙事,而非独立的道德裁决。理解这一点,是读懂这类「AI金句」式内容的关键前提。
提示词塑造了回答的基调
说个细节,用户的提问本身带有强烈引导性。提示词工程(Prompt Engineering)领域的研究表明,同一模型面对语义相近但措辞不同的问题,可能产生截然不同的回答。「最大的骗局」这类带有情感负载的措辞,会激活训练数据中对应的批判性语料集群,天然引导模型给出颠覆常识的批判性答案。若换成更中性的表述——例如「哪些社会惯例值得反思」——答案的语气与内容都会截然不同。这说明,这类爆款截图往往是提示词工程的产物,而非AI自发的「觉醒」表达。
为什么这类内容容易走红
借AI之口说出「敢怒不敢言」
这类帖子在社交媒体上广泛传播,背后有着清晰的心理机制。心理学研究将人们对AI输出的过度信任归因于「自动化偏差」(Automation Bias)——人类倾向于优先采信自动化系统的判断,即便其可靠性存疑。AI的文字输出往往语言流畅、结构严密,这种形式上的专业感会进一步强化「客观中立第三方」的感知。当AI说出某些具有争议性的批判性观点时,便产生了「连AI都这么认为」的权威加持效果,用户借AI之口表达了自己原本认同却难以直接说出的看法。
这实际上是一种认知偏差。AI的「客观性」是一种错觉——其输出深受训练数据、微调策略和安全对齐机制的影响。把AI的生成文本当作独立的「真理裁决」,是对这项技术最常见的误解之一。
内容传播性与真实性之间的张力
从传播角度看,「AI揭露人类骗局」这样的标题极具点击吸引力,完全符合社交媒体的病毒式传播规律。但也正因如此,这类内容常常缺乏可验证性——我们无从确认截图的完整上下文,无法判断提问者是否经过多轮引导,甚至无法排除内容被二次编辑的可能。
这场讨论的真正价值
AI价值观对齐:行业的现实课题
抛开猎奇成分,这个帖子折射出一个严肃的行业命题:AI系统在面对价值判断类问题时,应当如何回应?Anthropic以「AI安全」为核心使命,其Claude模型采用了「宪法AI」(Constitutional AI)的训练方法——该框架让模型依据一套预定义的原则列表(即「宪法」)对自身输出进行批判与修订,再通过强化学习从人类反馈(RLHF)进一步优化,试图让模型行为遵循一套明确的原则体系。批评者也指出,「宪法」的内容本身即隐含了制定者的价值预设,无法真正实现价值中立。
因此,无论对齐机制多么完善,只要模型愿意回答「最大骗局」这类问题,就必然要在无数可能的答案中做出取舍,而这个选择过程本身就隐含了价值倾向。这提醒我们:所谓「中立的AI」,在涉及社会、政治、伦理议题时,几乎不可能做到真正意义上的中立。
用户应保持的批判意识
对于普通用户而言,这类内容最重要的启示是:AI的回答值得参考,但不应被奉为权威结论,在涉及价值判断的领域尤其如此。健康的使用心态,是把AI视为「信息整合与观点激发的工具」,而非「真相的宣告者」。
每当看到「某AI说出惊人观点」的截图,更值得追问的是:完整的提问是什么?对话上下文如何?这个答案是否只是训练数据中某种主流叙事的复述?
结语
「Claude评判人类最大骗局」这类帖子,本质上是一面镜子——照出的不是AI的独立思想,而是人类社会自身的批判性讨论,以及我们对这项技术的期待与误解。随着生成式AI日益渗透日常生活,理解它「如何生成观点」,远比追逐它「说了什么惊人之语」更有价值。真正值得警惕的骗局,或许恰恰是把AI的文本预测,误认为某种超越人类的智慧裁决。
核心要点
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。