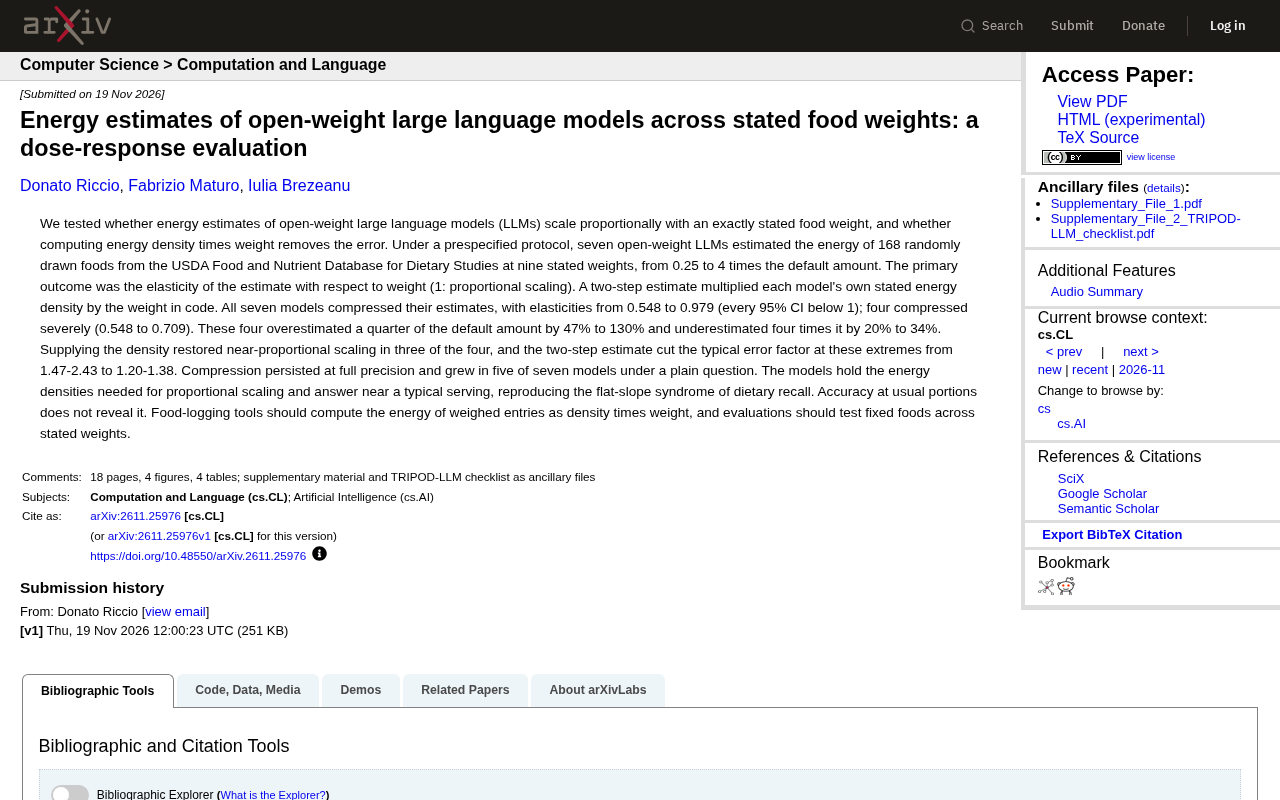
当食物重量翻倍,AI的卡路里估算为何不跟着涨?

七个开放权重LLM的热量估算对重量弹性全低于1,存在系统性的向典型份量收缩偏差。
研究团队从USDA数据库抽取168种食物,让七个开放权重LLM在0.25倍到4倍共九个重量档位上估算能量,并以「估算值对重量的弹性」为核心指标。结果显示所有模型的弹性均低于1(0.548–0.979),四个模型压缩严重,在0.25倍份量时高估47%–130%、4倍份量时低估20%–34%,复现了膳食调查中的平斜率综合征。关键发现是:模型内部掌握正确的能量密度知识,改用「密度×重量」两步计算后误差显著收窄,说明问题出在直接回答时激活了典型份量模板而非执行乘法。作者据此建议食物记录工具将缩放交给确定性代码,并呼吁评测应遍历多个重量、检验弹性而非单点准确率。
一个看似简单的问题:重量变了,热量估算会等比例变化吗?
如果你用过任何一款AI食物记录工具,大概都经历过这样的场景:输入「鸡胸肉 100克」,AI给出一个估算热量;把重量改成「鸡胸肉 200克」,你理所当然地期待数字翻倍。但一篇针对开放权重大语言模型的研究给出了令人意外的答案——大多数模型并不会等比例放大。
研究团队设计了一个预设协议下的剂量-反应实验:从USDA膳食研究食品与营养素数据库中随机抽取168种食物,让七个开放权重LLM在从默认份量0.25倍到4倍共九个重量档位上分别估算能量。核心指标是「估算值对重量的弹性」——如果模型完全按比例缩放,弹性应等于1。
结果:七个模型的弹性全部低于1,区间为0.548到0.979,所有95%置信区间都不包含1。其中四个模型的压缩尤其严重,弹性落在0.548到0.709之间。换句话说,重量翻四倍时,它们给出的热量远不到四倍。
弹性(elasticity) 原本是经济学概念,衡量一个变量对另一个变量变化的敏感程度,定义为两个变量变化百分比之比。在本研究中,弹性被定义为:重量每增加1%,模型估算的热量增加百分之几。若模型完全按比例缩放,则重量增加100%时热量也应增加100%,弹性恰为1;弹性小于1表示估算值随重量增长的速度跟不上重量本身,即存在「压缩」或「收缩」。用对数回归估计弹性是标准做法:对重量和估算热量分别取自然对数后做线性回归,斜率即为弹性估计值,配合95%置信区间可判断其是否显著偏离1。这一指标的优势在于它刻画的是整体缩放行为,而非某个单点的准确率,因此能暴露单点测试无法发现的系统性偏差。
压缩有多严重:47%到130%的双向误差
弹性低于1意味着什么?具体来看,那四个压缩严重的模型在0.25倍默认份量时,把热量高估了47%到130%;在4倍份量时,则低估了20%到34%。这是一个典型的「向中间收缩」模式:模型倾向于把估算值拉向某个典型份量附近的数值,不论你实际输入的是多少。
有意思的是,作者指出这恰好复现了膳食回忆调查中的「平斜率综合征」(flat-slope syndrome)——人类在接受食物频率问卷时,也倾向于低报大份量、高报小份量。LLM在这里表现出的偏差,与人类认知偏差高度同构。
更值得警惕的是,这种偏差在常规份量下几乎看不出来。如果你只测100克、150克这类常见重量,模型的表现可能相当准确。准确率在典型份量处的「正常」,掩盖了它在极端份量上的系统性失真。
平斜率综合征(flat-slope syndrome) 是营养流行病学中的一个经典现象,最早在膳食回忆与食物频率问卷研究中被系统描述。当受访者被要求估计自己摄入的食物份量时,其报告值与真实值之间的关系往往呈现「斜率小于1」的模式:真实份量越大,受访者越倾向于低报;真实份量越小,则越倾向于高报。结果是报告份量向某个「典型份量」收缩,剂量-反应曲线变得平坦。其成因通常被归为认知启发式——人们倾向于用记忆中常见的份量模板替代实际的精确计量。本研究之所以将LLM的行为与之类比,是因为两者在误差方向和幅度上高度同构,暗示LLM可能复用了训练语料中人类饮食报告所携带的同类偏差模式,而非执行独立的数值推理。
模型明明知道密度,为什么不用?
研究中最有洞察力的发现,是关于「模型是否具备正确知识」的检验。
作者做了一个两步估算:先用代码取出每个模型自己声明的能量密度(每克多少千卡),再乘以重量。结果显示,在四个严重压缩的模型中,有三个在改用「密度×重量」后恢复了接近等比例的缩放。两步法把极端份量下的典型误差因子从1.47–2.43压低到1.20–1.38。
这说明什么?模型内部持有做等比例缩放所需的能量密度知识,只是在直接回答时没有调用它。 当问题以「给定重量,估算热量」的形式呈现时,模型似乎激活了一个围绕典型份量的「记忆模板」,而不是执行乘法。
作者还检验了提问方式的影响:在「全精度」设定下压缩依然存在;换成更直白的问法后,七个模型中有五个的压缩程度反而加重。可见问题不在于数值精度或措辞委婉,而在于模型回答此类问题的内部机制。
开放权重模型(open-weight model) 指模型参数权重公开可下载、可在本地或私有环境部署的大语言模型,与只能通过API调用、权重不公开的闭源模型(如GPT-4、Claude等)相对。开放权重模型的好处是可复现、可审计,研究者能直接检查模型输出、控制温度等采样参数,并在完全相同的条件下横向比较多个模型。本研究的七个模型即属此类,这保证了实验协议的可重复性。但需注意,开放权重模型的结论不能自动外推到闭源模型——后者可能经过不同的对齐与后训练流程,行为模式或有差异。因此该研究在讨论外推性时保持了谨慎,将其视为对「LLM比例推理」这一普遍问题的初步证据,而非覆盖所有模型的定论。
对食物记录工具的直接影响
这项研究对产品设计给出了明确的工程建议:食物记录工具在处理称重条目时,应当用「密度×重量」来计算热量,而不是让模型直接输出该重量的总热量。
这个改动成本很低,却能消除大部分极端份量下的误差。对于做AI饮食应用、营养助手或健康管理工具的团队,这是一条可以直接落地的规则:把模型的角色限制在「提供密度」或「识别食物」,把缩放交给确定性计算。
从评测角度看,作者也提出了方法论层面的批评:仅在常规份量上测试准确率是不够的。合理的评测应当固定食物、遍历多个声明重量,检验估算值对重量的弹性是否接近1。弹性这个指标比单点准确率更能暴露模型的系统性偏差。
更广的含义:LLM的「比例推理」盲区
抛开食物场景,这项研究触及了一个更普遍的问题:LLM在处理「线性缩放」这类基础数量关系时是否可靠。
本研究采用的是开放权重模型,结论未必能直接外推到所有闭源模型,但「向典型值收缩」的行为模式在大语言模型中并不罕见——它本质上是用训练分布中的常见模式替代了显式的数学运算。当输入落在分布密集区(典型份量),误差被掩盖;当输入偏离(极小或极大份量),误差就暴露出来。
这对所有依赖LLM做定量估算的应用都是提醒:模型「知道」某个参数,不代表它在回答时会正确使用该参数。把关键的算术环节从生成式推理中剥离出来,交给确定性代码,往往是更稳妥的工程选择。
研究的最终建议朴素而有力:评测应当测试固定食物在多个声明重量下的表现——因为准确率在常规份量处,什么也证明不了。
相关推荐
黄仁勋跌落神坛,硅谷加速主义遭遇逆风
《经济学人》文章《黄仁勋跌落神坛对硅谷加速主义者是坏消息》在Hacker News引发174点、372条评论热议。本文解析加速主义押注英伟达的叙事逻辑、评论区路线分歧,以及对AI从业者的现实启示。
NVIDIA发布Alpamayo 2 Edge:2B推理VLA落地DRIVE Thor
NVIDIA发布Alpamayo 2 Edge,一款2B参数级推理视觉-语言-动作模型,可在DRIVE AGX Thor上规划驾驶轨迹并给出解释,像素到轨迹延迟160至190毫秒。本文解析其参数取舍、延迟指标、可解释性价值与量产落地挑战。
接近50磅就送车?YouTube挑战背后的Whatnot营销
解析YouTube热门挑战“接近50磅赢汽车”的玩法设计,探讨其如何为直播平台Whatnot引流,以及重量竞猜类内容为何能吸引观众并实现商业转化。