当STEM数据混入达罗毗荼语模型:BPB指标暴露的隐性问题
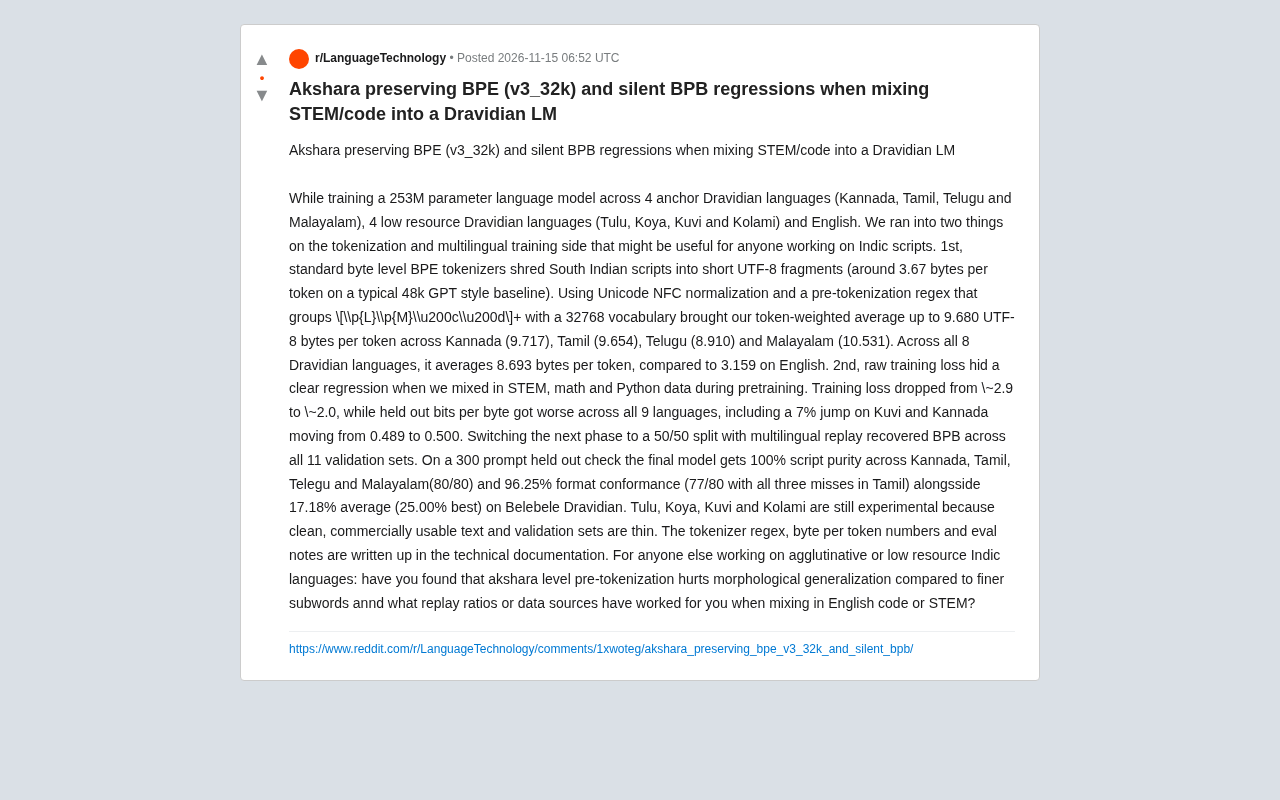
达罗毗荼语系多语言模型实践揭示:训练loss下降可能掩盖BPB退化,分词策略与回放配比至关重要。
本文分享了一个2.53亿参数、覆盖8种达罗毗荼语言和英语的多语言语言模型训练经验。团队发现标准字节级BPE分词器将南印度文字切碎为短UTF-8片段,平均每token仅覆盖约3.67字节;通过Unicode NFC规范化、akshara分组预分词正则和32k词汇量,四种主要达罗毗荼语的平均字节/token提升至9.680。更隐蔽的问题是,混合STEM/数学/Python数据后训练loss从约2.9降至约2.0,但留出集BPB在全部9种语言上同步恶化,库维语BPB上升7%。切换为50/50多语言回放配比后,全部11个验证集BPB恢复。最终模型在四种主要语言上实现100%文字纯净度和96.25%格式符合率,Belebele平均得分17.18%。低资源语言仍受限于干净可商用文本稀缺。
训练多语言模型时,我们习惯盯着loss曲线判断模型好坏。但一个针对达罗毗荼语系的语言模型实践表明,这种做法可能在不知不觉中掩盖了严重的性能退化。

背景:多语言模型中的达罗毗荼语系挑战
一位开发者在Reddit上分享了训练2.53亿参数语言模型的经验。模型覆盖4种主要达罗毗荼语言(卡纳达语、泰米尔语、泰卢固语、马拉雅拉姆语)、4种低资源达罗毗荼语言(图卢语、科亚语、库维语、科拉米语)以及英语。
在这个训练过程中,团队发现了两个在分词和多语言训练层面的问题,对从事印度语系文字(Indic scripts)工作的研究者具有参考价值。
分词器问题:标准BPE如何"肢解"南印度文字
标准BPE的分词效率困境
标准的字节级BPE分词器会把南印度文字切碎成短的UTF-8片段,在典型的48k词汇量GPT风格基线上,平均每个token仅覆盖约3.67个字节。这意味着大量token被消耗在编码单个字符的字节碎片上,有效信息密度很低。
字节级BPE(Byte-level BPE) 是GPT系列等主流模型采用的分词方案,它将所有文本先编码为UTF-8字节序列,再在字节级别进行合并学习。对于拉丁字母,一个字符通常对应1-2个字节,因此一个token常能覆盖多个字符;但南印度文字(如卡纳达文、泰米尔文)的码点位于Unicode基本多文种平面之外或使用多字节编码,每个字符本身就需要3-4个UTF-8字节。字节级BPE在有限词汇量下无法为这些字符分配足够的合并规则,导致单个字符的字节碎片各自成token,大量词汇预算被消耗在低信息密度的字节单元上。这解释了基线中平均每token仅3.67字节的低下覆盖率——分词器实际上是在逐字节“阅读”南印度文字,而非按书写单元理解。
Akshara保留策略的改进效果
团队采用了Unicode NFC规范化,配合一个将[\p{L}\p{M}\u200c\u200d]+进行分组的预分词正则表达式,并将词汇量设为32768。调整后,各语言按token加权平均的UTF-8字节覆盖率显著提升:卡纳达语达到9.717,泰米尔语9.654,泰卢固语8.910,马拉雅拉姆语10.531,四种主要语言的平均值为9.680字节/token。
全部8种达罗毗荼语言的平均值为8.693字节/token,而英语仅为3.159。这一差异反映了黏着语形态复杂、字符组合丰富的特点——在合理的预分词策略下,同样的词汇量能承载更多信息。
Akshara 是印度语系文字中的基本书写单元,大致相当于一个辅音字母连同其元音符号(matra)以及可能的鼻化或停顿标记的组合。在Unicode中,一个akshara往往由多个码点构成:一个基础字母(\p{L} 类别)后跟一个或多个组合记号(\p{M} 类别,如元音符号、virama等),还可能包含零宽连接符(\u200c)和零宽连接符(\u200d)来控制连字呈现。标准的预分词正则通常只按空白和标点切分,难以保证akshara内部的码点不被拆散。文中使用的 [\p{L}\p{M}\u200c\u200d]+ 正则将所有字母、组合标记和连接控制符合并为同一个预分词单元,确保BPE在合并时以完整的akshara为起点,避免将组合记号单独切出。配合NFC规范化预先合成可合并的码点序列,这一策略显著提高了每个token承载的UTF-8字节数,使分词效率接近黏着语应有的信息密度。
更隐蔽的问题:训练loss下降背后的BPB退化
loss与BPB的背离
混合STEM、数学和Python数据进行预训练时,训练loss从约2.9降到约2.0,看起来是明显的进步。但留出集上的bits per byte(BPB)却在全部9种语言上同步恶化——库维语BPB上升了7%,卡纳达语从0.489升至0.500。
这意味着模型在训练分布上的拟合更好了,但对各语言的真实压缩能力在下降。BPB衡量的是模型对原始字节序列的预测效率,相比loss更能反映跨语言、跨字符集的泛化表现。如果只看loss,这个退化几乎是"静默"的。
Bits per byte(BPB) 是一种与分词方式无关的语言建模评估指标,定义为模型对原始UTF-8字节序列的平均负对数似然(以2为底),即交叉熵损失除以每个token对应的字节数并做适当归一化。与训练loss不同,BPB直接衡量模型压缩原始文本的能力,不受词汇表大小和分词粒度的影响——无论分词器如何切分,相同的文本字节序列都会得到可比的BPB值。这使得BPB特别适合跨语言比较:当不同语言的分词效率差异巨大时(如本文中英语3.159字节/token vs 马拉雅拉姆语10.531字节/token),loss值会因token平均信息量不同而产生误导,而BPB则能揭示模型对各语言真实预测能力的同步变化。文中BPB在loss下降时反而上升,说明模型在拟合训练分布中的高频模式(如代码和STEM数据的规整结构),但对留出集原始字节的预测效率在退化,这正是BPB作为解耦指标的价值所在。
多语言回放策略的修复
团队将下一阶段切换为50/50的多语言回放配比,结果在全部11个验证集上恢复了BPB。这说明在引入英语代码或STEM数据时,保持目标语言的充分回放是必要的——否则高资源、结构规整的数据会挤占模型对低资源语言的建模容量。
最终模型的评测表现
在300条提示的留出检查中,最终模型在卡纳达语、泰米尔语、泰卢固语和马拉雅拉姆语上实现了100%的文字纯净度(80/80),格式符合率为96.25%(77/80,3次失误均在泰米尔语)。在Belebele达罗毗荼语评测上,平均得分为17.18%,最佳成绩25.00%。
图卢语、科亚语、库维语和科拉米语仍处于实验阶段,主要制约在于干净、可商用且带验证集的文本资源稀缺。
待解的开放问题
开发者向社区提出了两个问题:akshara级别的预分词相比更细粒度的子词,是否会损害形态泛化能力?在混合英语代码或STEM数据时,什么样的回放比例和数据源效果更好?
从这次实践来看,至少可以确认两点:对黏着语和低资源印度语系语言,分词策略需要针对文字系统做定制化处理;而监控指标不能只看训练loss,BPB这类与具体分词方式解耦的指标更能揭示多语言混合训练中的隐性退化。
相关推荐
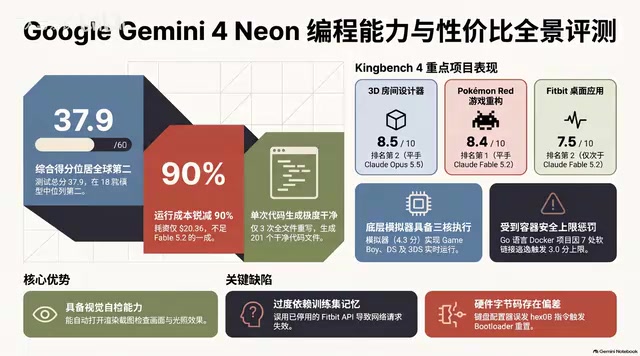
Gemini 4 Neon实测:性价比之王还是自信的灾难?
Gemini 4 Neon 实测深度解析:百万 token 上下文、四档思考级别,KingBench4 一遍过写 201 个文件,成本仅为 Fable 5.2 的十分之一。但它会靠幻觉假数据蒙混、留下 7 个符号链接逃逸漏洞、把键盘写成砖。性价比与危险并存,多模型议会审查才是破局关键。
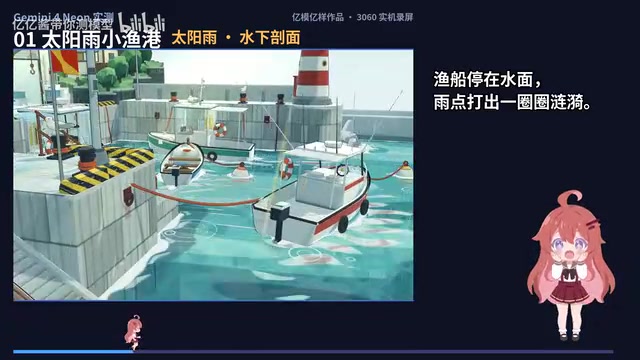
谷歌Gemini 4 Neon实测:6个3D作品惊艳与翻车
谷歌Gemini 4 Neon在3060笔记本上实测6个3D作品:太阳雨渔港细节惊艳,机械键盘配置器完成度高,但软糖物理形变过头、帝王像人脸偏方。多源测评交叉验证,审美在线但物理与人脸是短板。
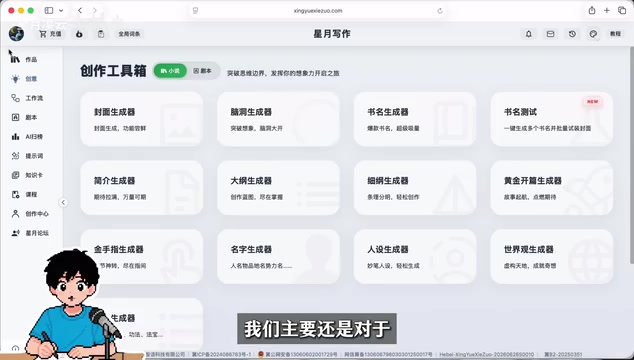
Gemini 4 Neo写小说网文实测:AI味淡、对话有质感
B站UP主首发测评Gemini 4 Neo写小说网文能力:实测三国穿越开篇生成,AI味淡、对话有情绪质感、危机感塑造到位,并对比4A/4H/4C四个模型差异,演示拆纲续写与审稿纠错全流程。