当正常性漂移:WavLM多层级建模如何暴露开放世界音频深伪检测的脆弱性
冻结WavLM做真实语音正常性建模可排序深伪,但域偏移下决策规则崩溃。
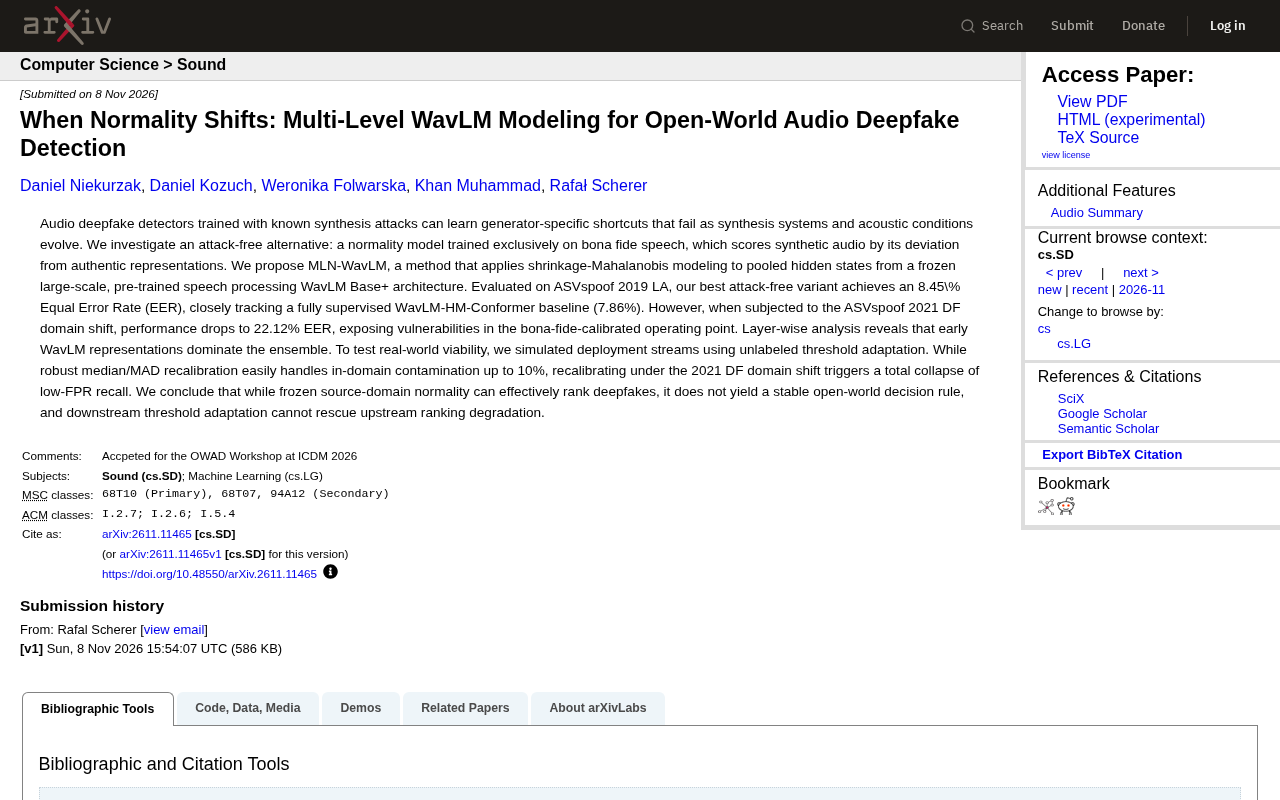
论文提出 MLN-WavLM,用冻结的 WavLM Base+ 池化隐藏状态做 shrinkage-Mahalanobis 单类正常性建模,仅以真实语音训练,不依赖任何合成攻击样本。在 ASVspoof 2019 LA 上最优攻击无关变体取得 8.45% EER,接近监督基线 7.86%,说明真实语音表示分布携带判别信息。但在 2021 DF 域偏移下 EER 升至 22.12%,暴露基于真实语音校准的操作点脆弱性:排序能力尚在,决策阈值失效。层级分析显示早期层主导集成,暗示信号偏局部声学特征。无标签阈值自适应在域内污染 10% 时有效,却在域偏移下低 FPR 召回全面崩溃。结论是冻结源域正常性模型可排序深伪,但无法产出稳定开放世界决策规则,需从表示层面做域适应。
音频深伪检测器正在陷入一种危险的循环:用已知合成攻击训练出来的模型,学到的是生成器特有的捷径,一旦合成系统和声学环境变了,这套捷径就会失效。这篇题为《When Normality Shifts: Multi-Level WavLM Modeling for Open-World Audio Deepfake Detection》的论文,尝试了一条不用攻击样本的路——只训练真实语音的"正常性模型",用偏离真实表示的程度来给合成音频打分。结论并不乐观:排序能力还在,但决策规则在域偏移下崩了。
攻击无关的检测思路:从"识别假"转向"定义真"
传统深伪检测是二分类问题:给模型看过真实语音和各类合成语音,让它学会区分。问题在于,合成技术迭代太快,训练集里的攻击类型很快过时,模型学到的特征往往绑定在特定生成器的伪影上。
论文提出的替代方案是做单类建模:只用 bona fide(真实)语音训练一个正常性模型,推理时计算输入音频与真实表示分布的偏离程度。偏离越大,越可能是合成音频。这种思路理论上不依赖任何特定攻击类型,天然适合开放世界场景。
具体方法叫 MLN-WavLM(Multi-Level Normality WavLM),核心做法是对冻结的 WavLM Base+ 架构输出的池化隐藏状态施加 shrinkage-Mahalanobis 建模。WavLM Base+ 是一个大规模预训练语音处理模型,论文选择冻结它、不微调,只在其表示空间上做统计建模。
域内表现接近监督基线,但域偏移暴露裂痕
在 ASVspoof 2019 LA 数据集上,最优的攻击无关变体取得了 8.45% 的等错误率(EER)。作为参照,完全监督的 WavLM-HM-Conformer 基线是 7.86%。两者差距不大——一个没用过任何攻击样本的模型,能在域内逼近监督模型,说明真实语音的表示分布确实携带了判别信息。
但 ASVspoof 2021 DF 的域偏移测试给出了另一幅图景:EER 掉到 22.12%。论文明确指出,这暴露了基于真实语音校准的操作点在域偏移下的脆弱性。排序能力可能还在,但原本校准好的阈值不再适配新的声学条件。
这里有一个容易被忽略的区分:排序(ranking)和决策(decision)是两件事。模型仍然能把深伪排在真实语音前面,但"排到多高才算假"这条线,在域偏移后站不住了。
等错误率(EER)是说话人验证与深伪检测中的标准指标,指在最优判决阈值下,将真实语音误判为合成(假阳性)与将合成语音误判为真实(假阴性)的错误率相等时的那个错误率值。EER 越低代表系统整体判别力越强,且它天然回避了阈值选择问题,因此常被用于跨系统比较。但 EER 的局限也正在于此:它只衡量排序意义上的可分性,即真实与合成样本的分数分布重叠程度,并不反映部署时在固定操作点(如低假阳性率)下的实际召回表现。这解释了为何论文中域内 EER 尚可、一旦进入域偏移并在低 FPR 操作点评估时性能会急剧恶化——EER 掩盖了分数分布整体平移带来的决策漂移。
ASVspoof 2019 LA 与 2021 DF 是两个广泛使用的音频深伪评测集,但设计目标不同。2019 LA 聚焦逻辑访问(logical access)攻击,即通过文本到语音、语音转换等算法直接生成或篡改语音波形,声学环境相对干净,攻击类型在训练与测试间有明确划分。2021 DF 则转向物理访问(physical access)与真实声学场景,音频经过扬声器重放、房间混响、背景噪声和录音设备失真等信道传递,且测试集中包含大量与训练集分布不同的合成系统。因此从 2019 LA 迁移到 2021 DF,同时叠加了攻击类型变化与声学信道偏移,这正是论文所称域偏移的来源,也是正常性模型校准失效的诱因。
浅层表示主导集成,提示正常性信号偏局部
论文的层级分析给出了一个有意思的发现:WavLM 的早期层表示在集成中占主导地位。这暗示正常性建模捕捉到的判别信号,更多来自低层声学特征而非高层语义抽象。
这个观察和"深层表示更具语义鲁棒性"的常见直觉有出入。对攻击无关检测来说,浅层特征可能更容易受声学条件变化影响,这或许部分解释了为什么 2021 DF 域偏移下性能下滑明显。论文没有展开因果论证,但层级主导性与域偏移脆弱性之间的关联值得后续工作深挖。
WavLM 是基于 HuBERT 架构的语音自监督预训练模型,其 Transformer 编码器各层表示具有不同的抽象层级:浅层更接近原始声学与频谱细节,中间层开始编码音素与韵律信息,深层则趋向语义与说话人相关抽象。论文所谓“层级分析”,即分别取各层池化隐藏状态构建正常性模型,再比较其在集成中的贡献权重。发现早期层主导,意味着判别信息更多位于频谱纹理、相位或噪声底等低层线索上,而非高层语义内容。这类低层线索对录音设备、信道响应与背景噪声高度敏感,因而在跨域时更容易整体漂移,这与高层语义相对稳定的通常认知形成对照。
阈值自适应救不了上游退化
为了测试真实部署可行性,论文模拟了无标签流式场景下的阈值自适应。使用鲁棒的中位数/MAD 重校准后,域内污染达到 10% 时系统仍能正常处理。
但在 2021 DF 域偏移下做重校准,结果却是低 FPR 召回率的全面崩溃。论文的结论很直接:冻结源域正常性模型可以有效排序深伪,但无法产出稳定的开放世界决策规则,下游的阈值自适应也救不了上游的排序退化。
这个结论对工程实践的意义在于:如果打算用单类正常性模型做开放世界检测,只靠部署后的阈值调整是不够的,必须解决表示层面的域适应问题。冻结骨干网络虽然避免了灾难性遗忘和捷径学习,却也失去了对新域声学条件的适应能力。
中位数/MAD 重校准是一种对异常值稳健的阈值估计方法:以分数的中位数作为中心,以中位数绝对偏差(MAD,即各分数与中位数之差的绝对值的中位数)作为离散度尺度,再据此设定判决阈值。相比均值和标准差,MAD 不受少量极端分数的影响,因此在无标签流式场景中,即使混入一定比例(如 10%)的合成音频污染,也能较稳定地估计真实语音的分数分布并调整操作点。但这种方法的前提是分数分佈的形状与相对位置在域偏移下保持可比,仅整体平移或缩放。当新域的声学条件使真实与合成分数的相对排序本身发生变化时,任何基于当前分数分布的重校准都无法恢复已丢失的召回能力,这正是论文所称下游自适应救不了上游退化的统计根源。
开放世界音频深伪检测的未解难题
这篇工作的价值不在于给出一个可部署的方案,而在于把"正常性漂移"这个问题清晰地摆了出来。攻击无关检测在域内足够有竞争力,但开放世界的稳定性远未解决。
从论文结果看,至少有三条线索值得追踪:其一,shrinkage-Mahalanobis 建模对多层表示的加权方式是否可以从早期层主导调整为更鲁棒的组合;其二,冻结骨干与轻量域适应之间能否找到折中;其三,排序与决策的解耦设计——既然排序相对稳定而决策阈值脆弱,是否可以把阈值选择交给一个独立的、对域偏移更鲁棒的模块。
论文本身没有回答这些问题,但它用一组干净的数据对比说明:定义"正常"比识别"异常"更难,因为正常性本身会漂移。
相关推荐

Aircad:浏览器里的专业制图与3D建模新选择
Aircad在Hacker News展示浏览器端专业制图与3D建模能力,探索无需安装的CAD工作流。本文分析其定位、潜在优势与早期项目的不确定性。

AI做新闻,受众为何不买账?
AI正成为信息入口,但受众仍抵触AI生产新闻。本文分析信任赤字根源、信息入口与内容生产的边界,以及对媒体机构AI化的现实启示。

律所如何用AI重塑法律业务?Gilbert + Tobin的实践
澳大利亚律所Gilbert + Tobin合伙人兼CEO Sam Nickless谈律所如何用AI重新思考法律业务模式,从效率工具走向业务逻辑重构,以及CEO层级介入AI战略的意义。