当自己的评测指标失败后,我如何重构一个反诈骗广告检查器

开发者用“模型提议、代码决定”的引用门构建反诈骗工具 Awas,并公开覆盖率门失败后的范围重界定与基准数据。
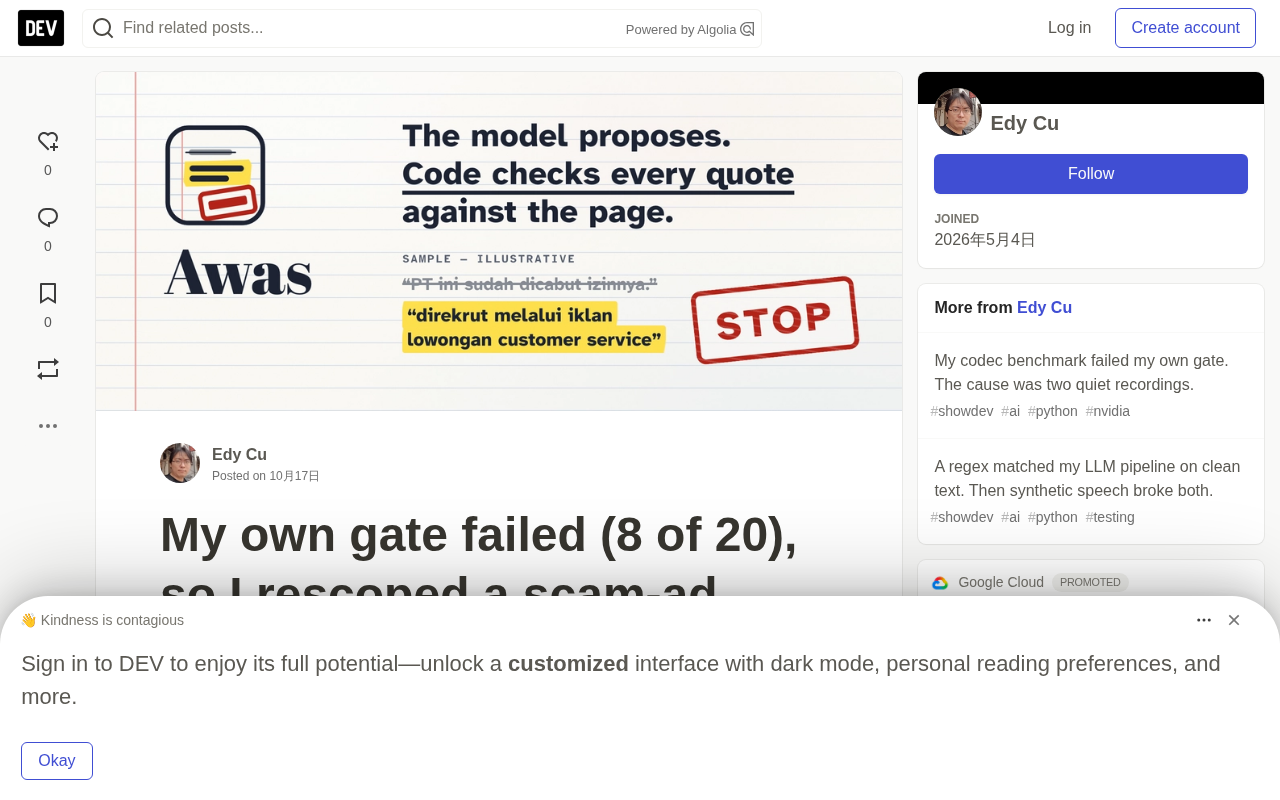
Awas 是开发者为 Nebius 全球 AI 黑客松构建的反海外招聘诈骗原型:用户粘贴广告文本,系统用 Nemotron 模型提取字段、由固定规则产生引用官方页面的红旗,再用纯代码的引用门只保留能在本次抓取页面中逐字匹配的证据行,最终给出 STOP、VERIFY FIRST 或 NO RED FLAGS FOUND 三种结论而不打分。作者在复盘中最强调的是失败:预先设定的覆盖率门只通过 8/20,且报告很少点名招聘者,于是他公开数字并把网络搜索降级为背景信息。留出运行显示 10 个持牌空缺 0 个被误停、25 个诈骗案例中 9 个 STOP,48 条展示证据行全部通过引用门,中位延迟 13.7 秒、中位成本约 0.0078 美元。
一位家人收到 WhatsApp 群里的海外工作邀请:月薪 1500 万印尼盾、旅游签证即可、包机票。要阻止这样的骗局,需要的规则其实存在——柬埔寨不是官方派遣国、旅游签证不是工作许可、合同前收费是警方清单上的警告信号——但它们散落在不同部委、警察和使馆的页面上,群里没人能在一个晚上读完。
开发者 edycutjong 为 Nebius 全球 AI 黑客松构建了 Awas,想用一张张官方页面来回答这条消息,而不是给一个分数。项目上线后,他写了一篇复盘,重点不是成功,而是失败如何改变了产品。
- 在线体验:https://awas.edycu.dev (
/judge页面可打开五个真实运行记录,无需登录) - 代码(MIT 协议):https://github.com/edycutjong/awas
- 演示视频(2 分 37 秒):https://youtu.be/to4VOBm_eNM
它如何工作
用户粘贴广告文本,Awas 返回一份证据文件和三种结论之一:STOP(停止)、VERIFY FIRST(先核实)或 NO RED FLAGS FOUND(未发现红旗,并明确标注“不保证安全”)。没有评分。
流程如下:
- Nemotron 3 Ultra 在 Nebius Token Factory 上从广告中提取结构化字段(公司、目的地、职位、签证、费用)。代码逐一检查每个字段是否字面出现在广告中。
- 固定规则产生红旗,每条规则引用一个官方页面。
- Tavily 搜索同一公司、号码或目的地的已发布页面。
- Nemotron 3 Super 提出证据行:一个 URL、一段引用、一个声明。
- 一个用纯代码编写的引用门只保留那些引用是本次运行中抓取页面文本的逐字子串的行。
- 结论来自规则和已验证的行,不来自模型。
- 生成一条仅基于已验证行的简短印尼语消息,供家人使用。
撞上的墙:我自己的门失败了
在第一次基准运行前,作者在自己的计划里写了一个通过条件(事后只出现在仓库历史中):对于 20 个已知诈骗案例中的至少 12 个,Tavily 必须找到相关的官方警告或新闻条目。这个承诺——“这里有关于这家公司的已发布报告”——是原始推介的核心。
结果只找到了 20 个中的 8 个。(一个 agent 读取了结果,尚未有人工复核。)第二个问题紧随其后:报告几乎从不点名招聘者。在基准的已报告案例中,开发集有 1 个、第一批有 0 个、第二批有 1 个提到了公司名称。因此“公司匹配率”无法测量。
作者有两个选择:保持沉默并保留原来的推介,或者重新界定范围。他选择了重新界定并公布数字。现在结论来自引用官方页面的规则。网络搜索成为给家人的背景信息,永远不是规则的输入。README 和演示页面都写明覆盖率门失败了,以及差多少。
覆盖率门(coverage gate) 是作者在基准运行前预先设定的通过条件:对于 20 个已知诈骗案例,网络搜索至少要为 12 个找到相关的官方警告或新闻报道。这类“预先注册”的通过标准在工程上与统计上的假设检验同源——先写下阈值,再跑数据,避免事后挑选有利结果。它衡量的是检索层能否为规则层提供外部佐证,而不是分类器本身的准确率。覆盖率门失败(8/20)意味着“这家公司有公开报告”这一原始卖点在多数案例上不成立,原因之一是诈骗招聘广告很少点名招聘者,新闻叙事也常以“某公司”泛指。作者的处理方式是重新界定产品范围并公开数字,而非悄悄删除该指标;这种做法在原型研究里比提高分数更有信息量,因为它把“检索增强”从规则输入降级为背景信息,避免了把无法验证的网络结果当作判定依据。
值得复制的部分:引用门
模型提议,代码决定。核心逻辑在 src/lib/gate.ts 中,简化为匹配步骤:
export function gateLine(p: Proposal, corpus: Corpus, ctx: GateContext): EvidenceLine {
  const doc = corpus.get(p.url);
  if (!doc) return dropped(p, "url_not_returned");
  if (words(p.quote).length < MIN_QUOTE_WORDS) return dropped(p, "too_short", doc.purpose);
  const nq = normalise(p.quote);
  // ...
  for (const chunk of doc.chunks) {
    const nc = normaliseWithMap(chunk.text);
    const at = nc.text.indexOf(nq);
    if (at < 0) continue;
    // ... return a "verified" line with the raw quote and its offset
  }
  const joined = normalise(doc.chunks.map((c) => c.text).join(" "));
  return dropped(p, joined.includes(nq) ? "spans_chunks" : "not_in_page", doc.purpose);
}
如果一行引用的内容无法在本次运行返回的页面中逐字找到,该行就会被丢弃,并且丢弃原因会显示在屏幕上。显示的引用可以在不依赖 Awas 代码的情况下重新对照页面检查:在留出运行中,一个脚本重新找到了 48 条中的 33 条;其余的需要浏览器(14 个页面拒绝脚本或是 PDF/JavaScript 页面)或抓取后已变更(1 条)。
引用门(citation gate) 是一种将“事实核验”从生成模型手中收回、交给确定性代码的架构模式。其核心假设是:大语言模型擅长提出候选断言(proposal),但不擅长保证断言的真实性;而字符串匹配、偏移量定位这类操作可以由代码以零幻觉的方式完成。具体做法是维护一份本次运行实际抓取的页面语料(corpus),把模型给出的引用做归一化(统一大小写、空白、标点)后,逐字在对应页面的文本块中查找子串;找不到就丢弃该行并记录丢弃原因。这种模式的代价是召回率下降——改写、同义替换、跨段拼合的合理引用都会被误杀,因此通常需要配合最小引用长度阈值和跨块检测来减少误判。它的价值在于可审计性:屏幕上展示的每一条证据都可以脱离原系统、由第三方脚本重新在原始页面上复现验证,这正是 Awas 能在留出运行中让独立脚本重新找到 48 条中 33 条引用的原因。
留出运行测量了什么
第二批基准在运行前被冻结(文件已哈希),然后在标记为 code-freeze 的代码上作为 Nebius Serverless Job 对生产应用运行了一次。每个数字都在仓库的 DEMO.md 和 bench/ 中。
- 持牌机构的空缺职位被错误停止:10 个中 0 个。
- 25 个公开报道的诈骗招聘案例:9 个 STOP、15 个 VERIFY FIRST、1 个 NO RED FLAGS FOUND。 九个 STOP 中有八个仅来自引用的规则。一个案例只是一个案例,不是比率。
- 展示的 48 条证据行全部通过引用门验证。 54 条提议行中有 6 条被丢弃(11%)。
- p50 13.7 秒,p95 31.7 秒 从请求到完成文件(服务器端);中位成本 0.0078 美元的 Token Factory 令牌加上 1 到 3 个 Tavily 信用点。
- 对 10 个已报告案例的 20 次重跑中,20 次结论相同;对 10 个持牌空缺职位,19 次相同。
文档没告诉我的事
- 结构化输出指南自己的
json_schema示例在 Nemotron 3 Super 和 Lightning 上被拒绝,返回 HTTP 422;API 参考中的name/schema/strict形式则有效。 - Super 是一个推理模型,所以作者给它慷慨的
max_tokens:他早前的一个项目看到它把所有 token 花在思考上并返回空答案(本仓库记录的空答案是 Lightning 的)。 - 印尼语不在任何能读到的模型卡上,所以他做了测量:字段准确率 Ultra 为 84.8%,Super 为 70.7%,Lightning 为 59.6%,对照的是 agent 起草且无人复核的标签。这个警告出现在每个引用这些数字的页面上。
- 对象存储的条件写入(
If-None-Match,重复时返回 412)足以在没有数据库的情况下实现速率限制。
完整列表及每次记录的调用都在 FEEDBACK.md 中。
结构化输出(structured output) 指让模型按给定 JSON Schema 返回字段,而非自由文本,便于下游代码直接解析。各家 API 对 Schema 的支持并不一致:有的要求顶层为 {name, schema, strict} 包装形式,有的直接接受裸 json_schema;不合规的请求常以 HTTP 422 拒绝。本文记录的差异说明,模型卡和指南中的示例未必与线上端点一致,接入时需要以实际 API 参考为准。另一个相关概念是推理模型(reasoning model) 的 token 预算:这类模型会先在内部生成较长的思维链再输出答案,若 max_tokens 设得过小,token 可能全部消耗在思考阶段,最终返回空内容。因此对 Nemotron 3 Super 这类模型应留出充裕的输出上限,并在监控中把“空答案”与“格式错误”区分开,否则容易误判为模型能力问题。
局限
覆盖率门失败,所以网络证据仅作背景。基准的已报告案例是记者对招聘的描述,不是原始广告,因此真实广告可能包含更多红旗措辞。电话号码路径尚未测量。NO RED FLAGS FOUND 永远不是保证,也没有外部用户使用过 Awas。它是一个研究原型,不是法律建议,也不是官方服务。
如果你在群聊中见过海外招聘广告,请粘贴文本(移除电话号码和姓名)到 https://awas.edycu.dev 并告诉作者它哪里出错了。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。